DX · ARQUITECTURA · DOCUMENTACIÓN TÉCNICA DE SOFTWARE
Documenta decisiones, no vuelvas a escribir el código
La documentación técnica de software debería ayudarte a entender por qué un sistema funciona como funciona. Sin embargo, abres el README para entender una integración y te encuentras con una explicación estupenda de tres clases que ya no existen. Miras el historial: el código cambió hace meses. La documentación se quedó donde estaba. Y cuando por fin encuentras a alguien que conoce el proyecto, resulta que lo importante nunca se escribió: por qué se hizo así y qué se rompería si lo cambias.
Me parece una de las situaciones más frustrantes al hacerse cargo de un proyecto. No tanto porque la documentación sea antigua, sino porque te obliga a empezar una investigación antes de atreverte a tocar nada.
Imagínate que acabas de incorporarte al equipo. Buscas la página de «Arquitectura» y el diagrama todavía muestra Redis, aunque ya no se utiliza. En otra página te explican que OrderService llama a InvoiceService. Vale, pero eso ya lo ves al abrir el proyecto.
Y, mientras tanto, nadie te cuenta lo que de verdad necesitas saber.
¿Por qué el módulo de facturación no puede ejecutarse de forma asíncrona? ¿Por qué ese identificador aparentemente redundante sigue guardándose en la base de datos? ¿De dónde salió ese timeout mágico de 17 segundos? ¿Qué incidente provocó que se desactivara cierto reintento? ¿Qué condición tendría que cambiar para replantear una decisión tomada hace tres años?
Ojalá bastara con buscarlo en el repositorio. A veces ni siquiera aparece en los tickets.
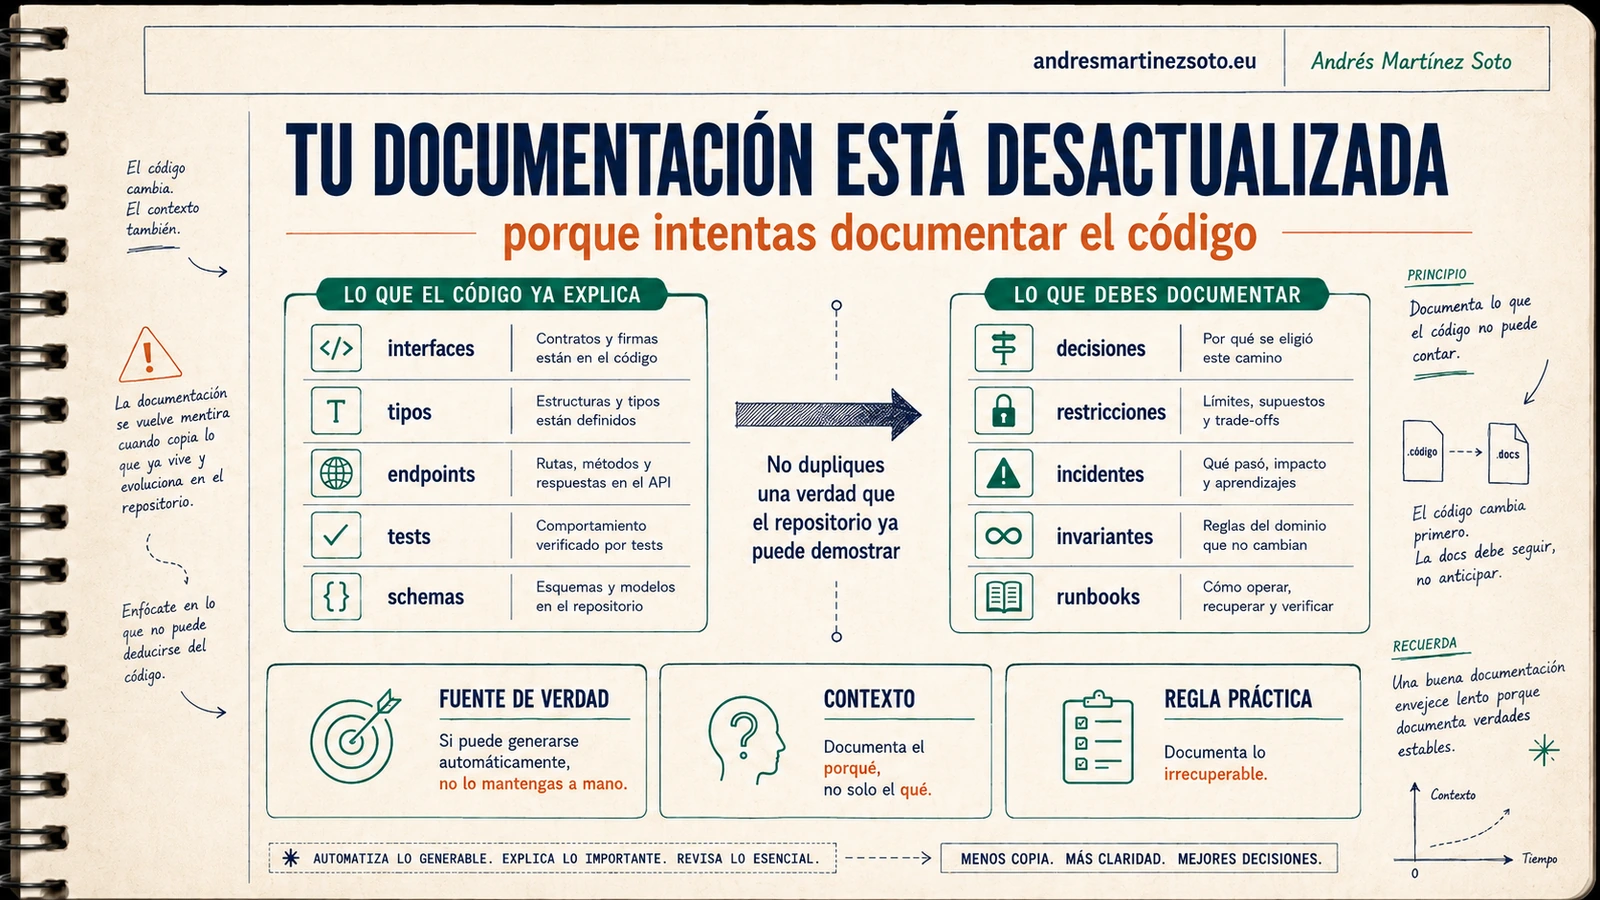
Y ahí está la paradoja de la documentación técnica de software: dedicamos tiempo a copiar lo que el código ya dice bastante bien, pero dejamos sin escribir las razones que explican por qué funciona de esa manera.
TL;DR
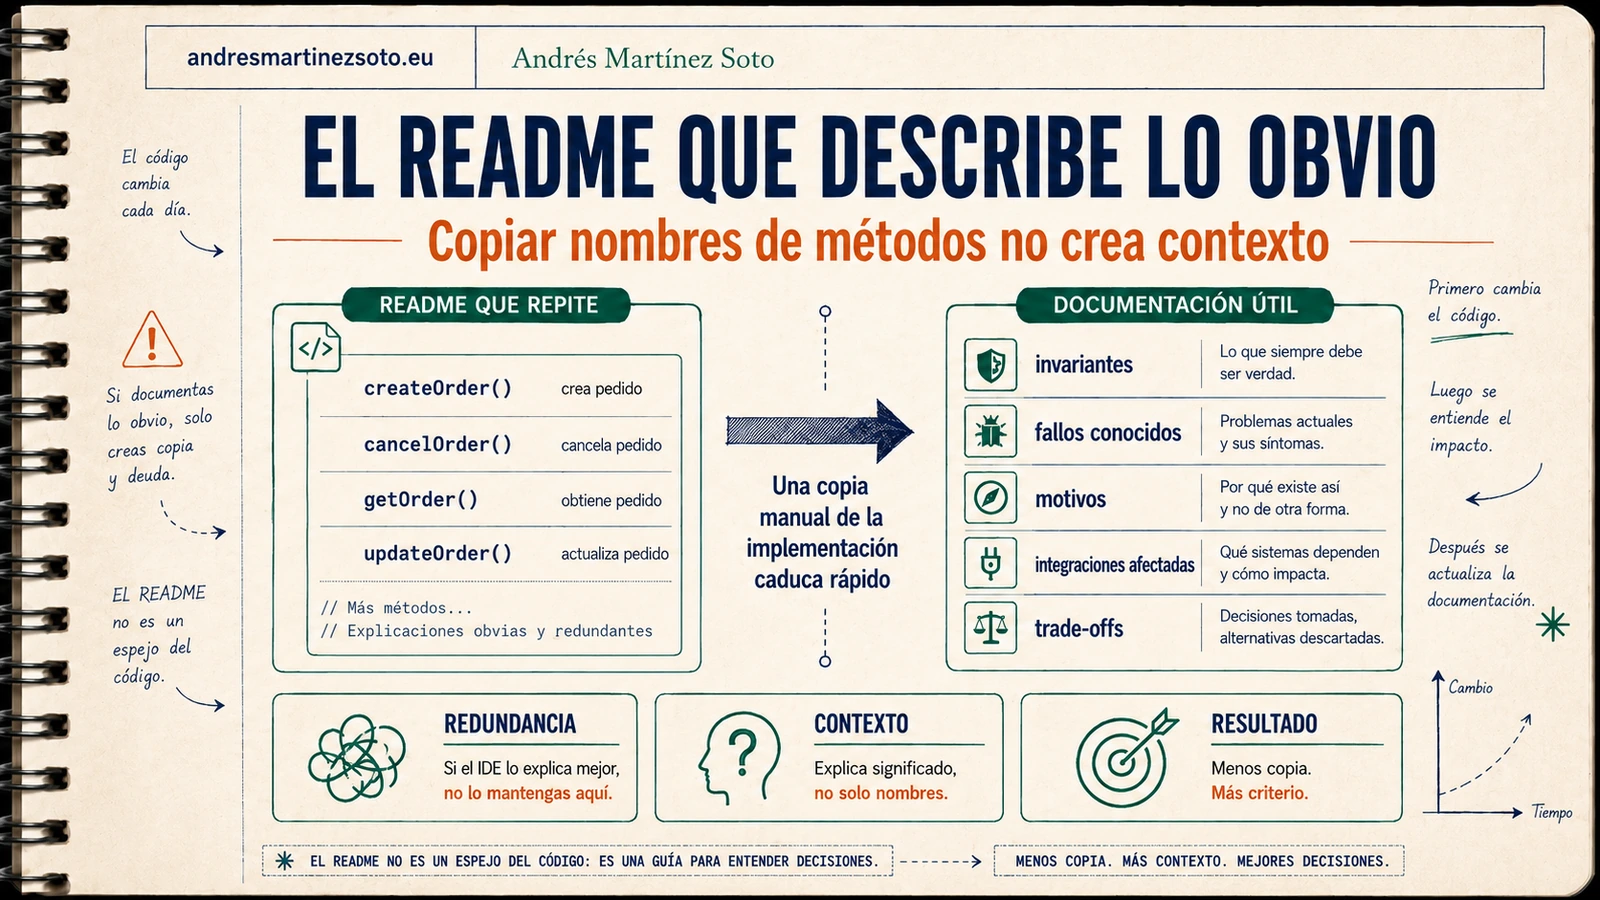
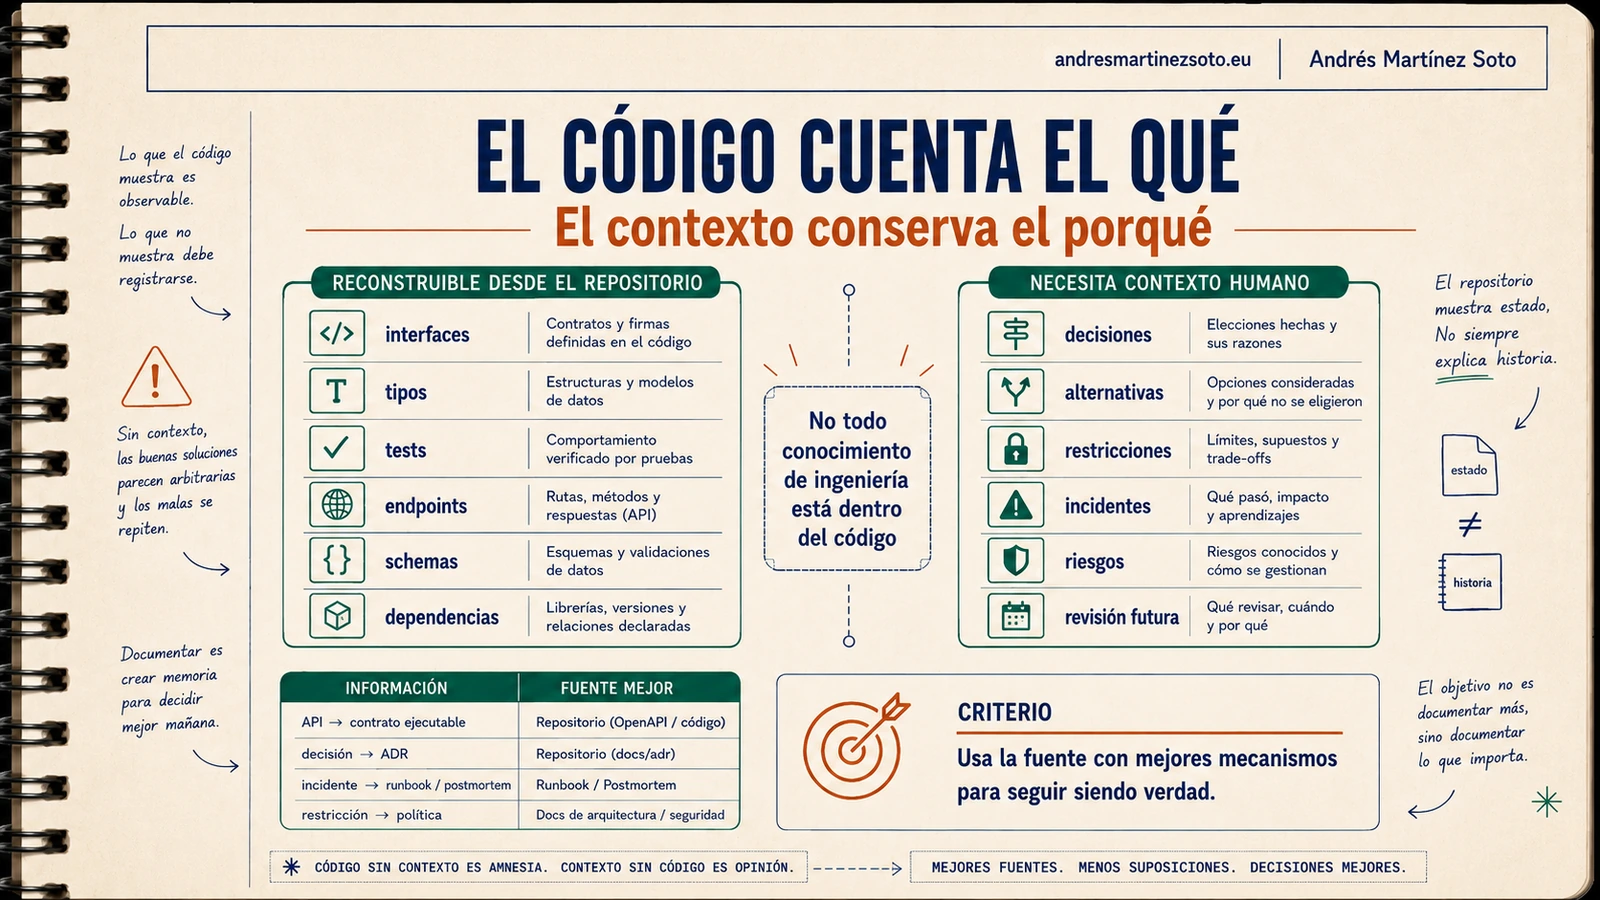
Si la documentación se limita a repetir nombres de clases, métodos o dependencias, es fácil que acabe mintiendo en cuanto el código cambie. Yo invertiría ese esfuerzo en conservar lo difícil de recuperar: decisiones, restricciones, alternativas descartadas, reglas de negocio y procedimientos para resolver incidencias. Para lo demás tenemos el repositorio, los tests, los contratos y, cuando encaja, documentación generada.
Documentación técnica de software: el README que explica lo obvio
Hay documentos que quedan muy bien en una revisión y ayuda poquísimo cuando tienes un problema delante.
Por ejemplo:
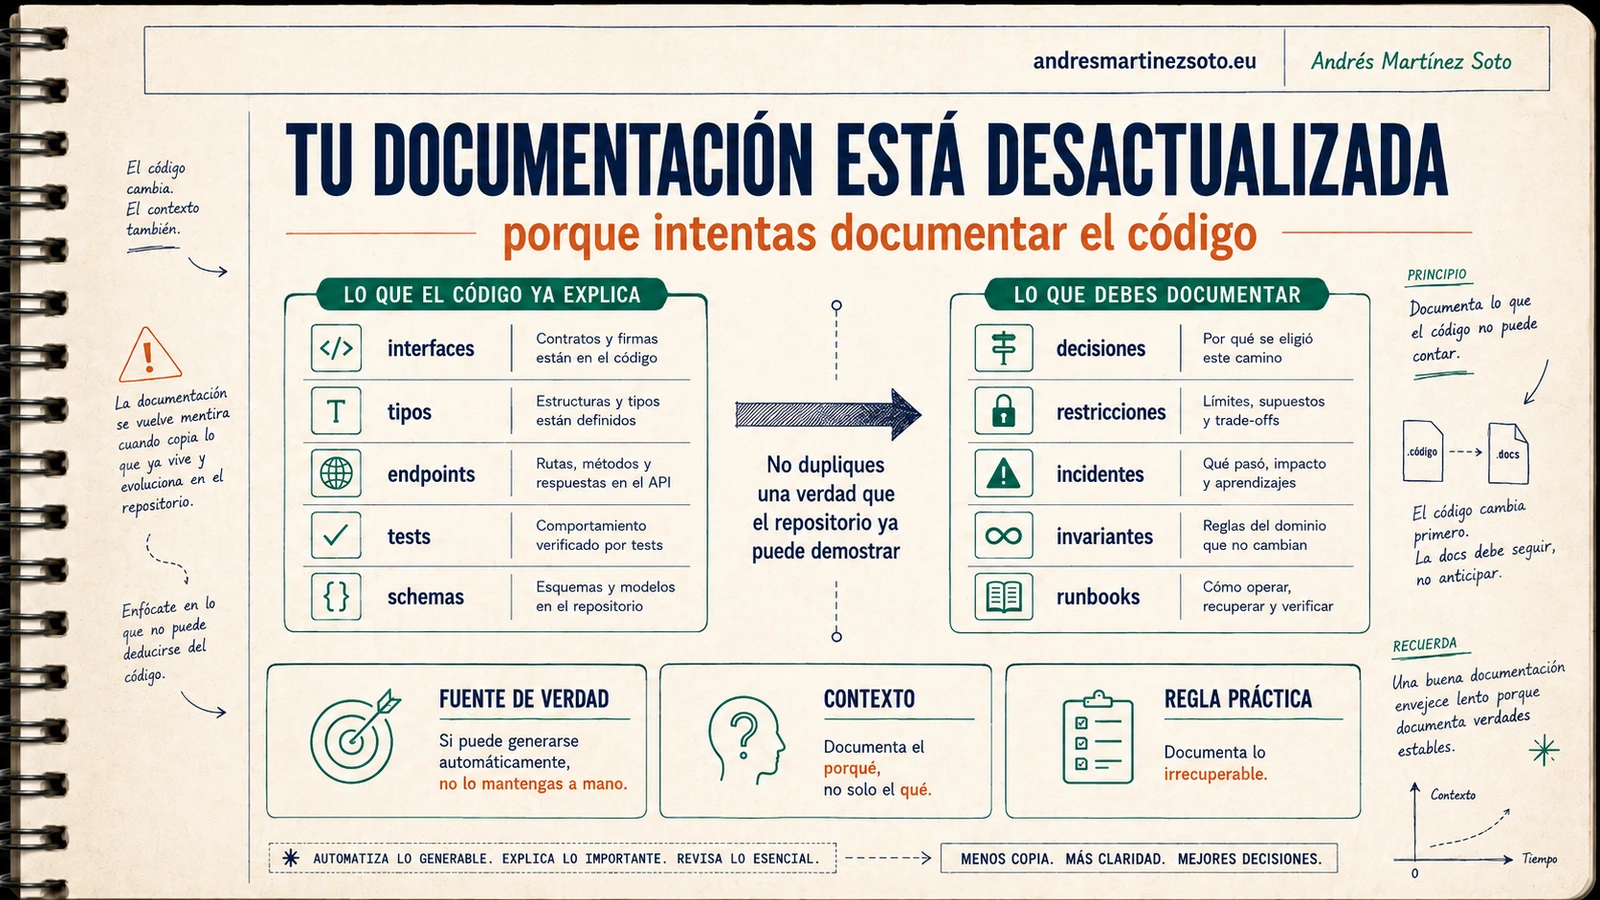
## OrderService

OrderService gestiona pedidos.

- createOrder() crea un pedido.
- cancelOrder() cancela un pedido.
- getOrder() obtiene un pedido.
- updateOrder() actualiza un pedido.
No es falso. Pero, seamos prácticos: ¿te ha ayudado a entender algo que no supieras ya?
La interfaz, los nombres de los métodos, los tipos y los tests probablemente ya explican eso con mucha más precisión. Si mañana cancelOrder() pasa a llamarse requestCancellation() porque cancelar deja de ser inmediato, ahora tienes dos fuentes de verdad que mantener. El código cambiará porque el compilador o los tests te obligarán. El README, en cambio, puede quedarse quieto y polvoriento durante años.
El problema no es el Markdown ni la buena intención de quien lo escribió. Es tener dos sitios contando lo mismo y confiar en que alguien se acuerde de actualizar los dos.
La documentación útil de ese mismo componente debería responder a preguntas de un calibre muy distinto:
- qué significa realmente «cancelar» en términos de negocio;
- qué estados del pedido permiten solicitar una cancelación;
- por qué ciertas cancelaciones requieren una compensación y no un simple rollback;
- qué sistemas externos deben ser notificados de este cambio;
- qué invariantes del sistema no deben romperse bajo ningún concepto;
- qué ocurre si uno de los consumidores está caído en ese momento.
Eso sí ayuda. Sobre todo el día en que alguien proponga «simplificar» una parte del sistema sin conocer todas sus consecuencias. Ya comenté algo parecido al hablar de cómo priorizar la deuda técnica sin reescribir por inercia.
Prueba rápida
Si una página puede regenerarse de forma fiable leyendo interfaces, tipos, OpenAPI, tests o dependencias, probablemente no debería mantenerse a mano como una segunda fuente de verdad.
Qué puede obtenerse del código para una documentación técnica de software útil
No estoy diciendo que el código se explique siempre por sí solo. Hay repositorios difíciles de leer, nombres poco claros y reglas escondidas en sitios inesperados. Pero, para muchas preguntas sobre cómo está construido algo, el código sigue siendo el primer sitio al que mirar.
Un repositorio bien estructurado puede revelar con bastante precisión:
- firma y contratos de tipos;
- interfaces públicas;
- dependencias entre módulos;
- validaciones explícitas;
- algoritmos y reglas de negocio codificadas;
- rutas y endpoints;
- esquemas declarativos;
- casos cubiertos por tests;
- configuración versionada.
También hay información que conviene generar automáticamente: referencia de API desde OpenAPI, tablas de configuración desde schemas, diagramas de dependencias (cuando sean fiables) o documentación de CLI desde la propia definición de comandos.
No se trata de tener una documentación técnica de software más moderna o más bonita. Se trata de no mantener la misma información por duplicado.
Si una API cambia, la especificación que alimenta al servidor o al cliente puede actualizarse en el mismo commit. Una wiki que describe esa API, en cambio, depende de la disciplina humana adicional, que suele ser el eslabón más débil.
| Información | Fuente preferente | Motivo |
|---|---|---|
| Firma de una función | código / tipos | es la implementación vigente |
| Endpoints y payloads | OpenAPI o contrato ejecutable | puede validarse automáticamente |
| Ejemplos de comportamiento | tests / ejemplos ejecutables | fallan cuando dejan de ser ciertos |
| Dependencias | build / package metadata | se actualizan con el sistema |
| Decisión arquitectónica | ADR | el código muestra el resultado, no la motivación |
| Procedimiento de incidente | runbook | necesita pasos operativos y criterio humano |
| Invariante de negocio | test + documentación de intención | el test protege; el texto explica por qué importa |
El criterio no es «texto frente a código»
Antes de escribir otra página, preguntémonos algo más sencillo: ¿dónde podemos comprobar que esto sigue siendo cierto? Si se puede verificar automáticamente, mejor apoyarse en esa fuente que volver a explicarlo a mano.
Lo que la documentación técnica de software debe conservar
El repositorio puede enseñarte una condición rarísima. Y aun así dejarte sin respuesta a la pregunta importante: ¿qué pasó para que alguien tuviera que añadirla?
Imagina que te encuentras con esta línea:
if customer.country == "PT" and contract.created_at < DATE_2019:
    timeout = 17
Puedes seguir las llamadas, revisar los commits y buscar en los tickets. Quizá logres reconstruir la historia. O quizá el motivo real se perdió para siempre en un hilo de Slack, una llamada urgente con un proveedor y la cabeza de alguien que ya no trabaja en el equipo.
La información más valiosa suele estar alrededor del código:
- qué problema concreto se intentaba resolver;
- qué alternativas se evaluaron y por qué se descartaron;
- qué restricción impidió una solución más limpia o elegante;
- qué incidente cambió el diseño original;
- qué riesgo se aceptó conscientemente;
- qué condición haría razonable revisar esta decisión en el futuro;
- quién o qué sistema depende de una rareza aparentemente innecesaria.
Lo complicado es que ese contexto no siempre puede deducirse del código que tenemos hoy. Y cuanto más antiguo es el proyecto, más fácil resulta que se haya perdido. Por eso, al modernizar software legacy sin detener el negocio, entender estas dependencias es tan importante como elegir la tecnología nueva.
Dos proyectos pueden tener exactamente la misma solución y haber llegado a ella por razones distintas. Si desconoces esas razones, es fácil eliminar una aparente complicación y descubrir después que estaba protegiendo un caso real.
ADRs: documentar una decisión, no escribir una novela
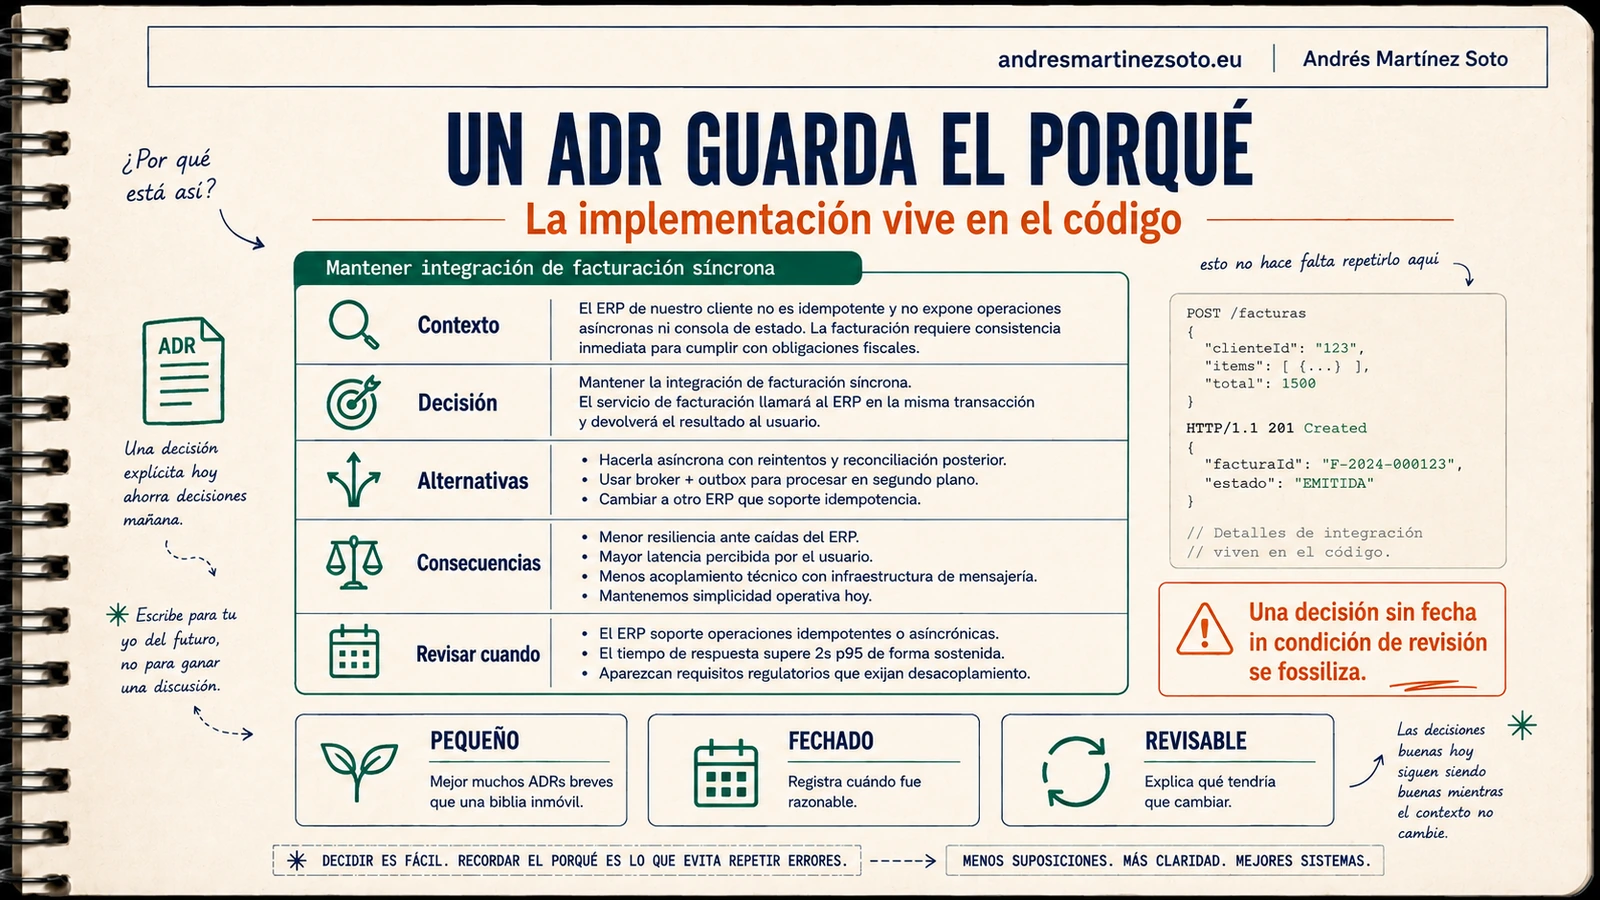
Aquí es donde los Architecture Decision Records (ADR) me parecen especialmente útiles. En lugar de escribir un documento interminable sobre toda la arquitectura, dejas registrada una decisión concreta. Una, no veinte mezcladas.
Michael Nygard popularizó una estructura sencilla: contexto, decisión y consecuencias. Me gusta precisamente por eso. No pide escribir una memoria de veinte páginas; pide explicar lo suficiente para que la siguiente persona no tenga que adivinarlo todo.
Yo le añadiría dos cosas: qué alternativas se descartaron y, sobre todo, qué tendría que cambiar para revisar la decisión. Ese último punto suele olvidarse y, para mí, es de los más útiles.
# ADR-024: Mantener facturación síncrona

## Contexto
El ERP externo no ofrece idempotencia y la confirmación de factura
forma parte del compromiso transaccional actual.

## Decisión
Mantener la llamada síncrona desde checkout.

## Alternativas
- evento asíncrono
- cola con reconciliación
- outbox + consumidor

## Consecuencias
- checkout depende de latencia del ERP
- timeout operativo máximo: 17 s
- hay que monitorizar errores por proveedor

## Revisar cuando
El ERP publique una API idempotente o podamos introducir reconciliación.
Fíjate en lo que no aparece: una explicación línea por línea de BillingClient. Eso ya pertenece al código.
Un ADR tampoco debería convertirse en una ley eterna. Es un registro de por qué una decisión fue razonable bajo unas condiciones concretas. Si las condiciones cambian, la decisión también puede (y debe) cambiar.
Un ADR útil responde a una pregunta futura
«¿Por qué esto está así y qué tendría que cambiar para hacerlo de otra manera?» Si tu documento no responde a eso, probablemente estás documentando implementación, no decisión.
Cómo mantener la documentación técnica de software cerca del cambio
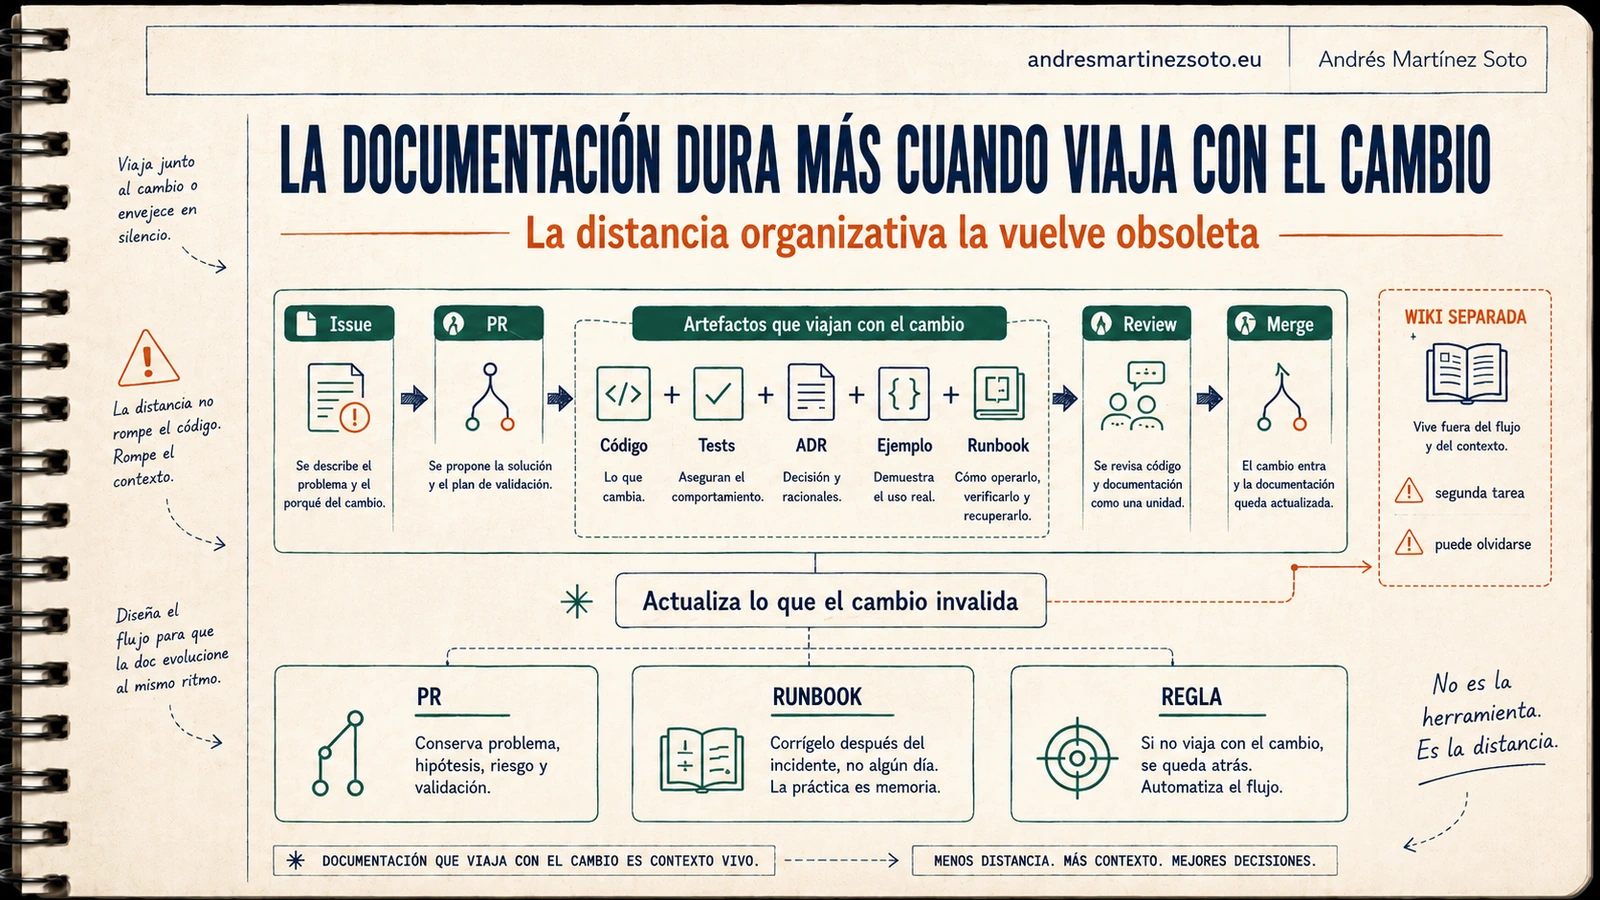
Una buena documentación no depende de elegir entre wiki y repositorio. No tengo nada contra las wikis. El problema aparece cuando el código vive en un sitio y la explicación importante en otro, y nadie conecta ambos cambios.
Se aprueba una pull request, se despliega y todo funciona. Pero nadie actualiza aquella página que se escribió hace dos años. Es comprensible: la documentación no hace fallar el pipeline cuando se queda antigua. El problema aparece meses después, cuando alguien confía en ella.
El enfoque Docs as Code intenta acercar ambas cosas: documentación versionada, revisada y modificada con herramientas similares a las del código. Write the Docs resume este enfoque alrededor del control de versiones, texto plano, revisión y automatización.
Pero incluso dentro del propio repositorio, conviene ser estratégico sobre dónde vive cada pieza de conocimiento.
| Necesidad | Artefacto útil | Por qué |
|---|---|---|
| Explicar una decisión | ADR | queda versionada y localizada |
| Demostrar una regla | test | detecta regresiones |
| Enseñar uso real | ejemplo ejecutable | comprueba que la API sigue funcionando |
| Operar un servicio | runbook | guía acciones bajo presión |
| Explicar un cambio concreto | PR | conserva problema, hipótesis, riesgo y validación |
| Instruir a agentes/herramientas | AGENTS.md / reglas locales | pone contexto cerca de los archivos afectados |
| Referencia de API | spec generada | reduce divergencia |
Por eso, al revisar una PR, yo cambiaría la pregunta. En lugar del típico «¿has actualizado la documentación?», preguntaría: «¿este cambio deja de hacer cierta alguna explicación, decisión o procedimiento que el equipo necesita?».
Si la respuesta es sí, esa actualización debería formar parte indivisible del cambio.
En operación ocurre lo mismo. Un runbook que se descubre incorrecto durante un incidente debe corregirse como una consecuencia directa de ese incidente, no quedar como una tarea abstracta en el backlog para «algún día».
Documentación técnica de software e IA: la intención importa más
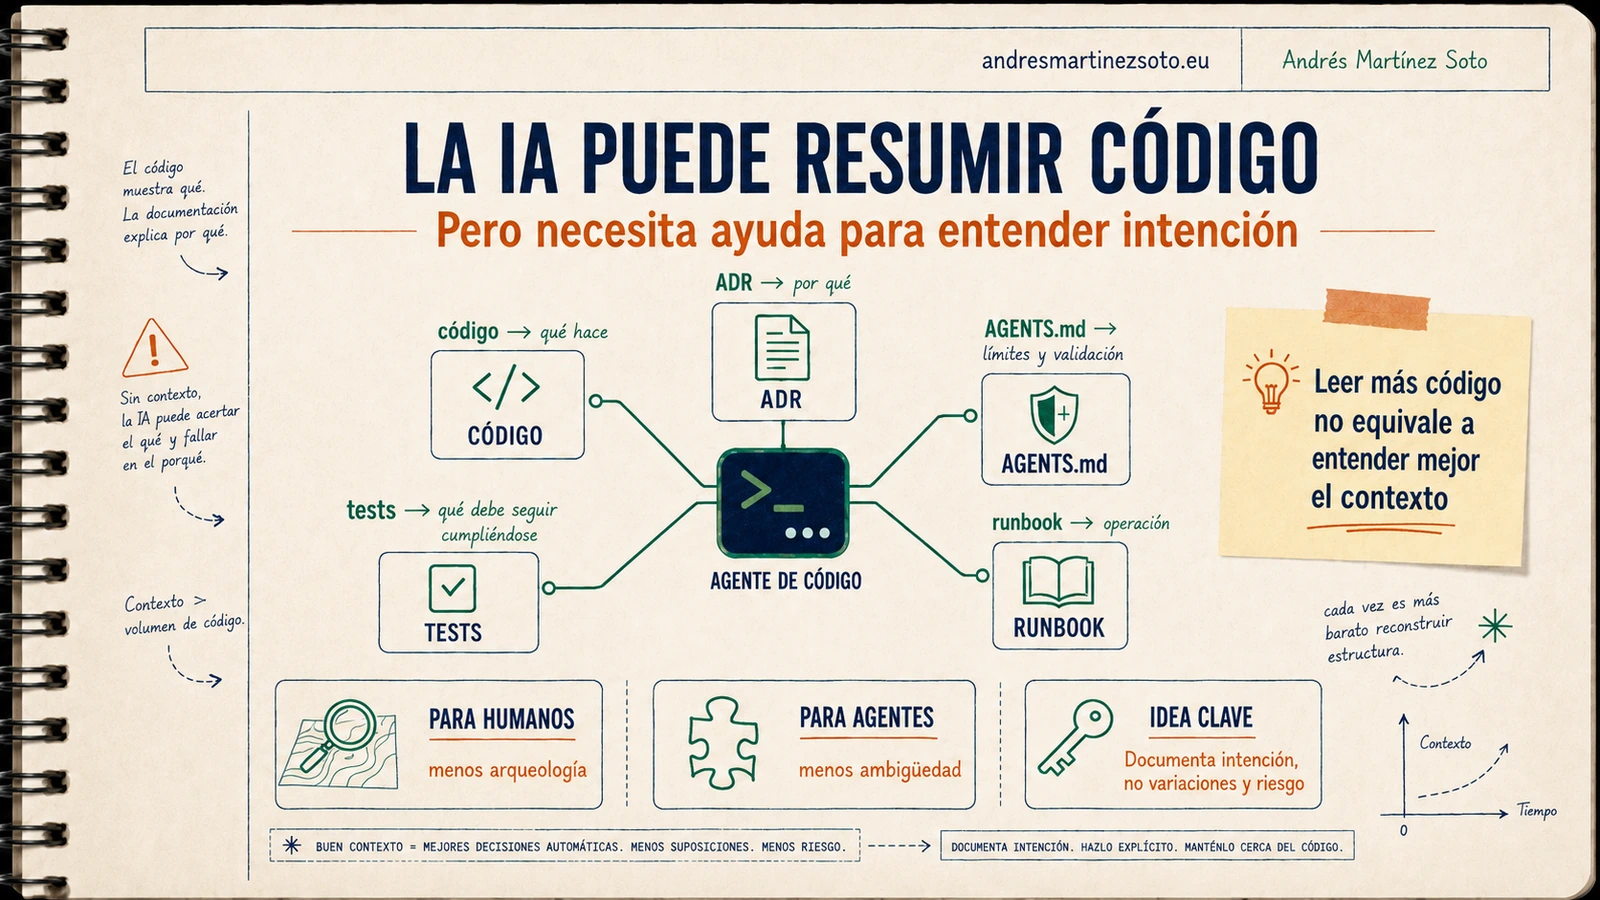
Con los agentes de IA, todo esto se vuelve aún más interesante. Hoy puedes pedirles que recorran un repositorio, te resuman un módulo o encuentren dónde se aplica determinada regla. Es una ayuda enorme, especialmente cuando aterrizas en un proyecto que no conoces.
Eso hace menos necesario redactar a mano algunas explicaciones puramente descriptivas. Aunque tampoco significa que todo lo que te cuente el agente sea correcto: sus conclusiones hay que contrastarlas con el código y las pruebas.
Si una herramienta puede recorrer las clases y dibujar las dependencias reales, quizá no tenga demasiado sentido mantener veinte páginas que repiten esa estructura a mano. Hay usos mejores para ese tiempo.
Pero hay un límite importante: leer más código no convierte automáticamente comportamiento en intención.
Un agente puede descubrir que todos los pagos pasan por una función concreta, pero no tiene forma de saber que esa función existe porque, hace dos años, hubo duplicados de cobro durante una caída parcial del sistema. Puede ver un timeout, pero no sabe si es arbitrario, contractual o consecuencia de un proveedor legacy.
Por eso, archivos de instrucciones locales, ADRs, tests con nombres de dominio y documentación operativa están adquiriendo un segundo lector muy exigente: además del humano, el agente.
OpenAI, por ejemplo, utiliza AGENTS.md como mecanismo de instrucciones con alcance por árbol de directorios en flujos de Codex. La idea interesante aquí no es el nombre del fichero, sino el patrón: poner contexto operativo y convenciones cerca de la zona donde deben aplicarse.
# AGENTS.md

## Invariantes
- Nunca publicar un pedido antes de confirmar su número fiscal.
- Los eventos de facturación deben ser idempotentes.

## Antes de modificar billing/
- Ejecutar tests de contratos.
- Revisar ADR-024.
- No reducir el timeout sin validar el ERP de producción.

## Validación
make test-billing
make contract-tests
Para un agente que va a modificar billing/, esas indicaciones son bastante más útiles que una lista de clases. Y también lo son para la persona que tenga que revisar su trabajo.
La IA cambia la economía de la documentación
Cuanto más fácil resulta consultar y resumir el código, más merece la pena conservar lo que no está escrito en él: intención, restricciones, riesgos y decisiones. La IA puede ayudar a reconstruir pistas, pero no debería inventar certezas donde falta contexto.
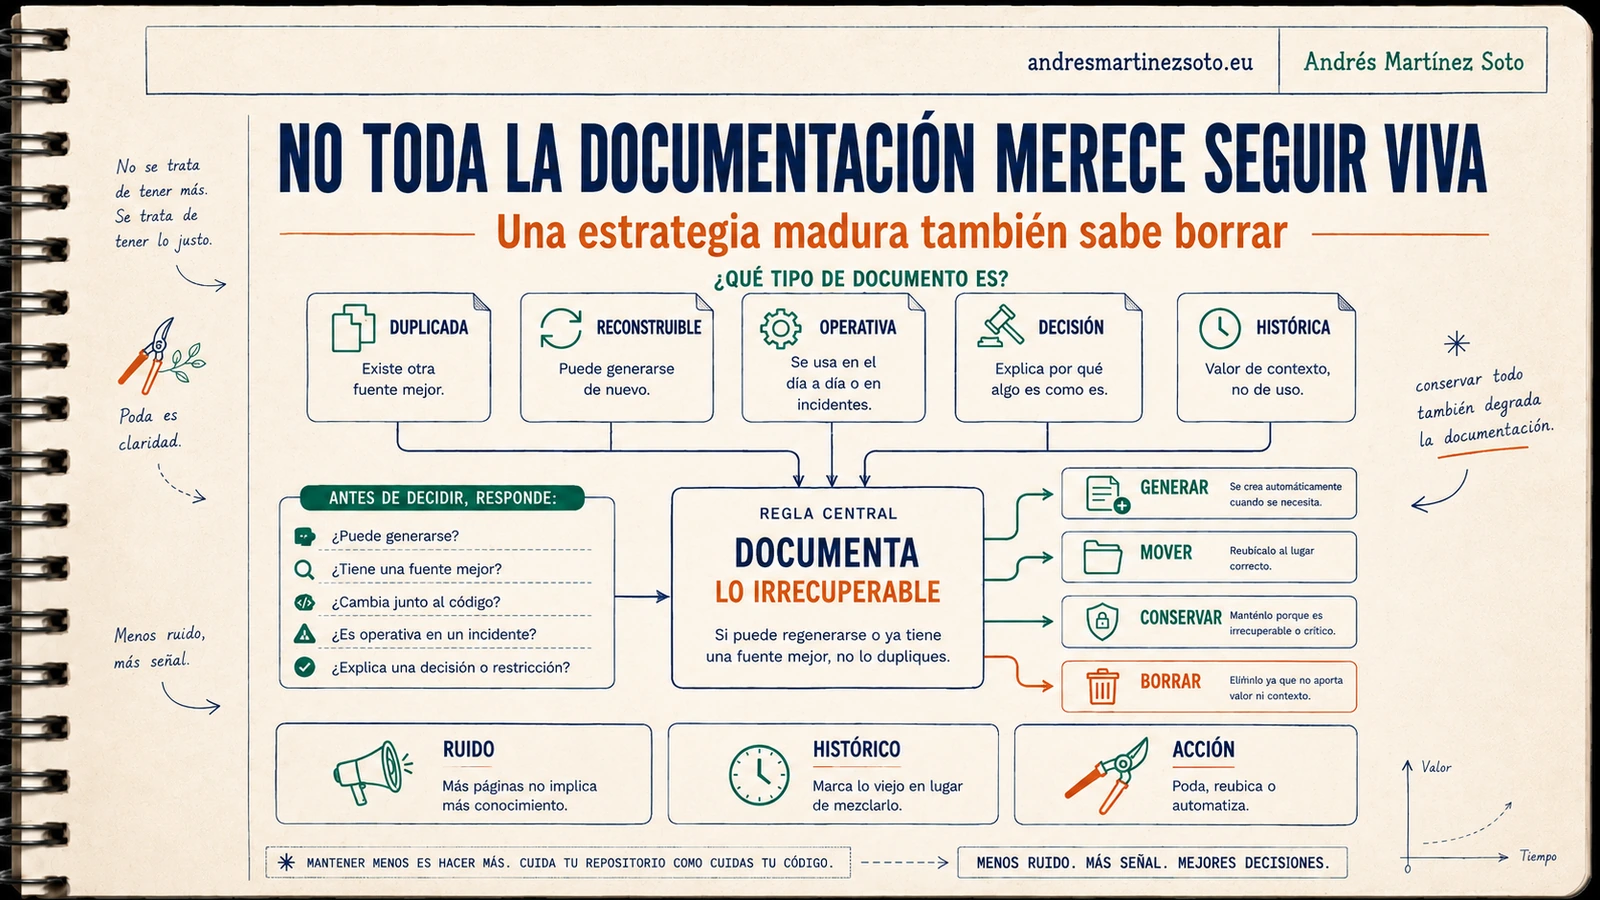
Qué borrar (sí, necesitas una papelera)
Y hay otra cosa que cuesta admitir: parte de nuestra documentación sobra.
Guardarlo todo «por si acaso» parece prudente. Pero cuando buscas una respuesta y aparecen cinco documentos contradictorios, ya no resulta tan buena idea.
Si revisara la documentación de un proyecto, cuestionaría cualquier documento que cumpla alguna de estas condiciones:
- duplica una referencia que ya se genera automáticamente;
- describe clases o métodos que el IDE muestra mejor;
- no tiene propietario ni contexto de vigencia;
- explica una arquitectura anterior sin marcarla claramente como histórica;
- tiene otra página que cuenta lo mismo de forma distinta;
- contiene pasos operativos que nadie ha probado recientemente;
- mezcla decisiones actuales, historia y tutoriales en un único documento enorme e indigerible.
Las opciones no son solo «conservar» o «borrar».
- generar, si la información puede salir de una fuente ejecutable;
- mover, si está demasiado lejos del lugar donde realmente cambia;
- dividir, si mezcla varias responsabilidades en un mismo sitio;
- marcar como histórico, si sirve como registro pero ya no describe el sistema actual;
- eliminar, si no aporta información que no pueda recuperarse mejor desde otra fuente.
El trade-off existe: borrar documentación reduce el ruido, pero también puede borrar contexto útil. Por eso conviene preguntar primero si el contenido es reconstruible y si existe una fuente más autoritativa.
Contraejemplo: a veces sí debes documentar lo que hace el sistema
Hay un matiz que no quiero dejar fuera, porque sería fácil llevar esta idea demasiado lejos.
Hay documentación cuyo lector no puede o no debe leer el código: una API pública, un SDK para terceros, una interfaz regulada, una biblioteca open source, una integración contractual o un producto con soporte externo.
Ahí, la documentación de comportamiento es parte intrínseca del producto.
La diferencia es que no deberíamos mantenerla como una narración manual desconectada del sistema si podemos evitarlo. Podemos generar referencia desde contratos, ejecutar ejemplos, validar snippets y tratar la documentación pública como otro artefacto con sus propios tests.
Así que no: no propongo dejar de explicar cómo funciona el software. También debe servir a quienes no pueden consultar el repositorio. Propongo evitar una segunda versión de la verdad que nadie sabe si sigue vigente.
Checklist: ¿merece la pena documentar esto?
| Pregunta | Si la respuesta es sí | Si la respuesta es no |
|---|---|---|
| ¿Puede reconstruirse automáticamente? | generar o enlazar | considerar documentación manual |
| ¿Explica por qué existe algo? | documentar contexto/decisión | quizá el código baste |
| ¿Protege una invariante? | test + intención | evitar texto redundante |
| ¿Se necesita durante un incidente? | runbook probado | no enterrarlo en una wiki general |
| ¿Cambia junto con el código? | ponerlo cerca del PR/repositorio | definir propietario y revisión |
| ¿Tiene fecha o condición de caducidad? | registrarla | añadir trigger de revisión |
| ¿Existe otra fuente mejor? | eliminar duplicación | mantener una única autoridad |
Documentación técnica de software: conserva lo irrecuperable
Volvamos al README con el que empezábamos.
No necesitamos otra página que nos explique que OrderService crea pedidos. Eso podemos verlo.
Necesitamos saber por qué una cancelación no es inmediata. Qué sistema obliga a conservar ese identificador. Qué incidente justificó ese reintento. Qué condición nos permitiría retirar una excepción.
Al final, una buena documentación no se mide por la cantidad de páginas. Se nota cuando alguien puede cambiar algo sin tener que jugar a adivinar por qué estaba hecho así.
Es la que evita que el próximo equipo tenga que hacer arqueología informática para entender una decisión.
Las herramientas nos ayudan a leer el código más deprisa. Estupendo. Aprovechémoslas. Pero no confundamos velocidad de lectura con comprensión de las decisiones. Esa parte sigue exigiendo memoria, criterio y explicaciones que alguien se haya tomado la molestia de dejar por escrito.
No documentes el código dos veces. Documenta lo que se perdería si mañana desaparecieran quienes tomaron la decisión.
Una práctica para mañana
Elige una página de documentación que lleve tiempo sin revisarse. Pregúntate qué partes puedes comprobar en el repositorio y cuáles explican decisiones que alguien tendría que contarte. Las primeras pueden generarse, enlazarse o eliminarse si están duplicadas. Las segundas son las que merece la pena cuidar.
Cómo empezaría en un equipo sin convertirlo en burocracia
No propondría una gran campaña para documentarlo todo. Eso suele terminar en una carpeta llena de documentos que nadie vuelve a abrir. Empezaría mucho más pequeño.
- Crear una carpeta
docs/adr/con una plantilla de una página. - Elegir tres o cinco decisiones actuales que condicionen de verdad el desarrollo: una integración, una restricción de negocio, una elección de infraestructura.
- Dejar en cada ADR el motivo, las alternativas y la circunstancia que permitiría revisarlo.
- Añadir una pregunta a las pull requests: «¿Cambia esto alguna decisión o procedimiento que otro compañero necesita conocer?».
- Cuando haya una incidencia o se descubra una excepción rara, registrar el contexto antes de que vuelva a perderse.
Y algo importante: no hace falta escribir un ADR por cada ajuste. Si documentarlo cuesta más que el valor del contexto que conserva, seguramente estamos complicando el proceso. La intención es que el equipo dependa menos de la memoria individual, no que trabaje más lento.
Preguntas frecuentes
¿Qué información debería ir en un ADR?
El contexto que obliga a decidir, la decisión elegida, alternativas relevantes, consecuencias y, si es posible, una condición que indique cuándo merece revisarse. No necesita explicar cada detalle de implementación.
¿Un README debería explicar la arquitectura?
Sí, pero a nivel de orientación: propósito, límites principales, cómo ejecutar el proyecto y dónde encontrar decisiones o documentación más específica. No debería convertirse en una copia manual de clases, métodos o dependencias que el repositorio ya expresa.
¿Qué documentación conviene generar automáticamente?
Referencia de API, opciones de configuración, comandos CLI, schemas y otras piezas cuya fuente autoritativa ya existe en código o contratos. Generarlas reduce la divergencia.
¿Cómo mantener los runbooks actualizados?
Tratándolos como parte viva de la operación: versionados, revisados tras incidentes y, cuando sea posible, probados mediante simulacros o procedimientos regulares. Un runbook no probado puede dar una falsa sensación de seguridad.
¿Cómo ayuda la documentación a los coding agents?
Aporta contexto que el código no expresa de forma inequívoca: invariantes, decisiones, restricciones, comandos de validación, convenciones y riesgos. Las instrucciones locales cerca del código ayudan a reducir la ambigüedad.
Deja una respuesta