IA · SDLC · DEVELOPER EXPERIENCE
El nuevo cuello de botella del desarrollo es revisar
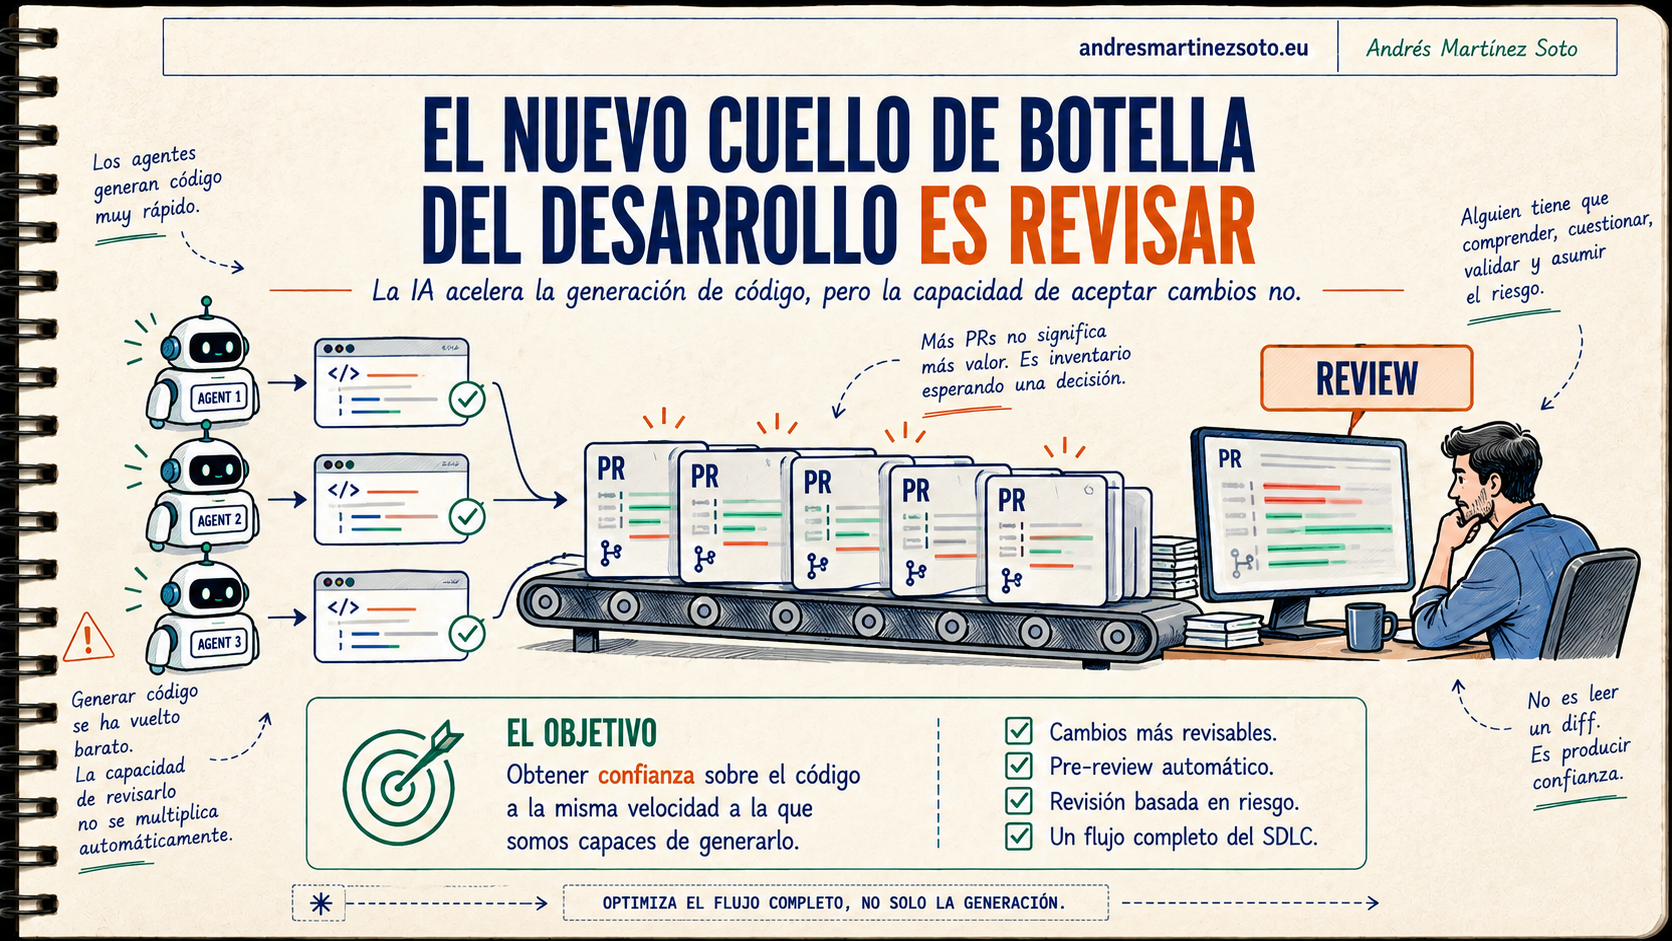
El cuello de botella del desarrollo está cambiando. La IA ha abaratado la producción de código de forma espectacular, pero el trabajo no ha desaparecido: se ha desplazado. Alguien sigue teniendo que entender cada cambio, cuestionarlo, validarlo y asumir la responsabilidad de llevarlo a producción. Estamos acelerando una fase del ciclo de desarrollo mucho más que las demás y, como en cualquier sistema con capacidades desiguales, la espera termina apareciendo en otro punto.
Imagina una mañana cualquiera en un equipo que ya convive con agentes de IA. Llegas a las nueve y te encuentras con tres pull requests en la bandeja. Das un pequeño paseo, vuelves a las diez, y de repente son siete. No es que hayan contratado a un escuadrón de desarrolladores ninja en la última hora; es que los agentes han estado trabajando en paralelo, mientras tú, como el resto del equipo, sigues teniendo los mismos límites humanos de atención y tiempo.
Uno ha corregido un bug, otro ha actualizado una integración y un tercero ha preparado un refactor. Todos han ejecutado sus tests y han producido un diff que, a primera vista, parece razonable. Ahora esperan a que alguien los revise.
Y aquí es donde reside el verdadero desafío: generar el cambio se ha vuelto ridículamente barato, pero confiar en ese cambio sigue siendo caro. Requiere tiempo, contexto y, sobre todo, criterio humano.
Llevamos décadas abaratando la creación de software, capa tras capa: lenguajes más expresivos, autocompletado, IDEs, gestores de paquetes, CI/CD, generadores y scaffolding. Los agentes de codificación son el siguiente salto cuántico. Pero esta vez, la diferencia de velocidad es abismal.
Un cambio que antes te robaba media mañana ahora aparece en minutos. Y lo hace en paralelo: un agente reproduce un bug, inspecciona el repositorio, modifica el código, lanza los tests y te prepara un PR mientras tú estás en una reunión o trabajando en otra cosa.
La mejora es real y, bien utilizada, enorme. Pero también cambia la economía interna de todo nuestro proceso de desarrollo.
La parte incómoda es que no todas las estaciones del SDLC se aceleran al mismo ritmo. Podemos multiplicar la generación sin multiplicar de la misma forma nuestra capacidad para comprender, validar y aceptar lo generado.
Por eso estoy convencido de que el verdadero cambio no está en cuántas líneas de código podemos producir, sino en qué ocurre inmediatamente después. El cuello de botella del desarrollo empieza a estar menos relacionado con escribir y mucho más con comprender, validar y decidir.
La consecuencia puede resumirse así:
Estamos abaratando la producción de código mucho más rápido que la producción de confianza sobre ese código.
El problema es que el sistema no termina cuando aparece el diff. A partir de ahí, todavía queda una parte considerable y crítica del trabajo de ingeniería.
Hay que entender qué ha cambiado y comprobar que la solución ataca el problema real. Hay que revisar decisiones de arquitectura, valorar riesgos, cuestionar supuestos y verificar que los tests están probando algo relevante. Y, según el caso, también tendremos que pensar en seguridad, concurrencia, integridad de los datos, compatibilidad, despliegue, observabilidad y planes de rollback.
Al final de todo ese proceso queda una pregunta que ninguna cifra de líneas generadas responde por sí sola:
¿Confío lo suficiente en este cambio como para ponerlo en producción?
Esa capacidad para producir confianza no se multiplica automáticamente porque hayamos acelerado la generación. Si no rediseñamos el resto del flujo, simplemente trasladamos la espera a otra parte.
El cuello de botella no desaparece: se mueve.
TL;DR
Cuando generar código se vuelve barato, el cuello de botella del desarrollo se desplaza hacia comprensión, revisión y validación. Si multiplicamos la capacidad de generación sin aumentar la capacidad efectiva de revisión, crecen el WIP, las colas y el riesgo de convertir el code review en un mero trámite. La solución no es pedir a los humanos que lean más rápido: necesitamos cambios más revisables, pre-review automático, contexto explícito, routing basado en riesgo y métricas que optimicen el flujo completo del SDLC.
Cuando el cuello de botella del desarrollo deja de ser escribir código
Durante mucho tiempo, escribir software fue una de las partes claramente costosas del proceso. No era solo teclear: había que localizar las piezas relevantes, comprender APIs, interpretar requisitos incompletos, escribir tests, depurar y encajar la solución en un sistema que casi siempre tenía más historia de la que decía la documentación.
La IA no elimina ese trabajo, pero sí puede comprimir una parte importante y, sobre todo, realizar en paralelo tareas que antes competían por el tiempo del mismo desarrollador.
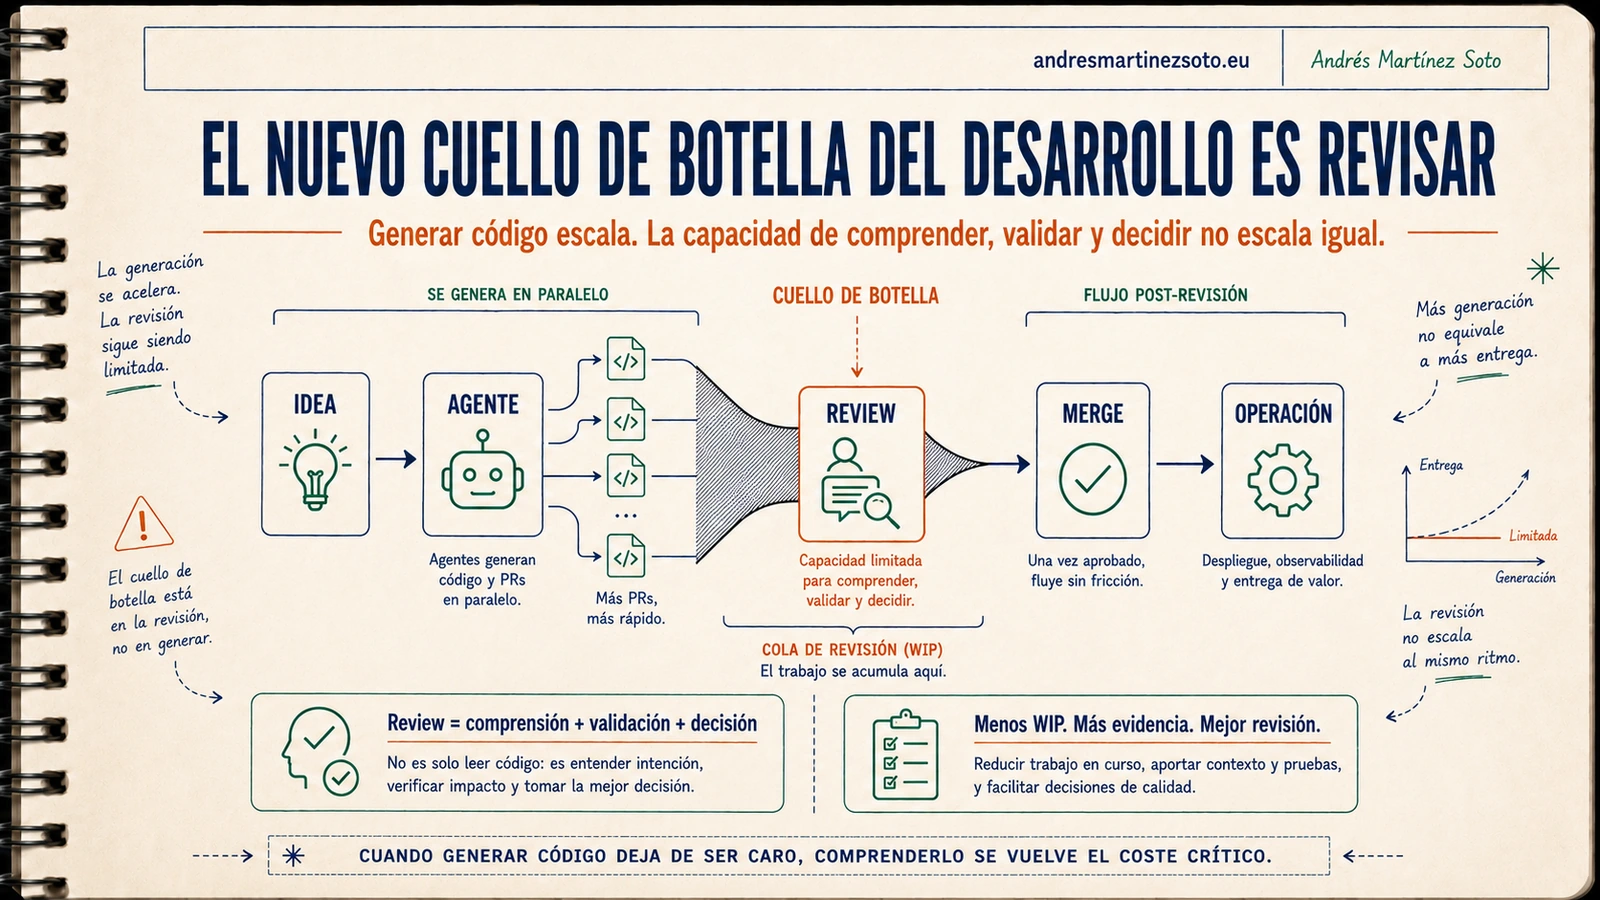
Cuando una estación de un sistema se acelera de esta forma, a mí me parece más útil dejar de mirar esa estación de manera aislada y preguntarme qué ocurre con el flujo completo.
La pregunta pasa a ser:
¿qué estación pasa ahora a limitar el flujo?
OpenAI compartió recientemente un caso interno que ilustra esto a la perfección. Al aumentar el flujo de código generado por agentes, el freno apareció inevitablemente en la capacidad humana de QA y validación. Su respuesta no fue pedir a las personas que revisaran más rápido (algo insostenible), sino hacer el entorno más legible para las máquinas y desplazar parte de la comprobación a procesos automatizados de agente a agente.
Me parece un ejemplo brillante porque obliga a cambiar la forma de medir la optimización. Si una tarea tarda diez minutos en generarse pero necesita cuarenta minutos de comprensión y validación, reducir la generación a cinco minutos apenas cambia el ciclo completo.
De hecho, puede ocurrir algo peor: durante esos cuarenta minutos de revisión, el agente puede haber generado varios cambios adicionales. La métrica local de «velocidad de generación» mejora de forma espectacular, mientras el sistema acumula inventario (y deuda de atención) delante de la estación que no hemos acelerado.
Eso es precisamente lo que conviene evitar: confundir la velocidad de una herramienta con el throughput real del equipo. El cuello de botella del desarrollo no se identifica mirando cuánto tarda el agente, sino observando dónde empieza a acumularse el trabajo.
Con varios agentes trabajando a la vez, el efecto es aún más evidente:
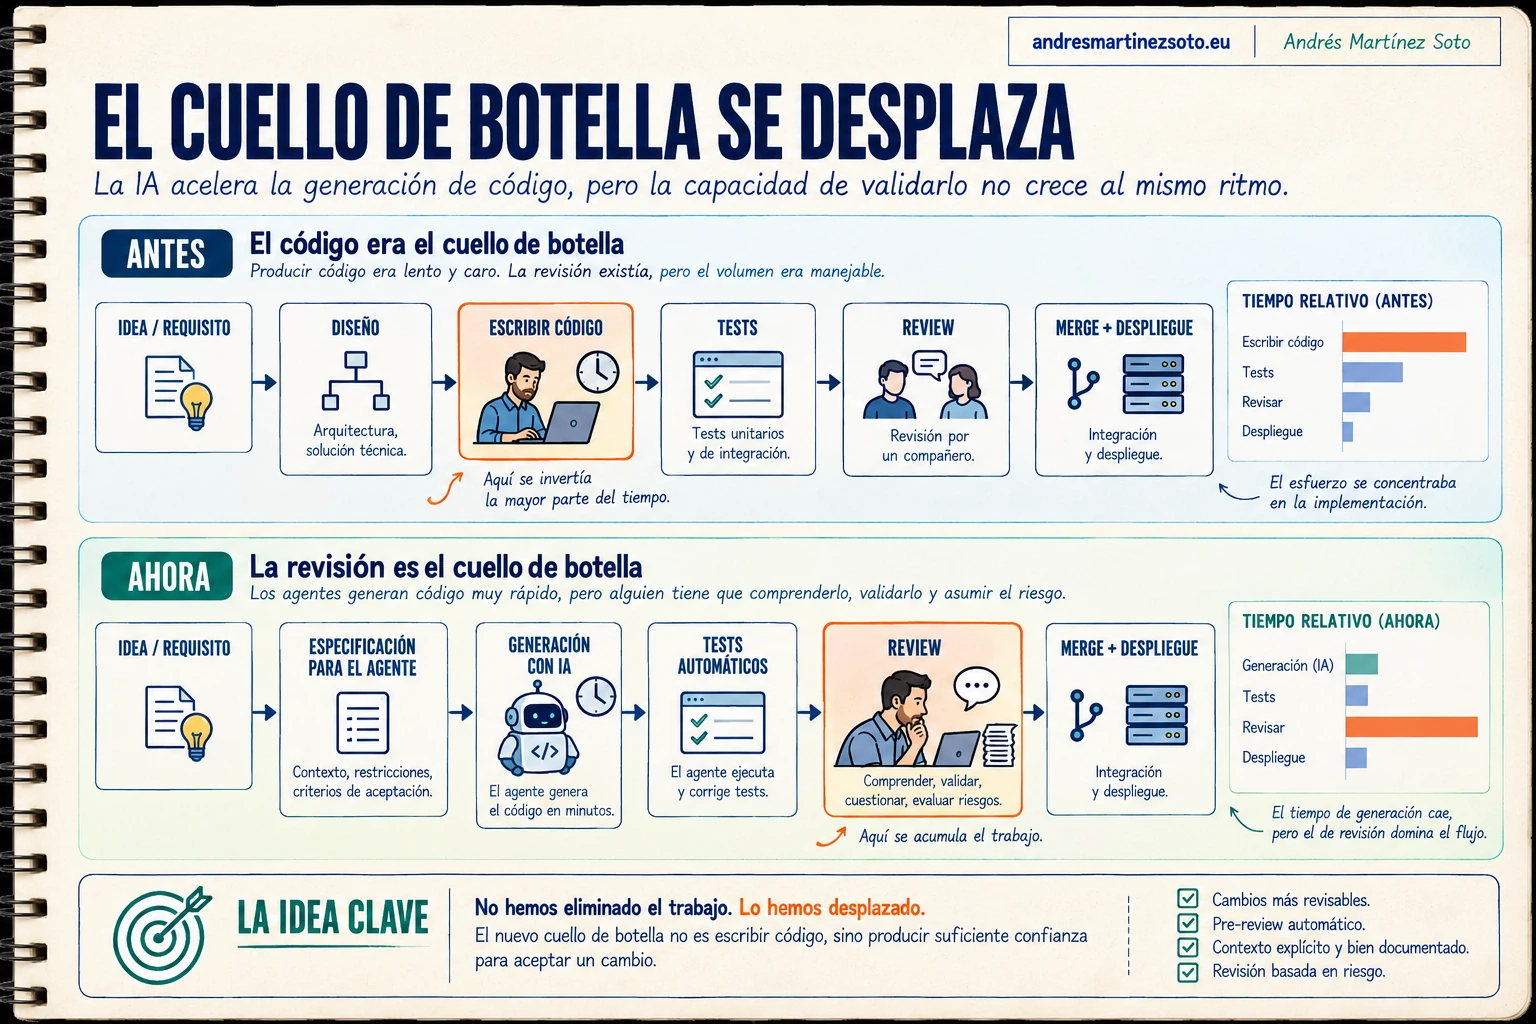
Este desplazamiento es el núcleo del problema. El reto ya no es «hacer el cambio», sino «tener razones sólidas para aceptarlo».
Producción no es entrega
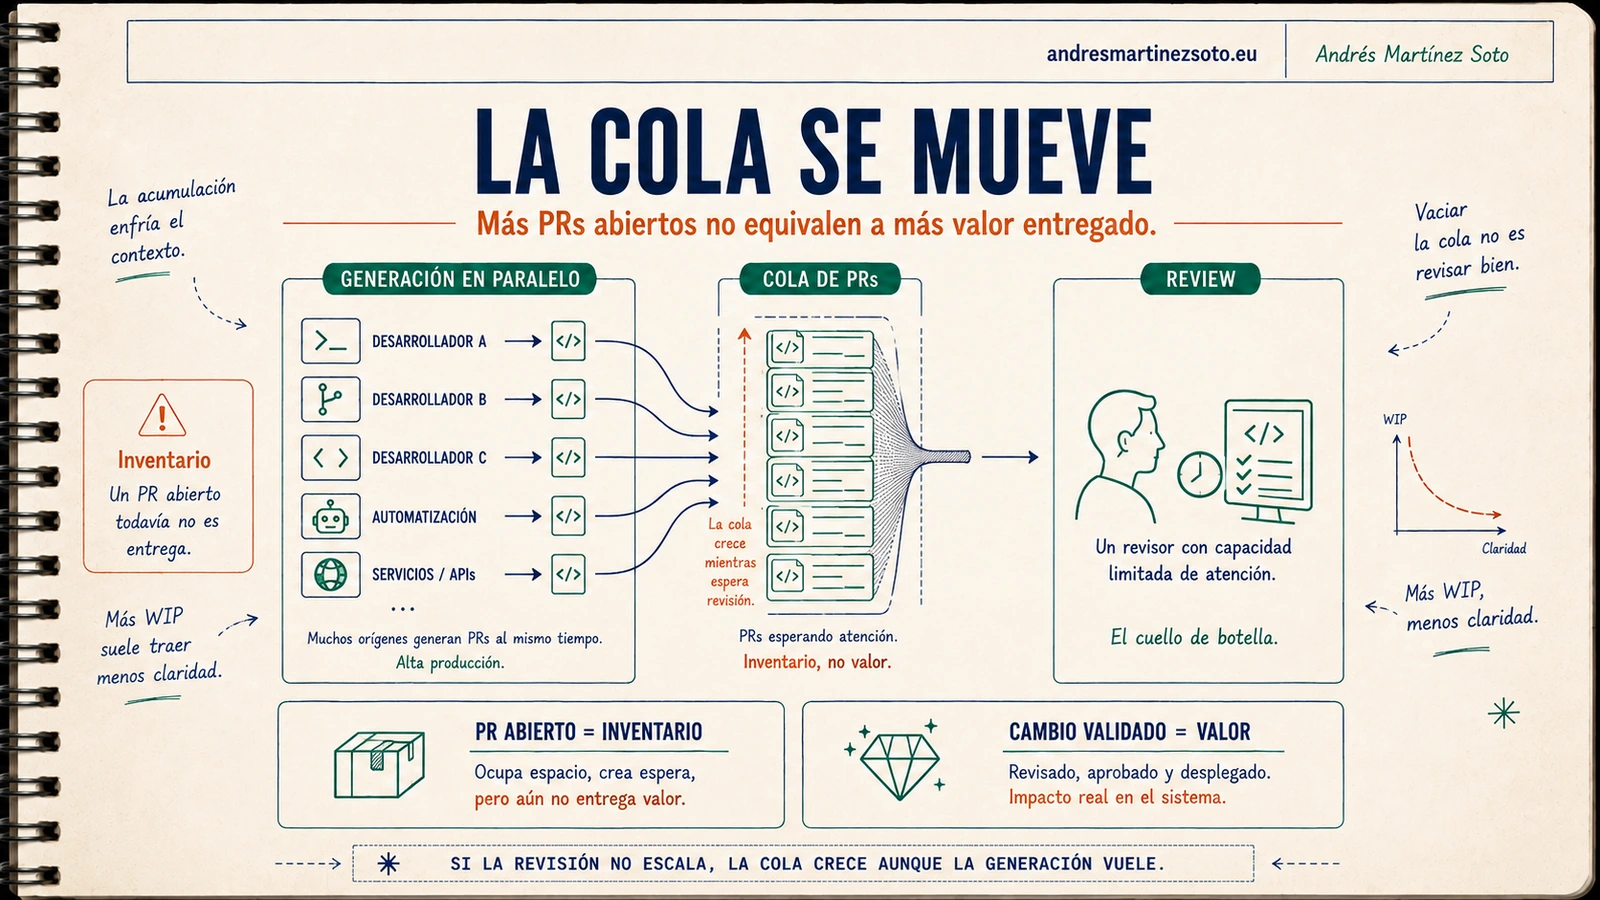
Un PR creado no es valor entregado. Es inventario. El valor aparece cuando el cambio ha sido comprendido, validado, integrado, desplegado y operado con éxito.
El coste cognitivo detrás del cuello de botella del desarrollo
Aquí surge una diferencia crucial entre escribir código y revisar código generado por IA. Cuando desarrollas una funcionalidad manualmente, pagas el «impuesto cognitivo» sobre la marcha. Lees el código existente, pruebas una abstracción, te topas con una restricción, cambias de enfoque y, a veces, rompes algo por el camino. Todo ese proceso va construyendo tu modelo mental del sistema.
Cuando finalmente llegas al diff, no partes de cero: ya sabes por qué existe cada pieza, qué alternativas descartaste y dónde están los límites del sistema.
Con un agente, la dinámica cambia. Pides un resultado y, minutos después, recibes un cambio aparentemente perfecto. El problema es que tú no has recorrido el camino que llevó hasta esa solución. No has probado las alternativas, no has tropezado con las restricciones y no has construido ese contexto. Cuando llega el momento de revisar, tu cerebro tiene que hacer ese trabajo a marchas forzadas.
Por eso el ahorro en generación no equivale automáticamente al mismo ahorro en comprensión.
El coste de producir el cambio ha disminuido; parte del coste cognitivo, en cambio, se ha desplazado. Y alguien tendrá que pagarlo antes de aceptar el cambio.
Antes, el desarrollador pagaba el coste cognitivo mientras escribía el código. Con un agente, esa factura se aplaza hasta el momento de la revisión.
Esta es una de las razones por las que cien líneas escritas por ti y cien líneas producidas en treinta segundos por un agente no tienen necesariamente el mismo coste de review.
El diff puede tener exactamente el mismo tamaño en ambos casos, pero el conocimiento previo con el que llegamos a él es muy distinto. Esa diferencia importa mucho cuando intentamos revisar deprisa sin convertir la revisión en un trámite.
Por eso, cuando hablamos de productividad con IA, tenemos que medir algo mucho más importante que la velocidad de generación. Si ignoramos ese coste cognitivo diferido, acabamos midiendo mal el cuello de botella del desarrollo.
Modela el throughput: el cuello de botella del desarrollo está en el sistema
Podemos representar de forma muy simplificada el ciclo de una tarea:
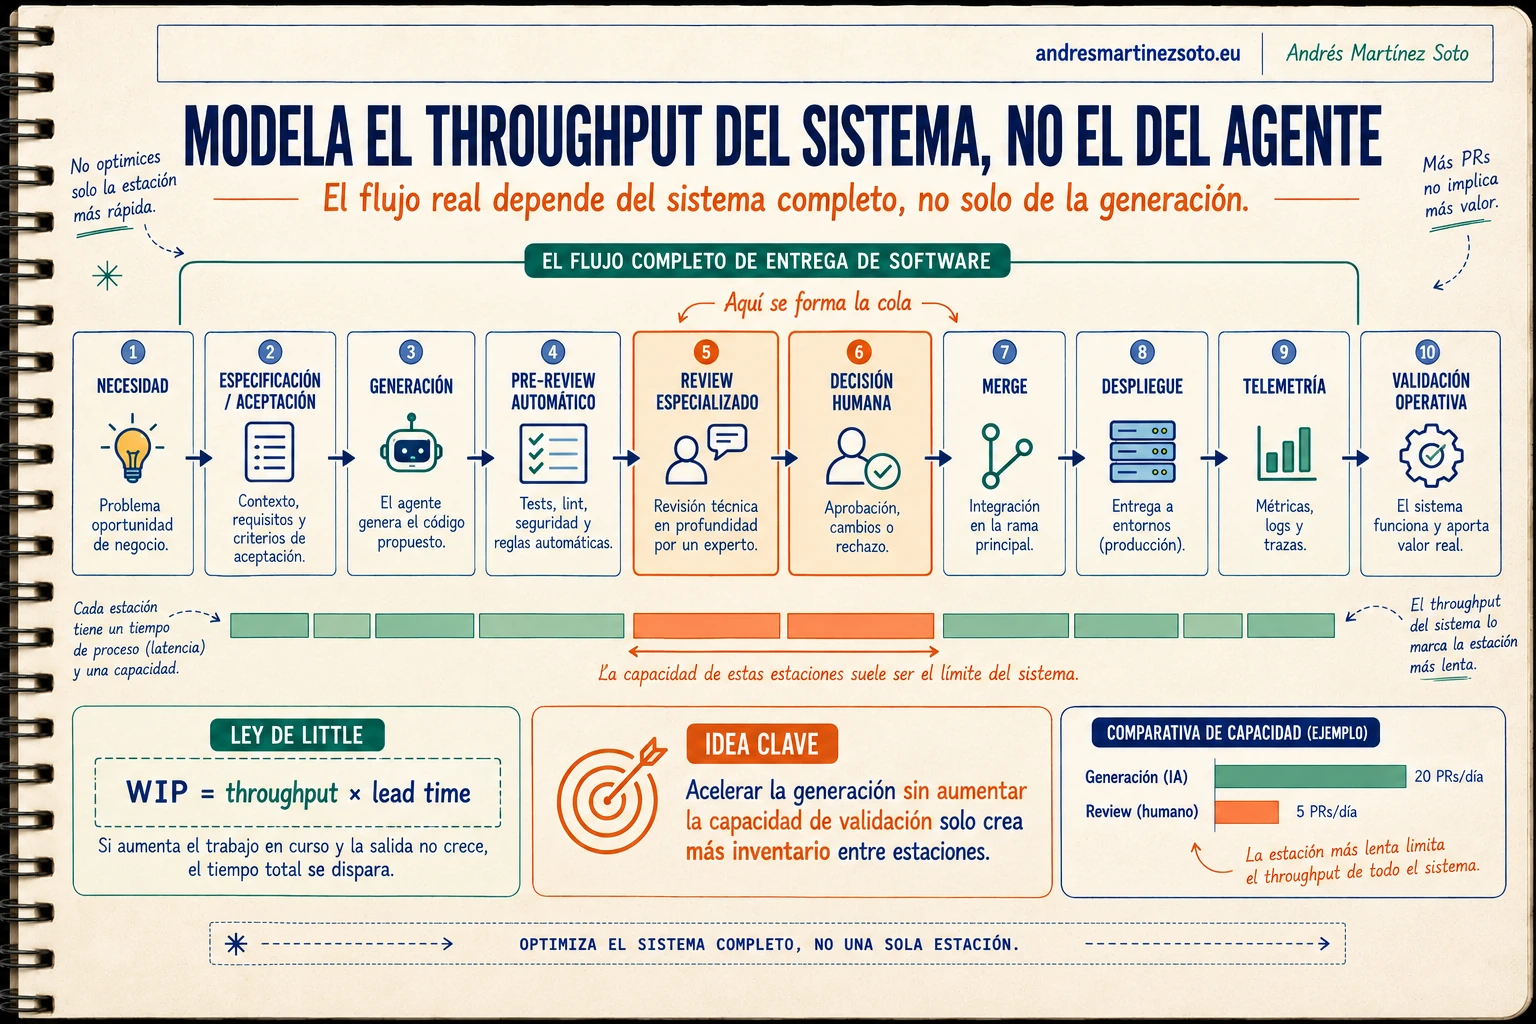
Cada etapa tiene su propia capacidad, variabilidad y tiempo de servicio. Y cada transición puede convertirse en una cola. Si multiplicamos por cinco la capacidad de generación pero dejamos intactas las etapas siguientes, el throughput final no se multiplica por cinco: lo que aumenta primero es el trabajo en curso. En otras palabras, el cuello de botella del desarrollo se encuentra en la capacidad más restrictiva del flujo, no en la herramienta más rápida.
Visto así, el problema deja de parecer específico de la IA. Es teoría de colas aplicada al SDLC.
La Ley de Little nos ofrece una forma sencilla de expresarlo:
Si el trabajo en curso (WIP) crece mientras la capacidad de salida sigue limitada, los cambios pasan más tiempo atascados en el sistema.
Y en el desarrollo de software, ese inventario envejece muy mal.
WIP = throughput × lead timeSi dejamos crecer el trabajo en curso mientras la capacidad de salida permanece limitada, el tiempo que los cambios pasan dentro del sistema tiende a dispararse.
En software, además, ese inventario no permanece pasivo:
- Los PRs envejecen y pierden relevancia.
- Aparecen conflictos de fusión con otros cambios.
- El contexto se enfría y hay que volver a recordarlo.
- Las ramas divergen y el mapa del repositorio se complica.
- Se construye trabajo nuevo sobre decisiones que aún no han sido aceptadas.
- Los reviewers sufren fatiga por el cambio constante de contexto.
- Una decisión incorrecta puede multiplicarse en cascada a través de varios cambios dependientes.
Por eso, la pregunta interesante deja de ser:
«¿Cuántos PRs puede generar nuestro agente?»
Y pasa a ser la verdadera pregunta de ingeniería:
«¿Cuántos cambios puede absorber nuestro sistema de ingeniería manteniendo un nivel aceptable de confianza?»
La cola se mueve: así aparece el cuello de botella del desarrollo
Supongamos un equipo con dos reviewers capaces de completar, en promedio, ocho revisiones significativas al día. Antes de introducir agentes, el equipo producía seis cambios diarios. La capacidad de revisión era superior a la tasa de llegada y la cola permanecía bajo control.
Después introducimos varios agentes y la producción se dispara hasta los quince cambios diarios. Podemos montar una presentación espectacular para la dirección:
«La producción de código ha aumentado un 150 %».
Y sería matemáticamente cierto. Pero al final del primer día, quedan siete cambios esperando. Al día siguiente llegan otros quince. Si nada cambia en el proceso, la cola no deja de crecer.
Entonces aparecen comportamientos organizativos bastante previsibles:
- PRs esperando horas o días hasta recibir una mirada humana.
- Reviewers saltando constantemente entre contextos, agotando su energía mental.
- Aprobaciones superficiales («LGTM») solo para vaciar la bandeja de entrada.
- Cambios cada vez más grandes y monolíticos, simplemente porque generarlos resulta barato.
- Fatiga de notificaciones y alertas.
- Tests que se aceptan como evidencia válida sin analizar realmente qué están probando.
- Más errores escapando a producción porque la revisión se ha convertido en un mero trámite.
No veo esto como un problema de «agentes demasiado productivos». El problema surge cuando seguimos gestionando el ciclo de desarrollo como si generar un cambio y validarlo requirieran la misma capacidad. No es así.
En cuanto separamos ambas cosas, la cola deja de ser una sorpresa y pasa a ser una señal clara del sistema. Esa cola es precisamente una de las formas más visibles de detectar el cuello de botella del desarrollo.
Revisar no significa leer un diff
También creo que empobrecemos el concepto de code review cuando lo reducimos a simplemente «mirar el código». Un reviewer no está leyendo caracteres en una pantalla: está intentando decidir si un cambio tiene sentido, encaja y es seguro dentro de un sistema concreto y vivo.
Para hacerlo, necesita responder preguntas en varias capas:
¿La solución corresponde al problema?
Un cambio puede estar perfectamente escrito y, aun así, resolver el problema equivocado. Especialmente cuando la especificación que recibió el agente era incompleta o ambigua.
¿Respeta las invariantes del dominio?
Hay reglas que quizá no aparecen explícitamente en el fichero modificado: permisos, transiciones de estado, compatibilidad histórica, comportamiento esperado por otro servicio o restricciones que solo conoce el equipo.
¿Encaja arquitectónicamente?
Una solución local puede funcionar y, al mismo tiempo, introducir una nueva dependencia, duplicar una abstracción existente o romper una frontera que el equipo había decidido mantener.
¿Qué ocurre cuando falla?
El «happy path» no es suficiente. Hay que pensar en timeouts, retries, concurrencia, datos parciales, idempotencia, rollback y observabilidad.
¿Podemos operarlo?
Un cambio no termina en merge. Tiene que desplegarse, monitorizarse y, si algo sale mal, diagnosticarse con rapidez.
Por eso prefiero pensar en el review como un mecanismo de producción de confianza. Leer el diff es solo una parte del proceso.
La paradoja de los tests generados por la misma IA
Que los agentes puedan producir tests con enorme rapidez es una ventaja innegable. Yo los uso a diario precisamente porque eliminan mucho trabajo mecánico. Pero hay una trampa sutil que conviene tener muy presente: cuando la implementación y la prueba nacen del mismo contexto mental (o del mismo prompt), pueden compartir el mismo error.
Si el agente interpreta mal un requisito, puede implementar de forma impecable esa interpretación errónea y, acto seguido, escribir un test que confirme exactamente ese mismo supuesto equivocado.
El resultado es desconcertante: desde el punto de vista del pipeline, todo es verde y perfecto. Los tests pasan, la implementación y la prueba son coherentes entre sí… y, aun así, el producto hace algo distinto de lo que el negocio necesitaba.
requisito real
      ↓
interpretación incorrecta
      ↓
   ┌───────────────┐
   ↓               ↓
implementación    test
   ↓               ↓
└──── "verde" ──┘El pipeline puede estar completamente verde y el producto seguir estando equivocado.
Por eso, la mera existencia de tests no equivale a evidencia independiente de calidad.
Cuanto más autónomo sea el proceso de generación, más crucial será distinguir entre:
- Tests que solo verifican la implementación interna.
- Tests derivados de criterios de aceptación independientes y externos.
- Contract tests que garantizan la comunicación entre servicios.
- Comprobaciones de invariantes del dominio.
- Property-based testing.
- Checks de seguridad y detección de secretos.
- Validación contra el comportamiento real del sistema en entornos de staging.
Un check verde responde a una pregunta concreta
Antes de confiar en él, necesitamos saber cuál era exactamente esa pregunta y si era independiente del supuesto que produjo el código.
Reviewability: diseñar contra el cuello de botella del desarrollo
Google lleva años predicando la virtud de los cambios pequeños (Small CLs): se revisan más rápido, con mayor profundidad, facilitan la detección de errores y simplifican los rollbacks. Con código producido por agentes, esta recomendación no es solo buena práctica, es una cuestión de supervivencia.
Un agente puede generar cinco mil líneas sin parpadear, pero esa hazaña técnica no convierte esas cinco mil líneas en una unidad de revisión razonable. Aquí debemos trazar una línea clara entre lo que la máquina puede producir de una vez y lo que un cerebro humano puede comprender y validar de una vez.
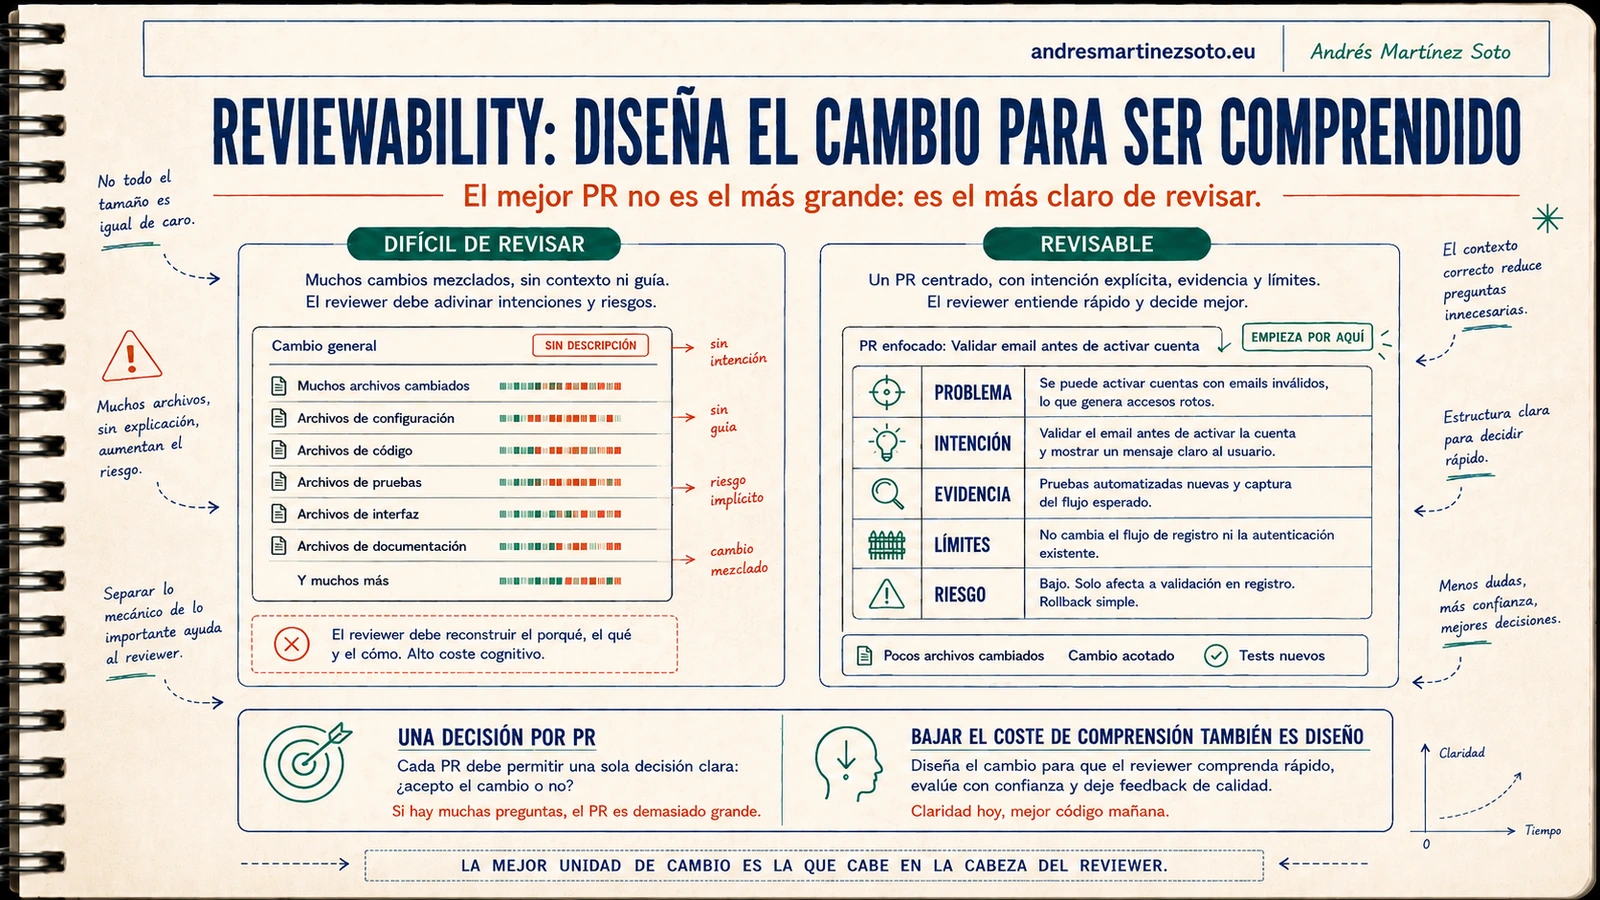
Por eso propongo tratar la reviewability (la facilidad de revisión) como una propiedad explícita y exigible de cada PR, no como una consecuencia accidental de cómo haya trabajado el agente. Mejorar esa propiedad reduce directamente la presión sobre el cuello de botella del desarrollo.
En la práctica, un cambio es mucho más fácil de revisar cuando reduce al mínimo la cantidad de contexto que el reviewer tiene que reconstruir por su cuenta. Se trata de equilibrar dos fuerzas:
- La capacidad ilimitada del agente para producir código.
- La capacidad finita y razonable del humano para comprender y aceptar ese cambio.
Eso implica pedir algo más que un diff correcto. Un cambio es notablemente más revisable cuando:
- Resuelve una sola decisión o comportamiento coherente.
- Explica el problema y la intención, no solo enumera los ficheros modificados.
- Declara explícitamente qué queda fuera de su alcance.
- Separa los cambios mecánicos (formateo, renombrados) de las decisiones semánticas.
- Identifica las zonas de mayor riesgo para guiar la atención del reviewer.
- Incluye evidencia vinculada directamente a los criterios de aceptación.
- Explica los efectos sobre contratos o dependencias externas.
- Indica claramente cómo se despliega y cómo se revierte si algo sale mal.
- Orienta al reviewer sobre dónde merece la pena gastar su valiosa atención.
El agente puede preparar gran parte de este contexto por nosotros.
## Objetivo

Evitar que dos workers renueven simultáneamente
el mismo lease.

## Cómo revisar este PR

Empieza por:
- src/billing/lease.ts
- tests/billing/concurrency.spec.ts

## Riesgo

Concurrencia / facturación.

## Generado mecánicamente

- fixtures/*

## No cambia

- política de retries
- contrato con ERP
- schema de base de datos

## Evidencia

- test de reproducción previo al fix
- test concurrente
- suite de integración
- benchmark sin regresión apreciable

## Rollback

Revert del commit sin migración de datos.Para mí, esto no es burocracia. Si consigue reducir el tiempo que la siguiente persona necesita para reconstruir el cambio, es una inversión. Es una forma elegante de comprimir contexto y viajar junto con el código.
Y esa compresión puede ser una de las tareas donde los agentes aporten más valor real.
Una buena unidad de trabajo ha cambiado
No es la cantidad de código que un agente puede producir de una vez. Es la cantidad de cambio que el sistema puede comprender, validar y aceptar de forma segura.
Context engineering también es para el reviewer
Hablamos mucho de «Context Engineering» para alimentar bien al agente: READMEs, archivos AGENTS.md, documentación, contratos, ejemplos y memoria del repositorio. Sin embargo, solemos olvidar que el humano que revisa necesita exactamente el mismo trato.
Un reviewer no debería tener que hacer arqueología del repositorio cada vez que recibe una notificación. Si conocemos la necesidad original, los criterios de aceptación, las decisiones arquitectónicas relacionadas y los contratos afectados, toda esa información debería viajar empaquetada junto con el PR.
Ahí la IA puede ser especialmente útil: no solo para escribir más código, sino para reunir información distribuida y preparar un paquete de contexto que haga ese código más barato de comprender. Es la misma idea que desarrollo al hablar de IA, contexto del código y las cicatrices del software: sin el porqué de una decisión, tanto humanos como agentes trabajan con una visión incompleta.
Ese cambio de enfoque me parece importante porque utiliza la IA para reducir la carga del cuello de botella del desarrollo, no para alimentarlo todavía más.
Idealmente, el PR debería acercarle al reviewer todo aquello que ya deberíamos haber aclarado antes de desarrollar. En qué documentar antes de desarrollar una aplicación con IA profundizo precisamente en esa idea: producto, flujo, arquitectura y reglas deben existir antes de delegar implementación.
- La necesidad original.
- Los criterios de aceptación.
- Las decisiones arquitectónicas relacionadas.
- El ownership del área.
- Los contratos afectados.
- Las dependencias relevantes.
- Los tests ejecutados.
- Los riesgos detectados.
- Los cambios de comportamiento.
- La estrategia de despliegue y rollback.
No necesitamos utilizar la IA solamente para producir más código. Podemos utilizarla para hacer que el código sea más barato de comprender.
Automatiza el pre-review antes de gastar atención humana
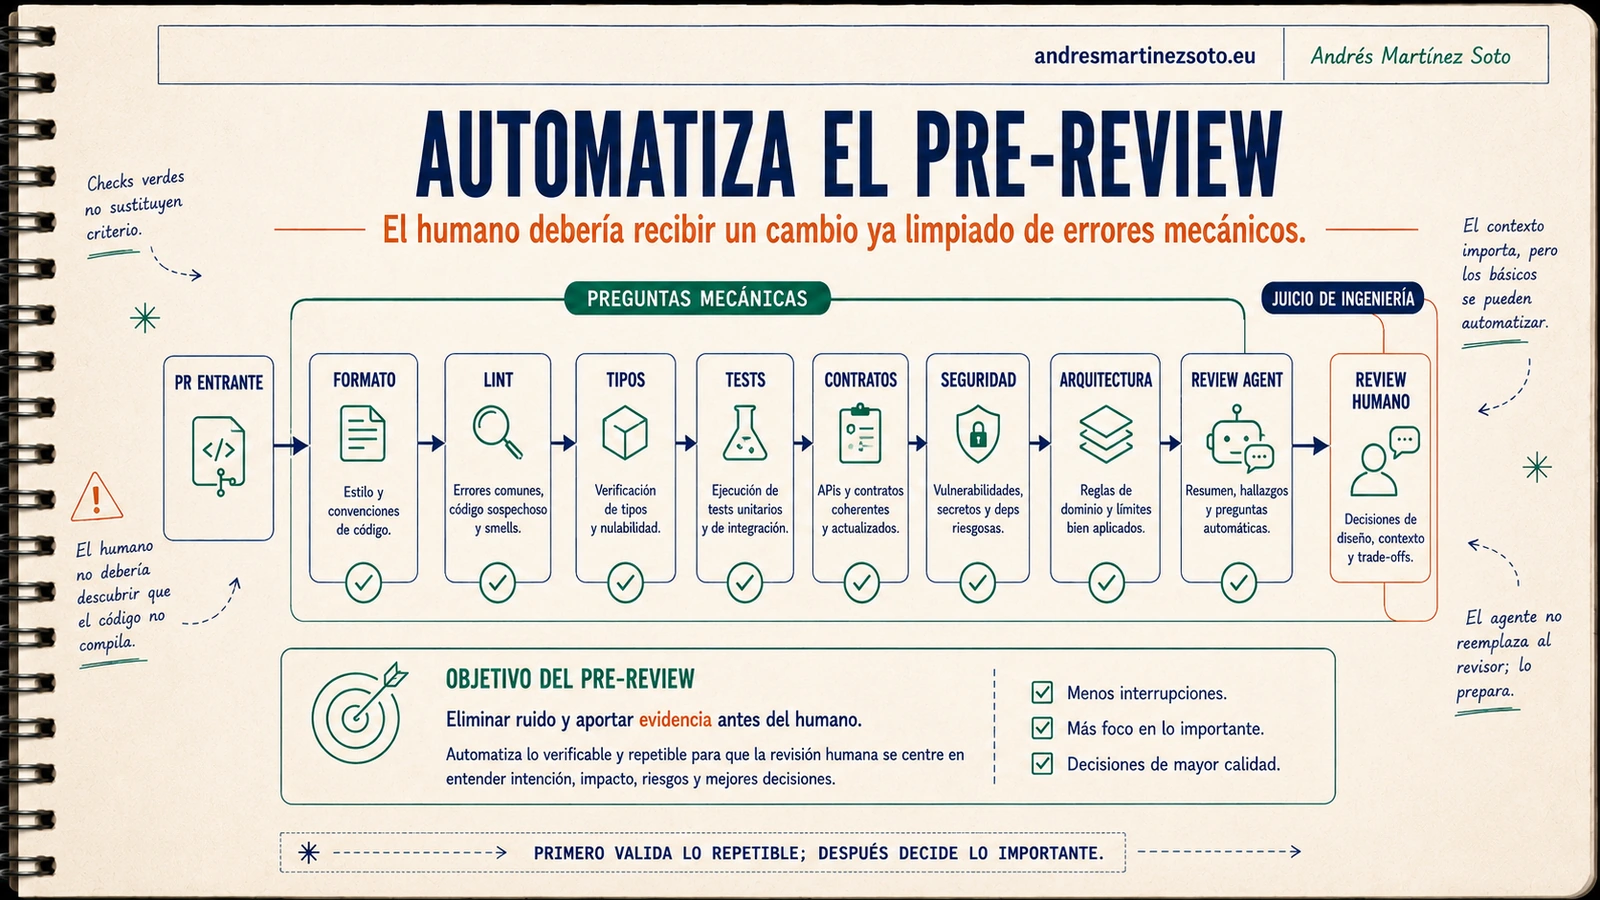
La atención de un ingeniero experimentado es un recurso caro y escaso, precisamente porque puede razonar sobre intención, arquitectura y trade-offs complejos. Por eso, mi regla de oro es no gastarla en comprobar cosas que una herramienta puede responder de forma fiable, determinista y repetible.
Un import sin usar, un error de formato, un fallo de tipado, una dependencia vulnerable o un secreto incluido por accidente deberían ser interceptados y bloqueados mucho antes de llegar a la bandeja de entrada del reviewer.
Lo mismo ocurre con la compilación, los tests, los contratos o determinadas reglas arquitectónicas: cuanto más podamos resolver de manera determinista antes del review, más atención queda disponible para las preguntas que sí requieren criterio.
El objetivo no es coleccionar checks verdes por vanidad. Es limpiar el camino de ruido para que, cuando el cambio llegue a una persona, solo queden las preguntas que realmente requieren juicio humano. Un buen pre-review amplía la capacidad efectiva del cuello de botella del desarrollo sin rebajar el nivel de control.
GitHub, por ejemplo, permite convertir tests, builds, code scanning y otros validadores en status checks exigibles antes del merge.
El principio que aplicaría es bastante sencillo:
No gastes juicio humano en una pregunta que una máquina puede responder de forma fiable.
Un pipeline de pre-review puede incorporar:
- Formatter y lint.
- Compilación y type checking.
- Tests unitarios y de integración.
- Contract tests.
- Análisis estático y SAST.
- Dependency scanning y detección de secretos.
- Validación de migraciones.
- Políticas arquitectónicas.
- Benchmarks cuando exista impacto de rendimiento.
- Revisión automática especializada por agentes.
La diferencia conceptual es importante:
ANTES DEL REVIEWER (Determinista)

¿compila?
¿pasan los tests?
¿rompe un contrato?
¿viola una regla arquitectónica?
¿introduce una vulnerabilidad conocida?
¿contiene secretos?
¿la migración es válida?
¿el diff corresponde al scope declarado?


PARA EL REVIEWER (Juicio humano)

¿es correcta la intención?
¿la solución es adecuada?
¿entiendo sus consecuencias?
¿acepto el trade-off?
¿acepto el riesgo?El objetivo del pre-review no es llenar el PR de checks verdes. Es conseguir que cuando llegue a una persona, las preguntas mecánicas ya estén respondidas y queden principalmente las que requieren criterio.
Agent-to-agent review: útil, pero no gratis
Si ya tenemos agentes generando código, utilizar otros agentes para revisar parte de ese trabajo es una evolución lógica. Un reviewer automatizado puede buscar problemas de seguridad, otro puede comprobar contratos y otro puede contrastar la implementación con los criterios de aceptación. Empresas como OpenAI y Ramp ya han documentado workflows donde los agentes solicitan reviews especializados e iteran entre ellos antes de que el resultado llegue al humano.
Sin embargo, automatizar la revisión no elimina mágicamente el coste cognitivo. De hecho, puede crear una nueva fuente de ruido. Si cinco agentes te lanzan cincuenta comentarios y cuarenta y siete son falsos positivos o trivialidades, no has resuelto el cuello de botella: lo has disfrazado. Ahora el humano no solo tiene que entender el código, sino que también tiene que hacer de árbitro de las opiniones de las máquinas.
Por eso, un agente de review debe medirse por la señal útil que aporta y el tiempo humano que realmente ahorra, no por la cantidad de observaciones que es capaz de generar. Importan métricas como:
- La precisión de sus comentarios.
- El porcentaje de observaciones que el humano termina aceptando.
- Los defectos relevantes que realmente encontró.
- La tasa de falsos positivos y duplicados.
- El tiempo humano neto ahorrado.
Para mí, un agente de review es útil cuando consigue que tenga menos cosas que comprobar y me señala exactamente dónde merece la pena mirar. Si después de leer sus comentarios sigo teniendo que revisar todo desde cero y, además, decidir cuáles de sus avisos tienen sentido, no hemos automatizado demasiado.
La capacidad cognitiva sigue siendo el recurso escaso
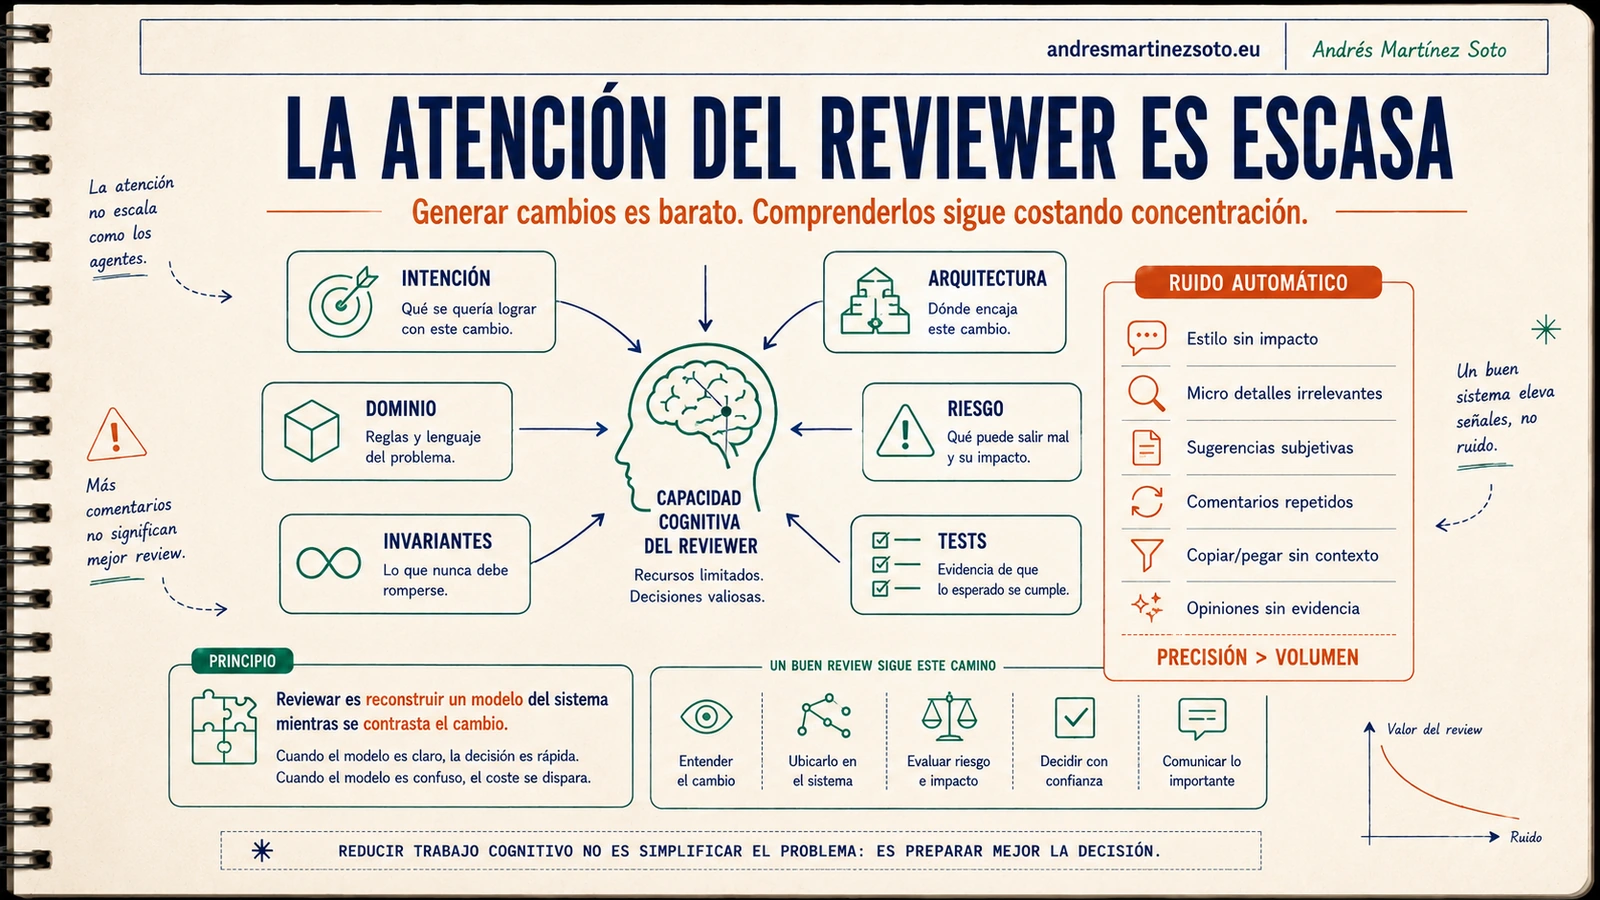
Hay una razón de peso por la que no podemos escalar reviewers humanos como escalamos servidores: revisar código no consiste en leer caracteres, sino en mantener un modelo mental complejo del sistema mientras contrastamos el nuevo cambio contra ese modelo.
Ese modelo incluye intención, invariantes del dominio, decisiones históricas, contratos, componentes cercanos, riesgos y comportamiento esperado. Parte estará documentada; otra parte seguirá viviendo en la experiencia tácita del equipo.
Además, esta capacidad cognitiva tiene un enemigo mortal: el cambio de contexto. Revisar diez PRs de diez dominios distintos no cuesta lo mismo que revisar diez cambios relacionados con una misma área. Cada salto de contexto obliga al cerebro a reconstruir desde cero el vocabulario, la arquitectura, el estado y los riesgos.
Por eso, aumentar la capacidad efectiva de revisión no se resuelve simplemente añadiendo más personas al equipo. Exige un ownership claro, un routing inteligente de las tareas y una cuidadosa afinidad de contexto. Si no gestionamos esa atención, el cuello de botella del desarrollo seguirá concentrándose en las mismas personas.
No todos los cambios merecen el mismo nivel de review
Otra forma inteligente de ampliar la capacidad efectiva es dejar de tratar todos los cambios como si tuvieran el mismo nivel de riesgo. No tiene ningún sentido aplicar el mismo proceso exhaustivo a la corrección de un typo que a una modificación en el sistema de autorización.
Podemos construir rutas diferentes según variables como:
- Radio de impacto (blast radius).
- Reversibilidad.
- Sensibilidad del dominio.
- Acceso a datos.
- Impacto de seguridad.
- Complejidad.
- Novedad arquitectónica.
- Calidad de la evidencia automática.
- Historial de regresiones del componente.
Por ejemplo:
| Tipo de cambio | Pre-review | Review | Despliegue |
|---|---|---|---|
| Texto / documentación | Automático | Mínimo o automático | Normal |
| CRUD acotado | Tests + análisis | General | Normal |
| Contrato API | Contract tests | Owner del dominio | Gradual |
| Migración de datos | Validación específica | Especializado | Plan + rollback |
| Auth / permisos | SAST + tests | Seguridad / senior | Gradual + observabilidad |
| Pagos / concurrencia | Tests especializados | Senior / dominio | Controlado |
El objetivo no es eliminar humanos del loop. Es evitar gastar el mismo nivel de atención en todo. La revisión basada en riesgo permite reservar capacidad para los cambios que realmente pueden agravar el cuello de botella del desarrollo o aumentar el impacto de un fallo.
El senior developer también cambia de trabajo
Todo esto transforma profundamente el trabajo del desarrollador senior. Si producir sintaxis se abarata, su valor se desplaza hacia tareas que antes a menudo quedaban implícitas o se hacían a medias: definir fronteras claras, hacer explícitas las invariantes del sistema, convertir requisitos ambiguos en criterios verificables y, sobre todo, decidir qué riesgos estamos realmente dispuestos a asumir.
Esto no significa que conocer el código deje de importar. Diría que ocurre casi lo contrario: cuanto más código seamos capaces de producir, más crucial será reconocer rápidamente cuándo una solución que parece plausible encaja de verdad en el sistema y cuándo es un parche peligroso.
- Definir fronteras y límites del sistema.
- Hacer explícitas las invariantes del dominio.
- Diseñar contratos claros entre servicios.
- Convertir requisitos ambiguos en criterios verificables.
- Decidir qué nivel de riesgo es aceptable.
- Diseñar estrategias de observabilidad y rollback.
- Crear guardrails y reglas para los agentes.
- Evaluar trade-offs arquitectónicos.
- Revisar decisiones de diseño, no solo sintaxis.
Cada vez tiene menos sentido gastar el tiempo más valioso del equipo en producir código rutinario que un agente puede resolver razonablemente bien, especialmente cuando ese mismo tiempo es crucial para definir el problema, poner límites, revisar la arquitectura o diseñar mecanismos de seguridad. Lo mismo ocurre con la deuda: como explico en no toda la deuda técnica debe pagarse, el criterio no debería ser arreglar todo, sino intervenir donde el riesgo y el coste de cambio justifican la atención.
El desarrollador senior no deja de programar; simplemente cambia el punto en el que su criterio aporta más valor. Su trabajo pasa a incluir, cada vez más, la construcción de un entorno seguro donde múltiples implementaciones puedan producirse sin que el equipo pierda el control del sistema.
Ese cambio de responsabilidad me parece bastante más interesante que discutir si un agente escribe mejor o peor una función concreta.
Métricas nuevas para una cola nueva
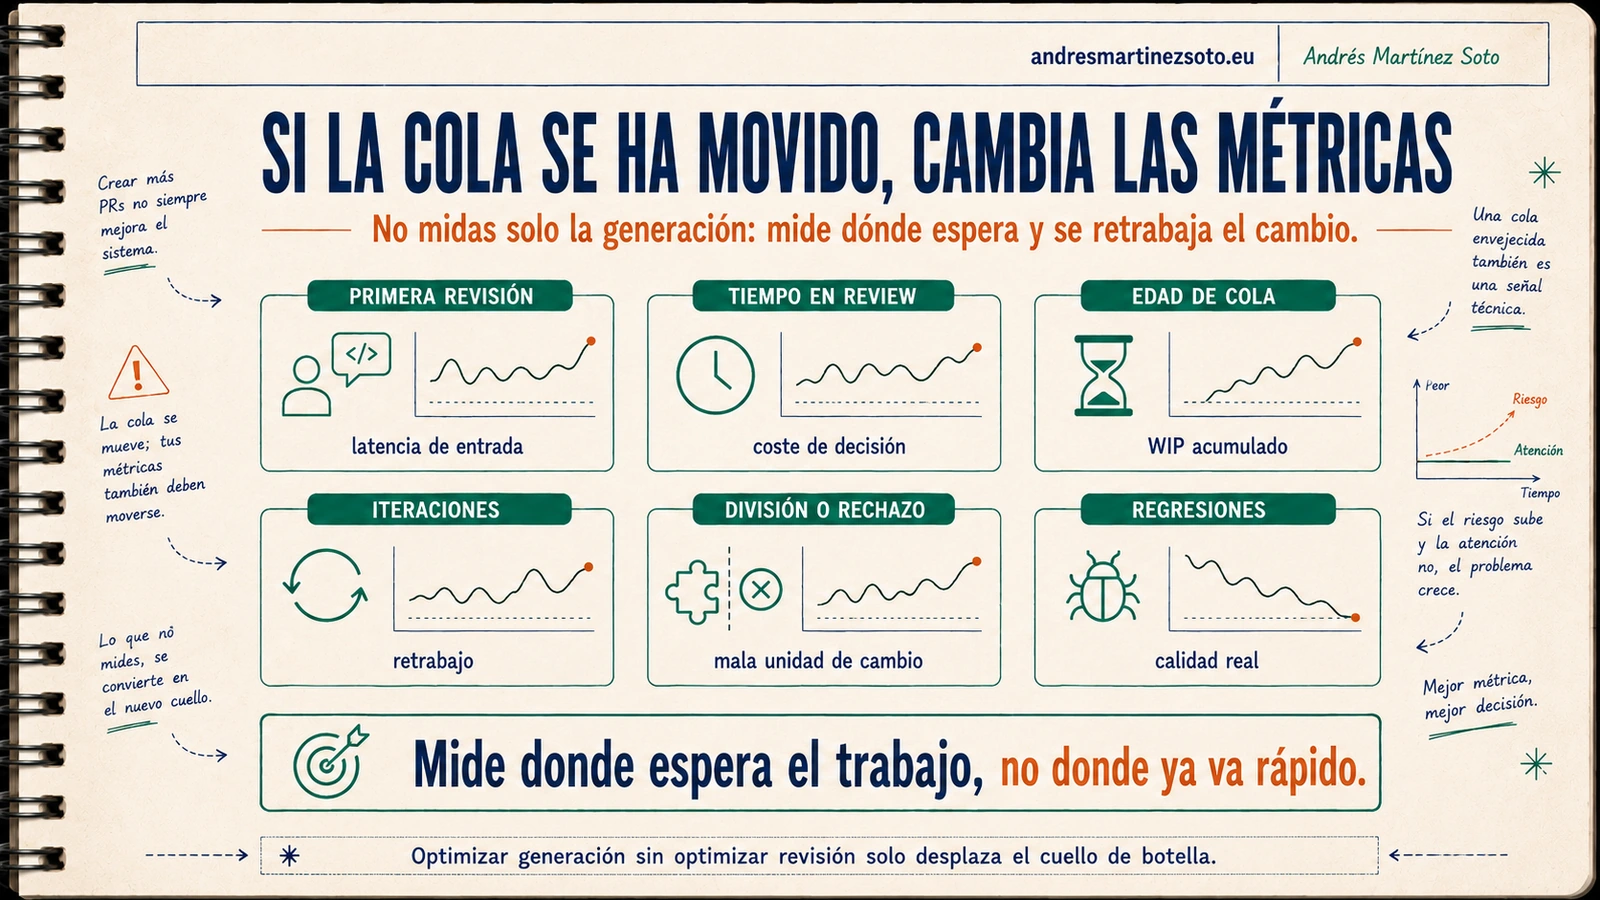
Si solo medimos cuántos PRs genera el equipo o cuánto tarda un agente en completar una tarea, corremos el grave riesgo de optimizar la estación equivocada. Para localizar el cuello de botella del desarrollo necesitamos observar el flujo completo y, sobre todo, separar el tiempo activo de trabajo del tiempo de espera en cola.
Pensemos en esto: un PR puede necesitar solo veinte minutos reales de revisión humana, pero permanecer doce horas atascado en la cola. En ese escenario, conseguir que el agente genere el cambio dos minutos más rápido tiene un efecto prácticamente nulo sobre el tiempo total de entrega (lead time).
| Métrica | Qué revela | Señal problemática |
|---|---|---|
| Tiempo hasta primera revisión | Latencia de entrada | El PR espera más de lo que tardó en generarse |
| Tiempo activo de review | Coste cognitivo | Cambios difíciles de comprender |
| Tiempo total en review | Flujo completo | Espera o iteraciones excesivas |
| Edad de la cola | WIP acumulado | Inventario creciente |
| Iteraciones | Retrabajo | Contexto o calidad inicial insuficientes |
| PRs divididos | Reviewability | Unidades demasiado grandes |
| Comentarios automáticos aceptados | Precisión del pre-review | Ruido de herramientas |
| Change failure rate | Calidad real | Más velocidad con peor resultado |
| Regresiones post-merge | Eficacia del control | Review rápido pero superficial |
| Tiempo de rollback | Reversibilidad | Cambios difíciles de operar |
La pregunta útil es: ¿qué está provocando esas doce horas de espera? ¿Es un routing deficiente? ¿Falta de ownership claro? ¿Exceso de WIP? ¿PRs demasiado grandes? ¿Falta de contexto o una estación de review simplemente saturada?
Solo después tiene sentido decidir dónde invertir en automatización.
A veces, la decisión más inteligente es simplemente dejar de generar trabajo durante un rato si la estación siguiente no puede absorberlo. Quizá lo que necesitamos es mejor routing, ownership más claro, menos WIP, PRs más pequeños, un pre-review más potente… o simplemente tener la disciplina de frenar la generación cuando el sistema de validación está saturado.
Un SDLC preparado para agentes debería parecer diferente
Si aceptamos que los agentes pueden multiplicar la producción, no tiene ningún sentido insertarlos en un proceso diseñado para otra tasa de llegada y esperar que todo lo demás permanezca igual. Si queremos reducir el cuello de botella del desarrollo, el ciclo de vida del software (SDLC) tiene que evolucionar al mismo ritmo que la herramienta.
Yo lo imagino como un flujo inteligente en el que cada tipo de validación ocurre en el punto más barato y fiable posible:
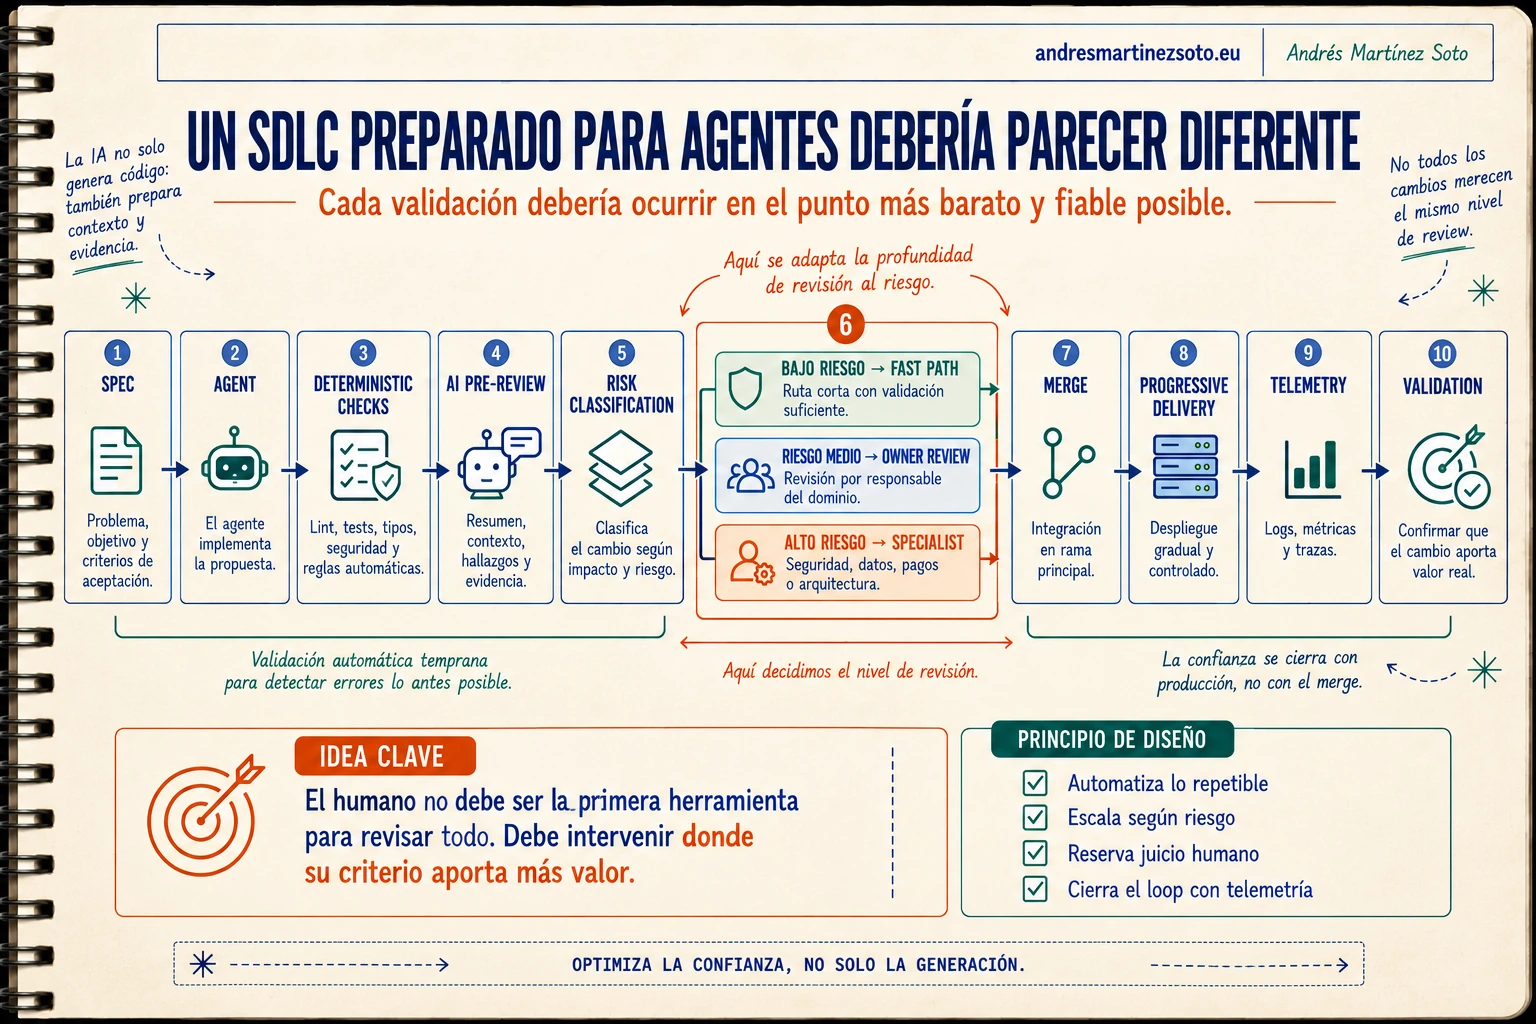
En este modelo, la IA no aparece únicamente en la estación de generación. También prepara el contexto, busca inconsistencias, clasifica el riesgo y sintetiza la evidencia. Las herramientas deterministas siguen haciendo aquello para lo que son insuperables, y el juicio humano queda reservado exclusivamente para las decisiones donde realmente aporta valor.
No se trata de sacar al humano del proceso por principio, sino de evitar que sea la primera herramienta a la que recurrimos para cualquier comprobación mecánica.
Cuanto más fiable sea la evidencia previa, más selectiva puede ser la intervención humana. Eso también permite que distintos cambios recorran rutas distintas según su riesgo.
Contraejemplo: hay cambios donde casi todo el review puede automatizarse
Hay, además, un matiz importante a toda esta tesis: no todo cambio necesita que una persona estudie cuidadosamente cada línea. Actualizaciones mecánicas, refactors producidos por herramientas fiables, cambios declarativos muy acotados o transformaciones con invariantes fácilmente verificables pueden automatizar gran parte del proceso sin reducir necesariamente la confianza.
De hecho, Google contempla los grandes cambios producidos por herramientas de refactorización confiables como una excepción razonable a su preferencia general por los cambios pequeños.
Para mí, esto no contradice la tesis, sino que la hace más precisa. El verdadero cuello de botella no es necesariamente «un humano leyendo código». El verdadero cuello de botella es obtener suficiente confianza para aceptar un cambio.
Si conseguimos producir esa confianza automáticamente mediante evidencia sólida, perfecto: el cuello de botella volverá a desplazarse y tendremos que localizar el siguiente. Eso es precisamente lo que debería ocurrir en un sistema que mejora continuamente.
Cómo empezaría en un equipo real
Si tuviera que introducir este enfoque mañana en un equipo real, no empezaría desplegando diez agentes adicionales. Empezaría midiendo el flujo que ya tenemos. Antes de automatizar más, querría saber dónde espera realmente cada cambio y cuánto de ese tiempo es trabajo activo frente a tiempo de cola.
1. Mide dónde espera realmente un cambio
Separa generación, cola hasta primera revisión, tiempo activo de review, iteraciones, merge, despliegue y validación.
2. Limita el WIP
Que un agente pueda comenzar otra tarea no significa que deba hacerlo. Si la cola de review está saturada, producir más inventario puede empeorar el lead time.
3. Define un contrato mínimo de reviewability
Objetivo, scope, riesgo, evidencia, zonas importantes y rollback deberían llegar junto al cambio.
4. Automatiza primero lo determinista
Un senior no debería descubrir manualmente algo que podía haber bloqueado el CI.
5. Introduce review automático con métricas
No midas cuántos comentarios genera. Mide cuántos son útiles.
6. Clasifica por riesgo
Reserva la atención más cara para las decisiones que realmente pueden causar daño.
7. Cierra el loop con producción
La calidad del review no se mide por cuántos comentarios dejó el reviewer. Se mide, en última instancia, por cómo se comporta el cambio una vez desplegado en producción.
El objetivo ya no es producir código más rápido
Volvamos a la escena del principio. Son las nueve y hay tres PRs esperando. A las diez ya son siete. Podemos mirar esa situación y celebrar que nuestros agentes funcionan extraordinariamente bien. Quizá sea cierto desde un punto de vista puramente técnico de generación.
Pero también puede ocurrir que el sistema completo, visto desde la perspectiva del valor entregado, esté funcionando peor.
Si la cola crece, el contexto se enfría, los reviewers saltan entre dominios agotando su energía y las aprobaciones se vuelven superficiales, producir todavía más cambios no arregla el problema; lo agrava.
Probablemente necesitemos menos WIP, cambios más pequeños, mejor contexto, checks deterministas, review automático con buena precisión, ownership claro, routing por riesgo y mejor observabilidad.
Los agentes cambian la economía del desarrollo porque abaratan una parte que durante décadas había sido costosa. Es una oportunidad enorme, pero también nos obliga a dejar de confundir una optimización local con una optimización real del sistema completo.
Si seguimos midiendo la productividad principalmente por cuánto código somos capaces de producir, podemos acabar celebrando precisamente aquello que está saturando y rompiendo nuestro proceso.
Por eso, para mí, la pregunta interesante ya no es cómo conseguir que los agentes escriban todavía más código. La verdadera pregunta es cómo producimos confianza sobre ese código a una velocidad similar. Ese es, en última instancia, el nuevo cuello de botella del desarrollo.
El futuro del desarrollo de software consiste en construir sistemas capaces de producir confianza sobre el código a la misma velocidad a la que ya somos capaces de generarlo.
Cuando consigamos hacerlo, la revisión dejará de ser el cuello de botella. No porque hayamos eliminado la necesidad de validar, sino porque habremos rediseñado el sistema para absorber esta nueva capacidad de generación.
Y, como siempre ocurre cuando optimizamos un sistema complejo, la cola volverá a moverse. Entonces, nos tocará encontrarla otra vez y seguir mejorando.
Una práctica para tu equipo
Durante dos semanas, mide cuánto tiempo pasa cada PR en generación, espera, primera revisión, iteraciones, merge y validación. Después compara el tiempo de producción con el tiempo necesario para obtener confianza. Puede que descubras que estás optimizando la parte del proceso que ya era suficientemente rápida. Si quieres seguir explorando arquitectura, IA aplicada y modernización, puedes consultar el archivo completo de contenidos técnicos.
Preguntas frecuentes
¿La IA está convirtiendo el code review en el nuevo cuello de botella?
Puede hacerlo cuando la capacidad de generar cambios crece más rápido que la capacidad del sistema para comprenderlos y validarlos. No es una condena inevitable: cambios pequeños, pre-review automático, límites de WIP y routing basado en riesgo pueden ampliar considerablemente nuestra capacidad efectiva.
¿Por qué cuesta revisar código generado por IA si el código es correcto?
Porque quien revisa no ha construido el modelo mental que normalmente aparece durante la implementación manual. Parte del coste cognitivo que antes se pagaba mientras se escribía el código se desplaza ahora hacia la reconstrucción y validación posterior del cambio.
¿Cómo hacer más revisable un PR generado por un agente?
Reduce su alcance, explica la intención y los criterios de aceptación, separa los cambios mecánicos, identifica los riesgos, aporta evidencia, declara qué no cambia y documenta el despliegue y el rollback cuando sean relevantes.
¿Los tests generados por IA son suficientes para validar su propio código?
No necesariamente. Si la implementación y los tests parten de la misma interpretación incorrecta del requisito, ambos pueden ser coherentes entre sí y seguir estando equivocados. Conviene incorporar criterios de aceptación, contratos e invariantes independientes de la implementación.
¿Qué debería automatizarse antes del review humano?
Todo aquello que pueda comprobarse de forma fiable y repetible: formato, lint, compilación, tipado, tests, análisis estático, seguridad, dependencias, secretos, migraciones y políticas arquitectónicas.
¿Más agentes de code review resuelven el problema?
Solo cuando producen señal útil. Si generan demasiados falsos positivos, pueden aumentar la carga cognitiva. Su eficacia debe medirse por los defectos relevantes encontrados, la precisión de sus comentarios y el tiempo humano que realmente ahorran.
¿Todos los cambios necesitan revisión humana?
No. Los cambios mecánicos, altamente verificables y de bajo riesgo pueden recorrer rutas mucho más automatizadas. La profundidad del review debería adaptarse siempre al riesgo, la reversibilidad, el radio de impacto (blast radius) y la calidad de la evidencia disponible.
¿Qué métricas ayudan a detectar un cuello de botella en review?
El tiempo hasta la primera revisión, el tiempo activo y total de review, la edad de la cola, el WIP acumulado, el número de iteraciones, los PRs divididos, los comentarios automáticos aceptados, el change failure rate, las regresiones post-merge y el tiempo de rollback.
Fuentes técnicas
- OpenAI — Harness engineering: leveraging Codex in an agent-first world
- OpenAI — How Ramp engineers accelerate code review with Codex
- OpenAI — Introducing upgrades to Codex
- GitHub Docs — Status checks
- GitHub Docs — Pull requests
- Google Engineering Practices — Small CLs
- Google Engineering Practices — Speed of Code Reviews
- Google Engineering Practices — What to look for in a code review
Deja una respuesta