DEVOPS · RESILIENCIA · EXPERIENCIA DE INGENIERÍA
Cuando hablamos de rollback en producción, hay una frase que se repite: «Si algo falla, hacemos rollback». Suena razonable. Incluso tranquiliza. Tenemos la versión anterior, sabemos volver a desplegarla y, en teoría, podemos recuperar el servicio en cuestión de minutos.
Últimamente he vuelto a pensar en esa frase mientras trabajamos para que nuestras instalaciones sean más repetibles. Docker nos ayuda mucho, pero también nos obliga a mirar de frente algo que no resuelve un contenedor: qué ocurre con todo lo que ha cambiado desde que publicamos la nueva versión.
Imaginemos una situación, no un incidente real: desplegamos una actualización, empiezan a aparecer errores y devolvemos la aplicación a la versión anterior. El servicio arranca. Respiramos. Entonces descubrimos que la base de datos ya tiene otro esquema, hay mensajes pendientes con el formato nuevo y alguna operación se ha enviado a un sistema externo. Hemos recuperado el código, pero quizá no hemos recuperado el comportamiento que necesitan los usuarios.
Esa es la pregunta que me interesa explorar aquí: ¿qué significa tener un rollback en producción que funcione de verdad? No es una discusión sobre el comando correcto. Es una conversación sobre datos, compatibilidad, límites y, sobre todo, sobre cómo comprobamos que podemos recuperarnos antes de necesitar hacerlo.
El rollback en producción no consiste solamente en volver al código anterior
Durante mucho tiempo nos hemos acostumbrado a asociar un despliegue con una versión de la aplicación. Publicamos una imagen nueva, sustituimos unos procesos y observamos si arrancan. Si algo sale mal, recuperamos la imagen anterior.
Esa parte puede ser bastante sencilla. Por ejemplo, Helm documenta helm rollback como una operación para volver a una revisión anterior de una release. Kubernetes permite algo parecido con las revisiones de un Deployment. Si utilizamos Docker Compose, podemos volver a fijar la imagen anterior y recrear los servicios.
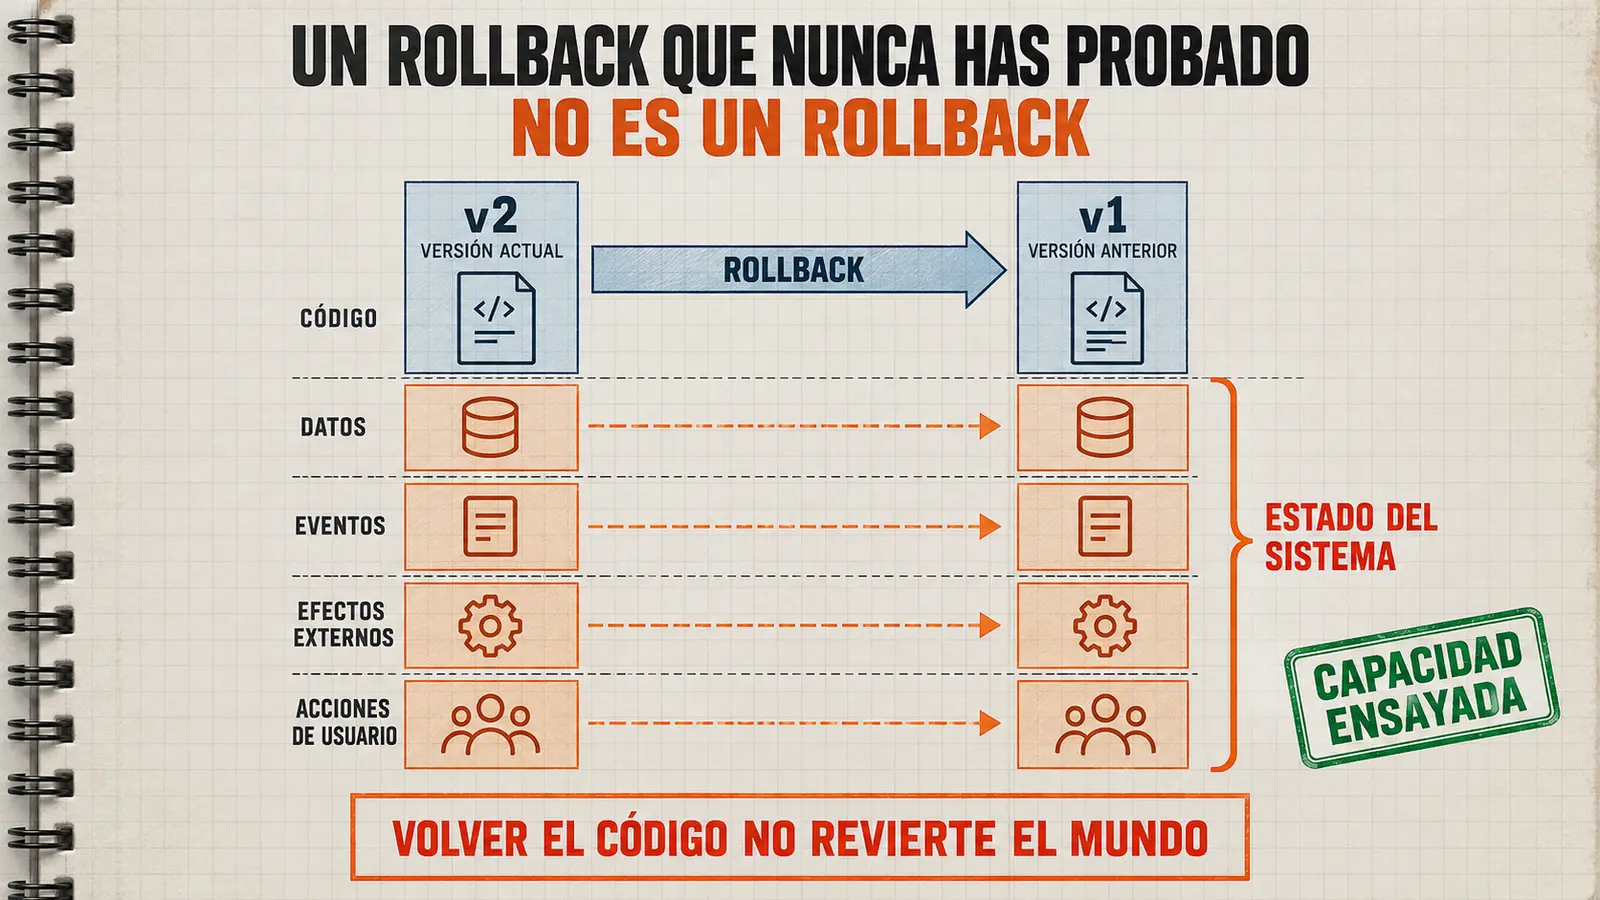
Las herramientas hacen lo que prometen. El malentendido aparece cuando damos por hecho que esa operación devuelve todo el sistema a un momento anterior.
El código vuelve; el estado no necesariamente
Pensemos en lo que puede haber ocurrido durante los quince minutos en los que estuvo activa la nueva versión. Alguien creó un pedido. Otro usuario modificó un registro. Se generaron documentos, salieron notificaciones y una integración procesó varios cambios. Quizá, además, ejecutamos una migración de base de datos.
Volver a una versión anterior del código no deshace automáticamente ninguna de esas acciones. En realidad, tampoco querríamos borrar indiscriminadamente el trabajo legítimo que hicieron los usuarios mientras la versión nueva estaba funcionando.
Por eso prefiero definir el rollback de forma menos espectacular y más útil: recuperar un estado operativo aceptable, con el menor impacto posible y con evidencia de que el sistema sigue siendo coherente.
No significa regresar exactamente al pasado. Significa disponer de una salida segura cuando un cambio no se comporta como esperábamos.
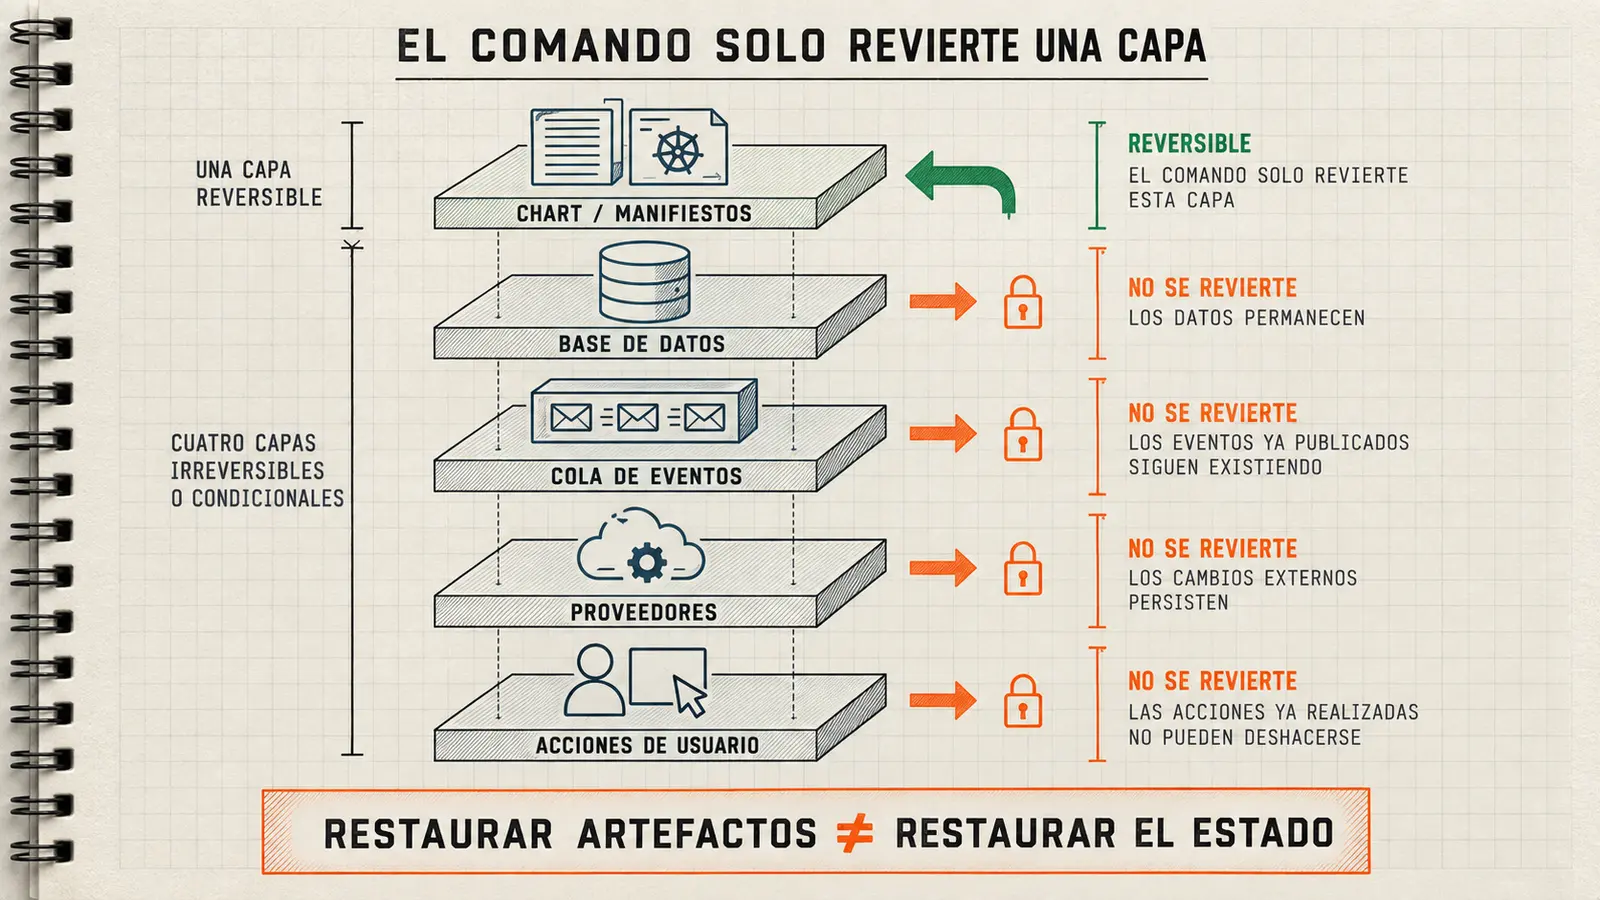
La idea clave: poder restaurar una versión no es lo mismo que poder recuperar el funcionamiento del sistema.
Una migración puede convertir un rollback en producción en un problema serio
La situación más conocida aparece cuando mezclamos una actualización funcional con una migración destructiva. La aplicación nueva necesita una columna diferente, así que la renombramos, copiamos los datos y eliminamos la antigua. Todo funciona hasta que decidimos volver al código anterior.
Entonces la versión antigua busca algo que ya no existe. El despliegue ha terminado correctamente, pero el programa no puede trabajar.
Este ejemplo parece fácil de evitar y, sin embargo, representa un error de enfoque bastante frecuente: suponemos que la evolución del código y la evolución de los datos tienen que ocurrir en el mismo momento.
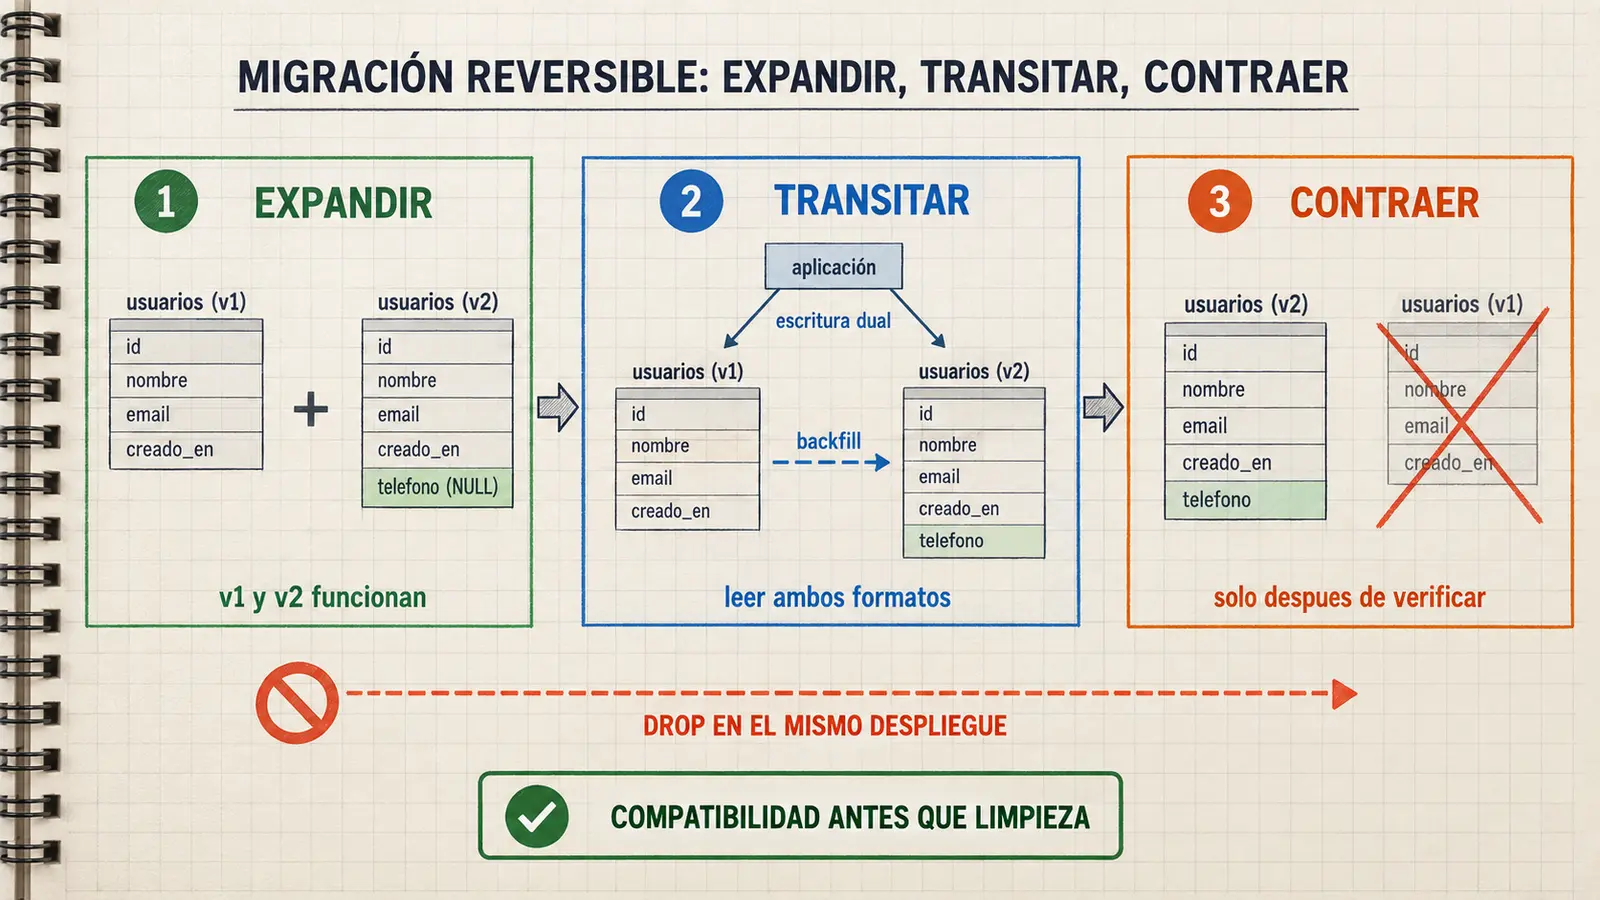
Expandir, transitar y contraer
Cuando el cambio lo permite, una técnica útil es el patrón expand/contract. En lugar de sustituir una estructura de golpe, la hacemos evolucionar en etapas.
- Expandir: incorporamos el campo o la estructura nueva sin eliminar la antigua.
- Transitar: adaptamos la aplicación para soportar ambos formatos durante una ventana controlada. Si hay que copiar datos, hacemos un backfill que podamos observar y repetir con seguridad.
- Verificar: comprobamos que las lecturas y las escrituras están migradas y que no quedan consumidores antiguos.
- Contraer: retiramos lo anterior en un despliegue posterior, cuando ya no es necesario para recuperar versiones previas.
Un ejemplo simplificado, en SQL de estilo PostgreSQL, podría tener esta forma:
-- Fase 1: ampliar el esquema sin romper la versión anterior.
ALTER TABLE customers ADD COLUMN display_name text;

-- Fase 2: migrar los registros pendientes.
UPDATE customers
SET display_name = customer_name
WHERE display_name IS NULL;

-- Fase 3: eliminar la columna antigua solo después de validar
-- la compatibilidad y retirar todas las versiones que la usan.
-- ALTER TABLE customers DROP COLUMN customer_name;
Este fragmento no es una migración completa lista para producción. Por sí solo no resuelve qué sucede con las escrituras concurrentes, cómo mantenemos ambos campos consistentes ni cuándo podemos eliminar el anterior. Esa parte debe diseñarse según las transacciones, el motor y las reglas de negocio.
Para un rollback en producción, el beneficio de este enfoque no es que todo sea más rápido. De hecho, durante un tiempo tenemos más complejidad. Lo que ganamos es margen para corregir un problema sin destruir al mismo tiempo la vía de retorno.
Revertir datos no es lo mismo que restaurar una copia
Hay otra confusión que conviene evitar. Una copia de seguridad puede ayudarnos a recuperarnos de una pérdida o corrupción, pero restaurarla sin más podría eliminar operaciones válidas que se han producido después.
Antes de decidir una restauración tenemos que saber qué queremos preservar, qué información puede reconstruirse y qué efectos externos necesitan reconciliación. No hay una respuesta universal; depende del impacto del cambio y de los compromisos de recuperación del producto.
Me parece una razón suficiente para que las migraciones de datos formen parte de la revisión de un despliegue y no queden reducidas a «ejecutar el script antes de arrancar».
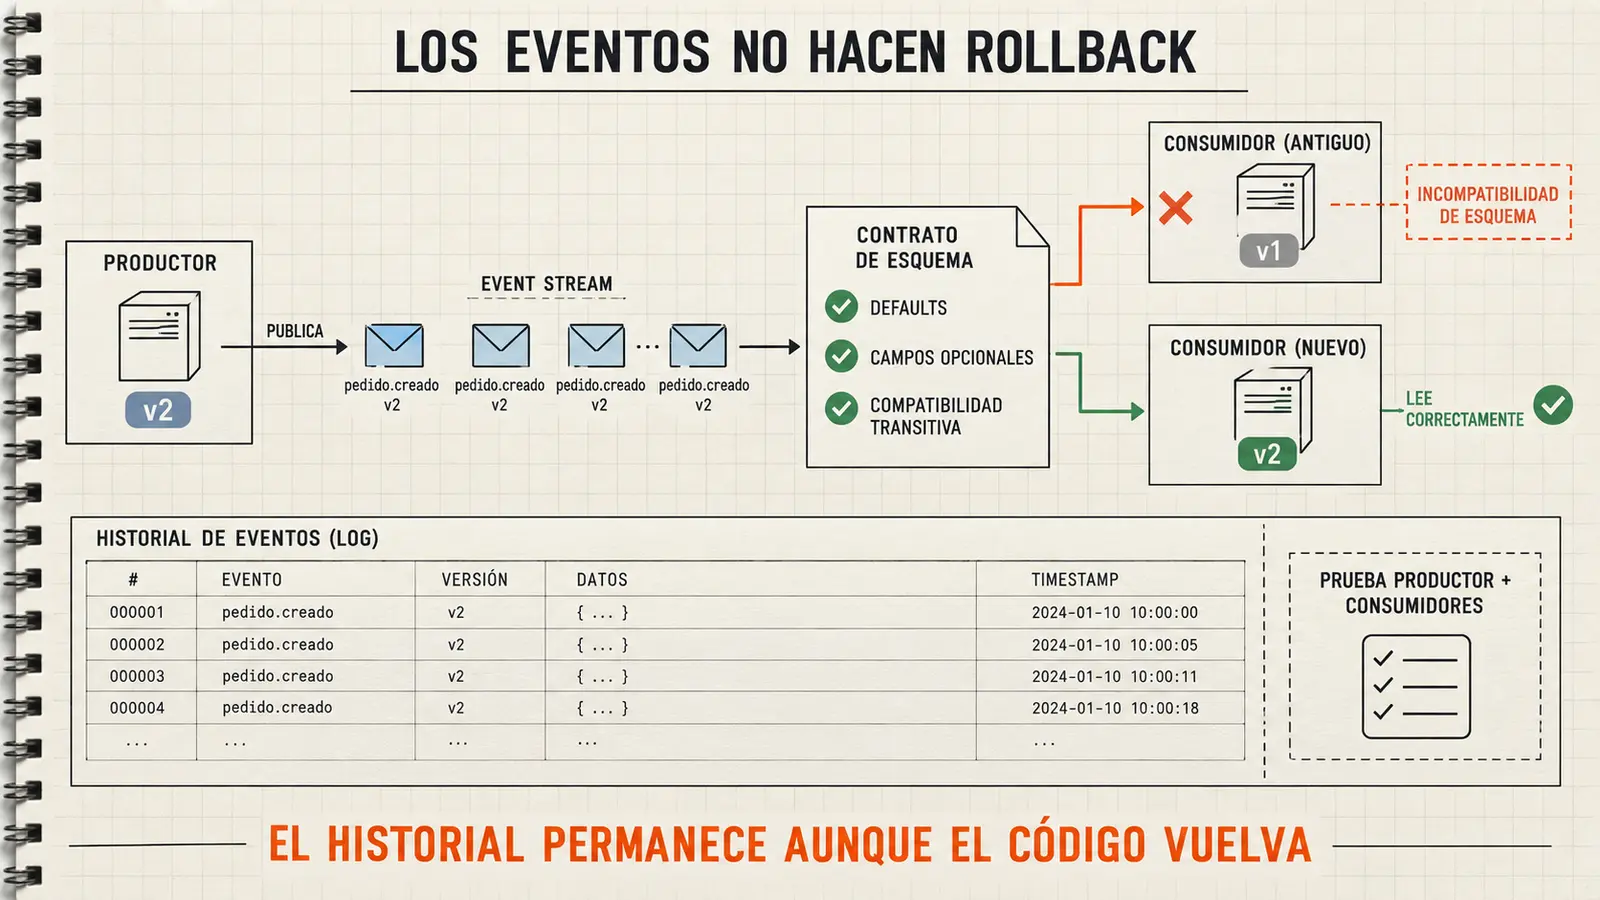
El rollback en producción no borra los eventos que ya publicamos
Imaginemos ahora un proceso que publica eventos. La versión nueva escribe un mensaje con un campo adicional, un significado distinto o una estructura incompatible. Minutos después detectamos un fallo y recuperamos el productor anterior.
El problema es que los mensajes que ya se publicaron siguen ahí. Algunos quizá todavía no han llegado al consumidor. Otros ya se han procesado. Restaurar el productor no borra la historia.
Los contratos también tienen una dirección
Cuando evolucionamos eventos o APIs, tenemos que preguntarnos si la versión antigua puede entender información escrita por la nueva y viceversa. Las definiciones de compatibilidad hacia atrás, hacia delante y transitiva están bien explicadas en la documentación de evolución de esquemas de Confluent.
No basta con que dos mensajes se puedan deserializar. También importa que signifiquen lo mismo para el negocio. Un campo opcional puede ser válido técnicamente y provocar una interpretación incorrecta en un consumidor antiguo.
Para reducir ese riesgo, me gusta llevar algunas preguntas a la revisión técnica: ¿qué pasaría si volviéramos hoy a la versión anterior?, ¿qué consumidores seguirían ejecutándose?, ¿podríamos reprocesar los mensajes?, ¿cómo distinguimos un reintento de una operación nueva?
Aquí aparece otro concepto importante: la idempotencia. Si una operación se reintenta porque hemos tenido un fallo a mitad del proceso, debemos evitar que el sistema genere el mismo efecto dos veces. Eso exige identificadores estables, controles de duplicidad y una política clara de reintentos.
Un retry no es automáticamente una solución. Si repetimos una operación no idempotente, podemos convertir un error temporal en dos operaciones de negocio.
Hay efectos que no podemos deshacer, pero sí compensar
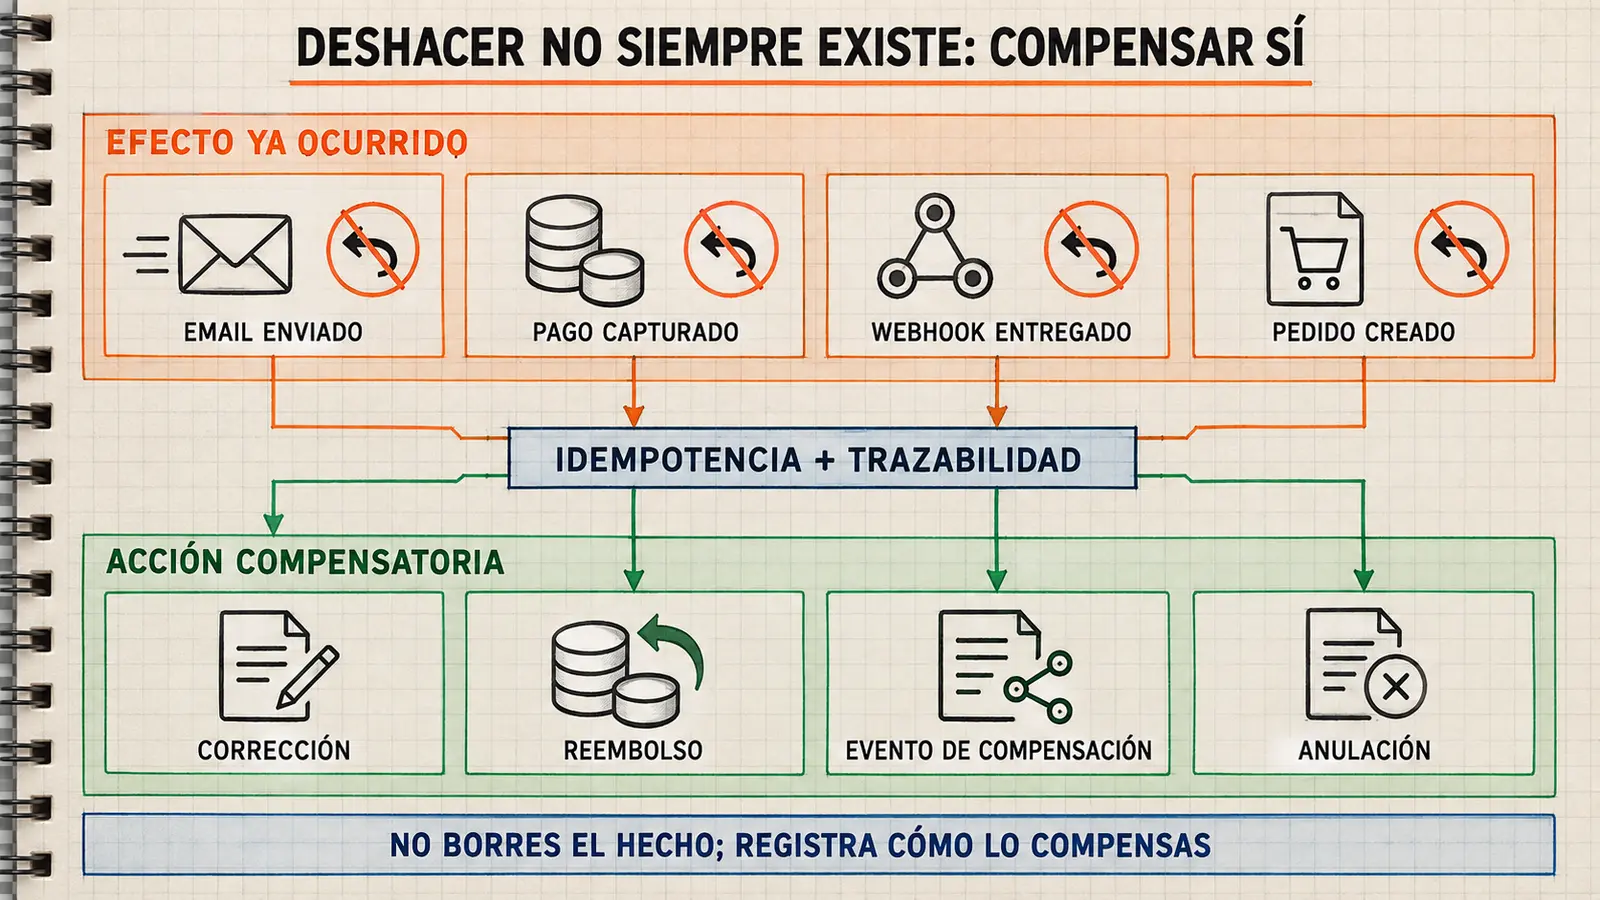
Esta es una de las partes más incómodas al diseñar un rollback en producción para sistemas conectados. Podemos revertir código, ajustar datos y reiniciar colas. Pero no podemos «desenviar» un correo que ya llegó, retirar de la memoria de otro sistema un webhook procesado ni fingir que una operación externa no ocurrió.
Por eso, en determinados flujos, la recuperación no consiste en deshacer literalmente lo anterior, sino en ejecutar una compensación trazable.
| Efecto que ya ocurrió | Posible respuesta | Qué deberíamos comprobar |
|---|---|---|
| Notificación incorrecta | Enviar una rectificación | Destinatarios, mensaje original y trazabilidad |
| Operación económica confirmada | Anulación o reembolso, según el estado | Identificador externo e idempotencia |
| Webhook recibido por un tercero | Publicar una corrección | Contrato y confirmación del receptor |
| Registro de negocio creado | Aplicar una transición compensatoria | Permisos, historial y reglas funcionales |
No siempre podremos automatizar todas estas acciones, y tampoco deberíamos hacerlo sin límites. Hay operaciones que requieren validación humana o un tratamiento específico por parte del negocio.
La idea útil es otra: si el sistema produce un efecto fuera de su propia base de datos, el plan de rollback en producción tiene que reconocerlo. Ignorarlo no hace que desaparezca.
No todos los fallos piden la misma respuesta
A veces utilizamos la palabra rollback como si fuera la salida obligatoria para cualquier problema. Yo cada vez lo veo más como una opción dentro de un conjunto de decisiones.
Si una funcionalidad está detrás de una feature flag y apagarla detiene el comportamiento defectuoso sin dejar un estado incompatible, desactivarla puede resultar más seguro que desplegar otra vez toda la aplicación.
Si la versión anterior ya no puede leer los datos o eventos nuevos, quizá tengamos que avanzar con una corrección (roll-forward) que preserve la compatibilidad. Y si el problema está en una operación externa, primero tendremos que contener el daño y después reconciliar o compensar.
Elegir sin improvisar
| Situación | Alternativa que conviene valorar | Condición clave |
|---|---|---|
| Regresión aislada sin cambios de estado | Desactivar una feature flag | Que apagarla esté probado |
| Error de código con datos compatibles | Recuperar la versión anterior | Que la versión anterior siga operativa |
| Nuevos datos incompatibles con el código antiguo | Roll-forward controlado | Que la corrección sea verificable |
| Efectos externos o estado incoherente | Contener y compensar | Que exista trazabilidad |
Para que el rollback en producción sea una opción real, lo importante es decidir el criterio antes del incidente. Si empezamos a debatir estas opciones mientras los usuarios esperan, llegamos tarde a una parte del trabajo.
También merece la pena pensar en despliegues progresivos. Los canary releases no arreglan mágicamente los problemas, pero nos permiten contrastar señales con un grupo limitado antes de exponer todo el tráfico. El SRE Workbook de Google explica bien cómo comparar la versión candidata con un grupo de control.
Ese margen de observación es especialmente útil cuando el despliegue afecta a un proceso importante, no solo a la salud de un contenedor.
Probar un rollback en producción vale más que diez procedimientos sin ejecutar
A veces tenemos un documento detallado y damos por supuesto que con eso basta. El problema aparece cuando intentamos seguirlo y descubrimos que la imagen anterior ya no está disponible, falta un permiso, una variable no coincide o nadie sabe cómo comprobar si el servicio ha recuperado el comportamiento esperado.
Para mí, un procedimiento empieza a demostrar su valor cuando alguien distinto de quien lo escribió consigue ejecutarlo y verificar el resultado.
Un ejercicio pequeño, pero completo
No propongo provocar fallos en producción sin control. Podemos empezar en un entorno representativo, con datos sintéticos, dependencias simuladas y una condición clara para detener el ejercicio. El objetivo no es poner en riesgo la operación, sino descubrir carencias antes de un incidente.
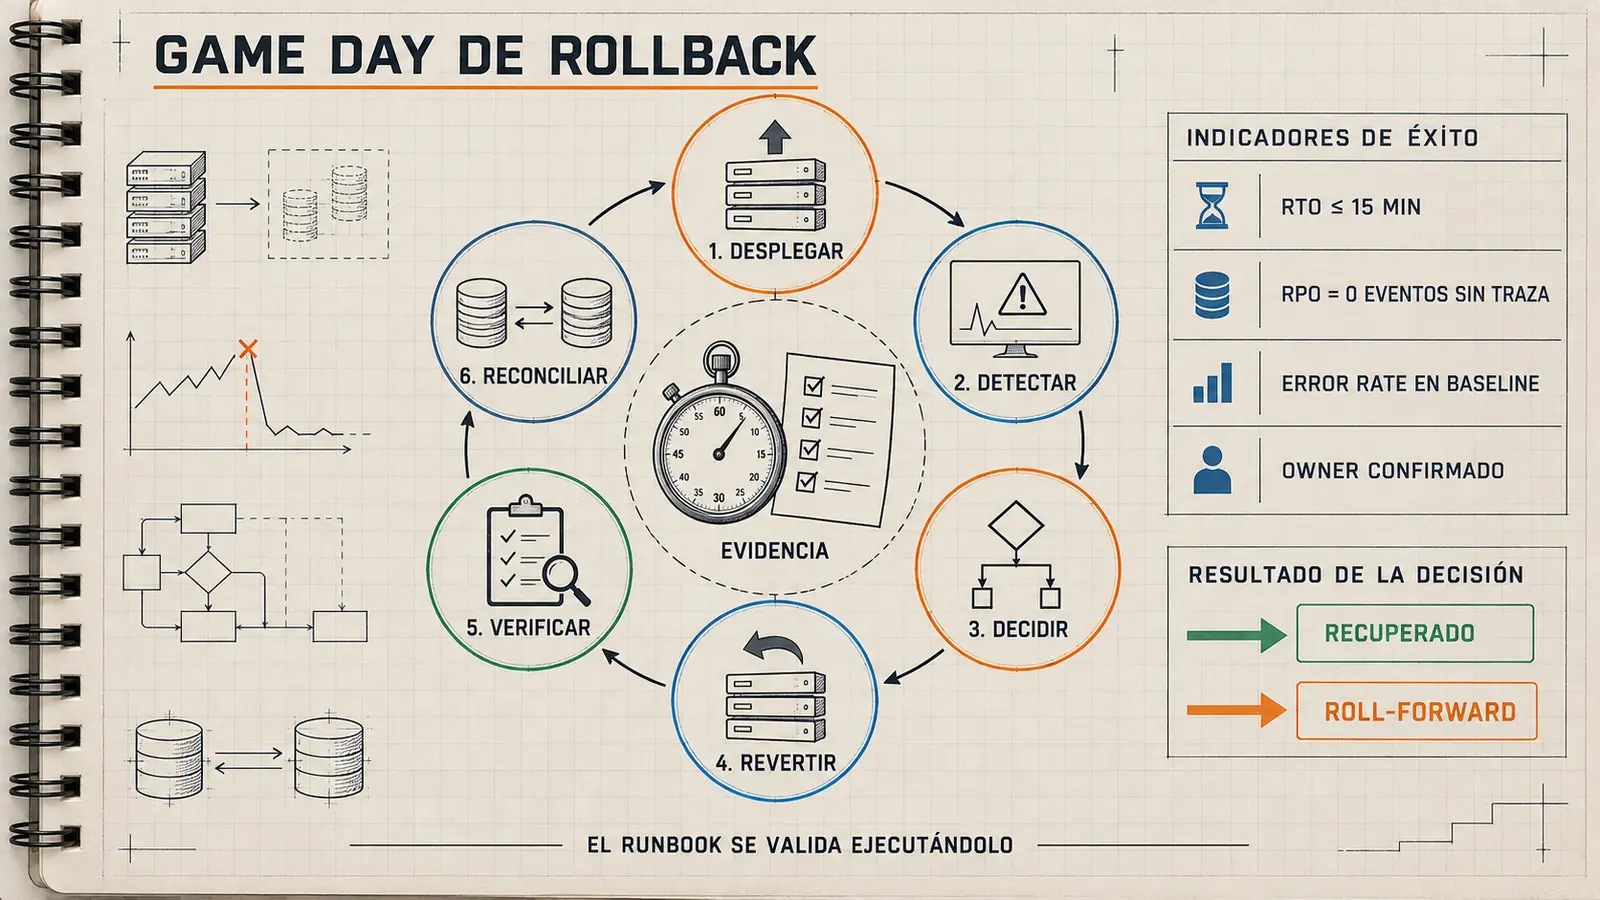
Un ejercicio razonable recorre estas etapas:
- Preparar una versión anterior disponible y un cambio de prueba acotado.
- Desplegar y provocar una condición de fallo controlada.
- Detectarla mediante las mismas métricas y avisos que utilizaríamos normalmente.
- Elegir entre rollback, desactivación de una flag y roll-forward según un criterio conocido.
- Ejecutar el procedimiento y verificar rutas críticas, datos y procesos pendientes.
- Registrar los bloqueos, las decisiones y el tiempo empleado.
Es fácil centrarse en que la aplicación vuelva a responder HTTP 200. Pero quizá una consulta importante ya no funciona, la cola sigue creciendo o una operación de negocio no termina. Necesitamos validar algo más que la disponibilidad superficial.
El runbook debe incluir una forma de comprobar el éxito
Después del ejercicio me gustaría poder responder, con evidencia, a estas preguntas: ¿qué versión está funcionando?, ¿qué migraciones se ejecutaron?, ¿qué datos nuevos escribimos?, ¿qué mensajes quedan pendientes?, ¿qué operaciones externas necesitan atención?, ¿qué transacciones críticas hemos validado?
Si no podemos responderlas, tal vez hemos probado que sabemos ejecutar una orden, pero no que sabemos recuperar un servicio.
Medir un rollback en producción sin obsesionarnos con los números
En ingeniería hablamos de RTO y RPO, especialmente en continuidad de negocio y recuperación ante desastres. La guía de planificación de recuperación de Google Cloud los utiliza para expresar límites de tiempo y pérdida de datos aceptables.
No son exactamente lo mismo que un rollback de aplicación, pero nos recuerdan algo valioso: expresiones como «volver rápido» o «sin perder nada» necesitan una definición operativa.
En una recuperación de aplicación conviene concretar el tiempo máximo hasta volver a prestar el servicio, la información que debe conservarse, las operaciones que pueden reintentarse y las verificaciones que acreditan que todo está coherente.
Una pequeña tarjeta antes de desplegar
No todos los cambios requieren un documento extenso. Para una modificación sensible bastaría con responder algo parecido a esto:
Cambio: nueva versión de una operación de negocio
Versión anterior disponible: sí, identificada por digest
Compatibilidad de datos: validada durante la transición
Señal de alerta: aumento sostenido de errores funcionales
Criterio de reversión: acordado con el responsable del servicio
Eventos pendientes: identificables y reprocesables
Verificación: recorrido crítico + coherencia de datos
Responsable: equipo de guardia / propietario del servicio
En un rollback en producción, esa tarjeta no sustituye la prueba. Sirve para que el equipo comparta expectativas y no tenga que inventar el criterio de éxito durante un problema.
También hay que distinguir entre una métrica técnica y una evidencia de negocio. Tener todos los contenedores «running» no demuestra que un pedido pueda completarse. El panel verde es una buena señal; nunca debería ser la única.
Mi checklist antes de confiar en un rollback en producción
No pretendo aplicar el mismo proceso a una corrección de texto que a una migración de datos. La profundidad del control debería seguir el riesgo y la dificultad de recuperar el estado. Pero, ante un cambio importante, comprobaría lo siguiente:
- Artefactos: ¿tenemos la versión anterior identificada y disponible?
- Configuración: ¿sabemos qué cambia y qué quedaría fuera del rollback?
- Base de datos: ¿el código antiguo sigue siendo compatible con el esquema y los datos nuevos?
- Eventos: ¿los consumidores toleran los mensajes generados durante la transición?
- Efectos externos: ¿sabemos qué se puede compensar y qué requiere intervención?
- Observabilidad: ¿podemos detectar un problema real para el usuario?
- Procedimiento: ¿quién ejecuta la recuperación y con qué permisos?
- Prueba: ¿cuándo ensayamos el recorrido por última vez?
Hay un detalle que añado cada vez con más insistencia: la capacidad de recuperar un despliegue no debería depender de que una única persona recuerde la secuencia de pasos. Una buena documentación y un ejercicio compartido también son una forma de reducir dependencias dentro del equipo.
Lo que he aprendido trabajando con sistemas que tienen historia
Cuando mantienes software empresarial con años de evolución, no siempre puedes cambiar todo lo que te gustaría en el orden que preferirías. Hay instalaciones antiguas, integraciones y decisiones que respondían a necesidades concretas. A veces toca convivir con esas restricciones mientras preparas un camino mejor.
La tentación es pensar que introducir contenedores, un pipeline o más automatización nos resuelve de golpe el despliegue. Son avances importantes, pero la modernización operativa empieza cuando sabemos cómo recuperarnos de nuestros propios cambios.
Por eso este tema conecta tanto con lo que hemos estado haciendo últimamente: pruebas, revisiones de código, documentación y despliegues reproducibles. Todo suma. Las pruebas nos ayudan a descubrir regresiones; las revisiones hacen visibles los riesgos; el despliegue repetible facilita ejecutar cambios; y el plan de recuperación nos permite afrontar los fallos sin improvisarlo todo.
Hace poco escribí sobre modernizar software sin perder lo que funciona. Si tuviera que añadir una idea a aquel artículo, sería esta: modernizar también significa saber cuándo detener una evolución y cómo volver a una situación operativa segura.
No necesitamos convertir cada publicación en un gran proyecto de resiliencia. Sí necesitamos que las operaciones críticas tengan un plan proporcionado a su impacto y que ese plan haya pasado por una prueba realista.
Preguntas que siempre aparecen
¿Volver a la imagen Docker anterior es suficiente?
Solo si los datos, la configuración y las dependencias mantienen compatibilidad con esa imagen. Reutilizar un contenedor anterior no revierte por sí solo escrituras, migraciones ni operaciones externas.
¿Un rollback de Helm deshace también las migraciones?
No por defecto. Helm restaura una revisión de la release; las migraciones y los efectos persistentes requieren un procedimiento independiente o una estrategia de compatibilidad. Los hooks personalizados pueden ejecutar acciones, pero no garantizan una reversión segura de datos.
¿Siempre conviene hacer rollback y no roll-forward?
No. Si el estado actual ya es incompatible con la versión anterior, una corrección pequeña y validada puede ser más segura. La decisión depende del daño potencial, el tiempo de recuperación y la capacidad de verificar la operación.
¿Cómo se prueba sin afectar a los usuarios?
Se empieza en un entorno representativo con datos sintéticos o simulados, se mide el recorrido y se corrigen las carencias. Cualquier ejercicio en producción exige control explícito del impacto, responsables y condiciones de cancelación.
La prueba definitiva no es pulsar un botón
Cada vez me convence menos una frase como «tranquilos, tenemos rollback» cuando no va acompañada de alguna evidencia.
Prefiero algo más sencillo: saber qué versión podemos recuperar, qué cambios son compatibles, qué datos hay que revisar, quién puede ejecutar el procedimiento y cuándo lo ensayamos por última vez.
Puede que nunca tengamos que usar ese camino de vuelta. Ojalá. Pero si llega el día, será mucho mejor disponer de una capacidad comprobada que descubrir, con el servicio afectado, que solo teníamos un comando apuntado en un documento.
Un rollback que nunca has probado no es un rollback. Es un plan que todavía no sabemos si funciona.
Deja una respuesta