ARQUITECTURA · SISTEMAS LEGACY · APIS · SEGURIDAD · DEVOPS
Una API para sistemas legacy puede abrir nuevas posibilidades a un ERP que lleva años sosteniendo una empresa. Pero exponer una funcionalidad no debería significar publicar la base de datos, revelar la red interna o conceder a un tercero más permisos de los necesarios. La arquitectura importa tanto como el endpoint.
Durante los últimos meses he vuelto a trabajar con aplicaciones veteranas que necesitan hablar con servicios actuales. Algunas se ejecutan en servidores propios; otras dependen de bases de datos o protocolos que rara vez aparecen en los tutoriales modernos. No son sistemas inútiles. De hecho, suelen contener las reglas y la información de las que depende buena parte de la actividad diaria. El problema llega cuando pedimos a esa infraestructura que se comporte como una plataforma de integración diseñada hoy.
La tentación es comprensible: abrir un puerto, escribir un pequeño servicio REST, configurar un DNS y dar el problema por resuelto. Sobre el papel ya tenemos una API. En producción, quizá acabamos de crear una entrada innecesaria a un sistema que nunca estuvo preparado para recibir tráfico externo.
En este artículo propongo un enfoque que utilizo como criterio de diseño: modernizar el borde sin forzar una exposición del núcleo. Veremos arquitectura, FastAPI, Docker Compose, Nginx, túneles, VPN, autorización contextual, contratos, observabilidad y decisiones operativas. Los ejemplos son didácticos y no reproducen credenciales, infraestructuras ni configuraciones internas de clientes.
API para sistemas legacy: el falso atajo de abrir un puerto
Imaginemos una empresa con un ERP que controla artículos, existencias, tarifas y pedidos. Necesita conectar un portal B2B, una tienda online o una aplicación móvil. El ERP funciona, pero su arquitectura es anterior a la proliferación de las APIs públicas: tal vez tenga formularios de escritorio, acceso por ODBC, una base relacional con cientos de tablas y procesos de negocio que solo conocen quienes llevan años manteniéndolo.
Una integración rápida podría consistir en permitir conexiones externas a la base de datos. El desarrollador del otro sistema obtiene credenciales y consulta las tablas que necesita. El primer día todo funciona. El segundo también. Hasta que cambia una columna, se cruza la información de dos empresas, una consulta bloquea un proceso o una contraseña compartida acaba en un registro al que no debería haber llegado.
La alternativa no es esconderlo todo detrás de una URL bonita. Si un endpoint ejecuta SQL arbitrario o usa un usuario con privilegios de administrador, el riesgo se ha desplazado, no eliminado. Una API segura no es solo una forma distinta de transportar las mismas consultas; tiene que mediar entre dos modelos de confianza.
Me interesa separar cuatro preguntas que a menudo se mezclan: ¿qué funcionalidad necesitamos compartir?, ¿quién podrá invocarla?, ¿cómo alcanzará técnicamente al sistema heredado? y ¿qué sucederá cuando algo falle? Las respuestas no pertenecen a la misma capa. Si las resolvemos con un único mecanismo —por ejemplo, una VPN—, habrá controles que ni siquiera llegaremos a plantearnos.
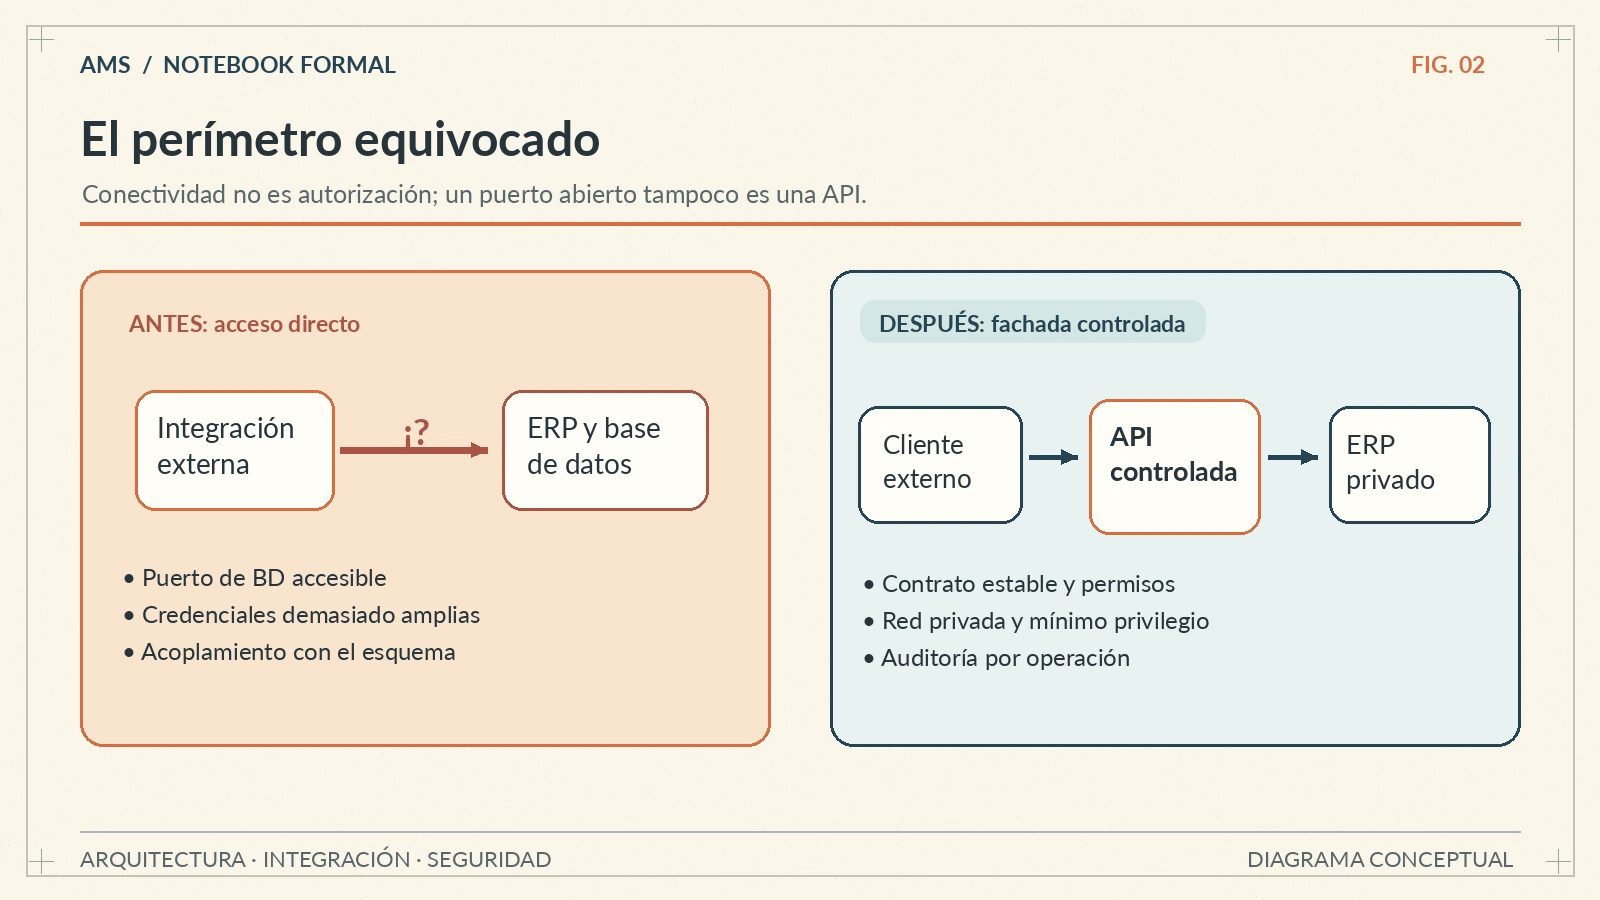
Punto crítico: que el puerto de una base de datos no sea accesible desde Internet es una condición necesaria en muchos despliegues, pero no garantiza por sí misma que la API sea segura. Hay que revisar también identidad, permisos, entradas, salidas y dependencias.
Antes de diseñar una API para sistemas legacy, define el contrato
Los primeros endpoints de una API para sistemas legacy suelen diseñarse mirando tablas: /clientes, /articulos, /stock. Es natural, porque son nombres cercanos a la estructura que conocemos. Sin embargo, un contrato que copia exactamente el modelo de datos convierte al consumidor en rehén de la implementación interna. Al mínimo cambio del ERP aparecen regresiones y adaptaciones de urgencia.
Prefiero empezar con casos de uso. Un comercio necesita consultar el catálogo comercializable, no cada campo de la ficha del artículo. Una aplicación de reparto necesita conocer el estado logístico autorizado, no la contabilidad del pedido. Un panel de gestión necesita indicadores agregados, no acceso indiscriminado a las transacciones originales.
La diferencia parece semántica, pero es estructural: el contrato habla el lenguaje de la integración; el conector traduce ese lenguaje al del ERP. Puede existir un campo que sea obligatorio internamente y no deba salir. Puede haber estados que convenga normalizar y otros que no debamos reinterpretar. El adaptador es el lugar para explicitar esas decisiones.
- Alcance funcional: operaciones de lectura, consulta incremental y, cuando proceda, comandos de escritura.
- Propiedad del dato: quién mantiene el artículo, precio, pedido o cliente; qué sistema acepta modificaciones.
- Semántica: identificadores estables, unidades, impuestos, estados, moneda, empresa y delegación.
- Errores: qué significa no encontrado, conflicto, indisponible o petición inválida.
- Evolución: esquema OpenAPI, versiones compatibles, ejemplos y política de retirada.
En organizaciones con varias empresas o instancias, la pertenencia de un recurso a una empresa no puede quedar al criterio de quien consuma la API. La identidad del consumidor debe relacionarse con un ámbito de datos autorizado en el servidor. Un identificador recibido en la URL jamás es, por sí solo, una prueba de autorización.
Arquitectura de una API para sistemas legacy: un borde moderno y un núcleo privado
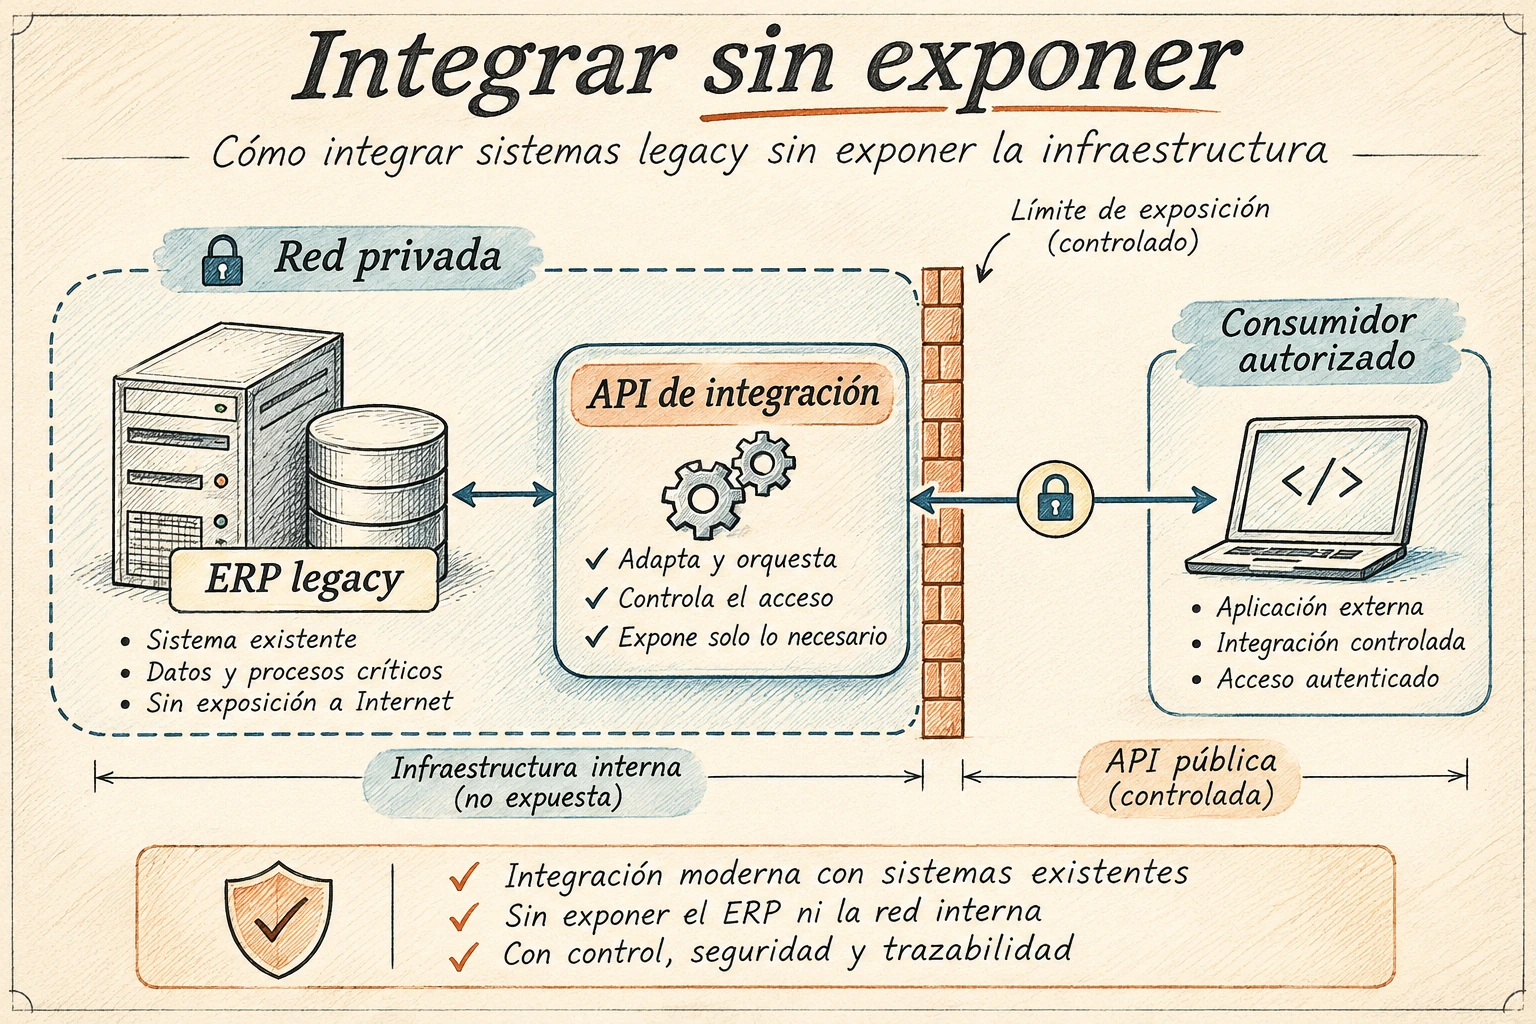
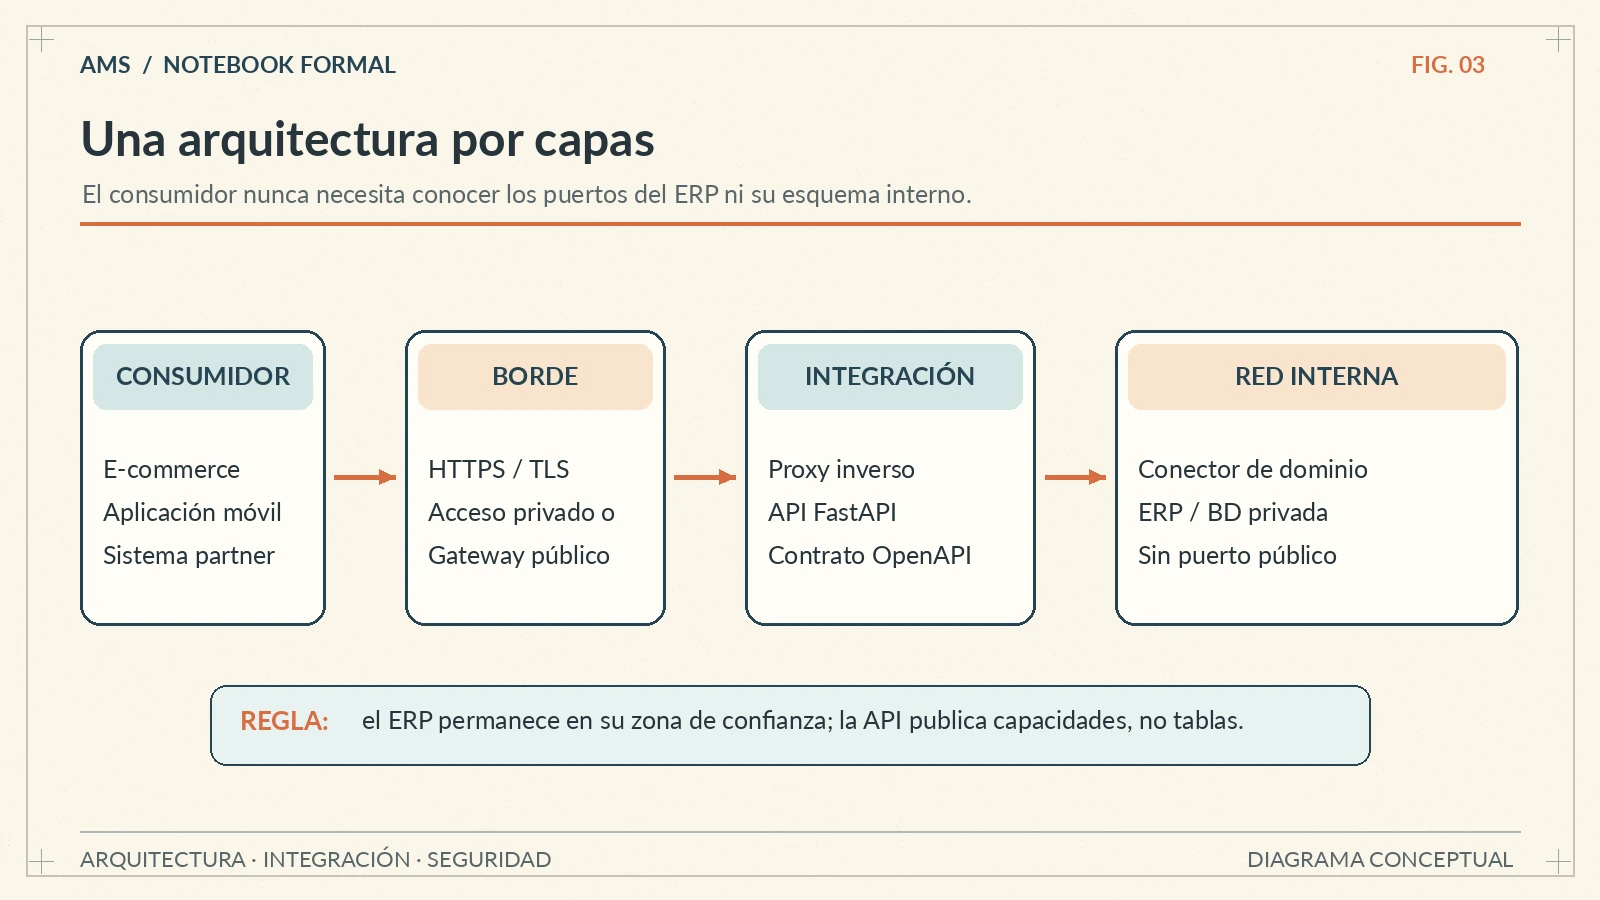
La arquitectura que suelo plantear distingue al menos cuatro zonas. La primera es el consumidor, que puede ser una tienda, un sistema de terceros o una aplicación de nuestra organización. La segunda es el borde de conectividad y acceso. La tercera es el servicio de integración, donde vive el contrato público, la autorización de operaciones y la traducción de dominio. La última es el sistema heredado, que conserva su despliegue, sus credenciales internas y sus procedimientos de negocio.
No hay que confundir aislamiento con inaccesibilidad. La API sí necesita un camino controlado hasta el ERP: una red interna, una pasarela específica, un servicio de aplicación autorizado o un acceso de solo lectura. Lo que no necesita es que cualquier consumidor conozca el direccionamiento, los puertos y el esquema de ese ERP.
Cuando el sistema ofrece operaciones de negocio internas utilizables, lo prudente es apoyarse en ellas. Si solo existe acceso a datos, la capa de adaptación debe ser más conservadora todavía. Una consulta directa puede reproducir sin querer una regla empresarial incompleta; una escritura puede saltarse validaciones que la interfaz clásica sí aplica. El hecho de que un UPDATE funcione no significa que represente una operación válida.
El patrón de fachada: una frontera deliberada
Esta capa puede describirse como una fachada o un anticorruption layer. No tiene que reemplazar al ERP ni replicar todos sus módulos. Su función es hacer explícito el límite entre un sistema que conoce el negocio y otro que necesita consumir una capacidad concreta. Para un equipo pequeño, eso puede materializarse en un servicio monolítico bien organizado por dominios. Crear veinte microservicios para consultar veinte tablas casi siempre añade complejidad sin aportar aislamiento real.
La fachada tampoco debería transformarse en una segunda fuente de verdad por accidente. Si necesita una caché o una proyección de lectura, hay que documentar su caducidad, el retraso aceptable y cómo se recupera de una sincronización perdida. Una arquitectura que parece sencilla cuando todo funciona puede ser muy difícil de operar cuando dos sistemas discrepan.
FastAPI como fachada: pequeño ejemplo, límites claros
FastAPI resulta útil para esta clase de servicio cuando el entorno y el equipo encajan con Python. Ofrece validación con Pydantic, documentación OpenAPI y una separación cómoda de dependencias. Pero elegir un framework moderno no convierte automáticamente en fiable un conector antiguo. La parte delicada suele estar en las consultas, los tipos de datos, los códigos de error, los bloqueos y las reglas de negocio.
Consideremos un endpoint de consulta de artículos por código. Una petición correctamente autorizada devuelve un modelo público pequeño. El conector lee únicamente los datos de la empresa permitida al consumidor. El ejemplo es intencionadamente parcial: la función require_partner pertenece a un módulo de seguridad real y debe validar firma, emisor, audiencia, expiración y scopes del token; no sería correcto sustituirla por una comparación ingenua de cadenas.
from fastapi import APIRouter, Depends, HTTPException
from pydantic import BaseModel
from .auth import Principal, require_partner
from .services import CatalogService, get_catalog

router = APIRouter(prefix="/v1/catalogo", tags=["catalogo"])

class ArticuloPublico(BaseModel):
    codigo: str
    nombre: str
    disponible: bool

@router.get("/{codigo}", response_model=ArticuloPublico)
def consultar_articulo(
    codigo: str,
    principal: Principal = Depends(require_partner),
    catalogo: CatalogService = Depends(get_catalog),
):
    # La empresa proviene de la identidad validada,
    # no de un parámetro elegido por el cliente.
    articulo = catalogo.buscar(
        empresa_id=principal.empresa_id,
        codigo=codigo,
        permisos=principal.scopes,
    )
    if articulo is None:
        raise HTTPException(status_code=404, detail="No encontrado")
    return ArticuloPublico.model_validate(articulo)
Lo importante del fragmento no es la sintaxis. Es que el cliente no puede decidir libremente qué empresa consultar, que el modelo de salida evita filtrar columnas internas y que las operaciones de negocio se encapsulan. En el servicio real añadiremos validación de permisos por recurso, límites de paginación, timeouts y pruebas sobre los casos que el ERP considera excepcionales.
Una consulta SQL también necesita contexto
Al construir una API para sistemas legacy es habitual encontrar claves compuestas, empresas repartidas entre esquemas o registros cuyo identificador solo es único dentro de una delegación. Si publicamos GET /clientes/42 sin representar ese contexto, abrimos la puerta a errores graves que pueden no aparecer durante las pruebas básicas.
-- Ejemplo ilustrativo con parámetros; nunca concatenar entradas
SELECT codigo, nombre_comercial, activo
FROM clientes
WHERE empresa_id = ?
  AND codigo = ?
  AND activo = 1
En un conector ODBC, los parámetros deben vincularse con el mecanismo del driver y la cuenta de base de datos debe disponer únicamente de las operaciones necesarias. Si el producto tiene un motor de negocio propio, este sigue teniendo prioridad sobre escribir directamente en sus tablas. Y si no existe otra vía, documentaremos de forma explícita qué invariantes estamos asumiendo.
La regla del adaptador: el contrato externo no debe saber cómo se llaman las tablas internas. Una API que filtra SQL o estructuras internas con otro envoltorio no ha desacoplado los sistemas.
Identidad, autorización y mínimo privilegio: el trabajo que no hace la VPN
Una VPN responde principalmente a una pregunta de conectividad: qué equipos o redes pueden comunicarse. Un túnel responde a cómo transportar tráfico entre dos extremos. Un reverse proxy ayuda a centralizar la entrada. Ninguno de esos mecanismos sustituye la decisión de si una identidad concreta puede consultar el pedido de una empresa determinada.
En integraciones máquina a máquina suele tener sentido utilizar OAuth 2.0 con client credentials y tokens de acceso acotados, mTLS en entornos donde podamos gestionar certificados o un proveedor de identidad corporativo. Una API key puede ser aceptable en ciertos escenarios, pero exige rotación, almacenamiento seguro, limitación de permisos y vigilancia; nunca debería ser una contraseña universal del ERP.
La autorización tiene varias dimensiones. Primero, la capacidad: ¿el cliente puede leer catálogo o modificar pedidos? Después, el objeto: ¿ese pedido pertenece al ámbito que tiene autorizado? Por último, el estado: ¿se permite cancelar un documento ya expedido o modificar un pedido cerrado? Esta última decisión pertenece al dominio y no debe inferirse solo de un rol.
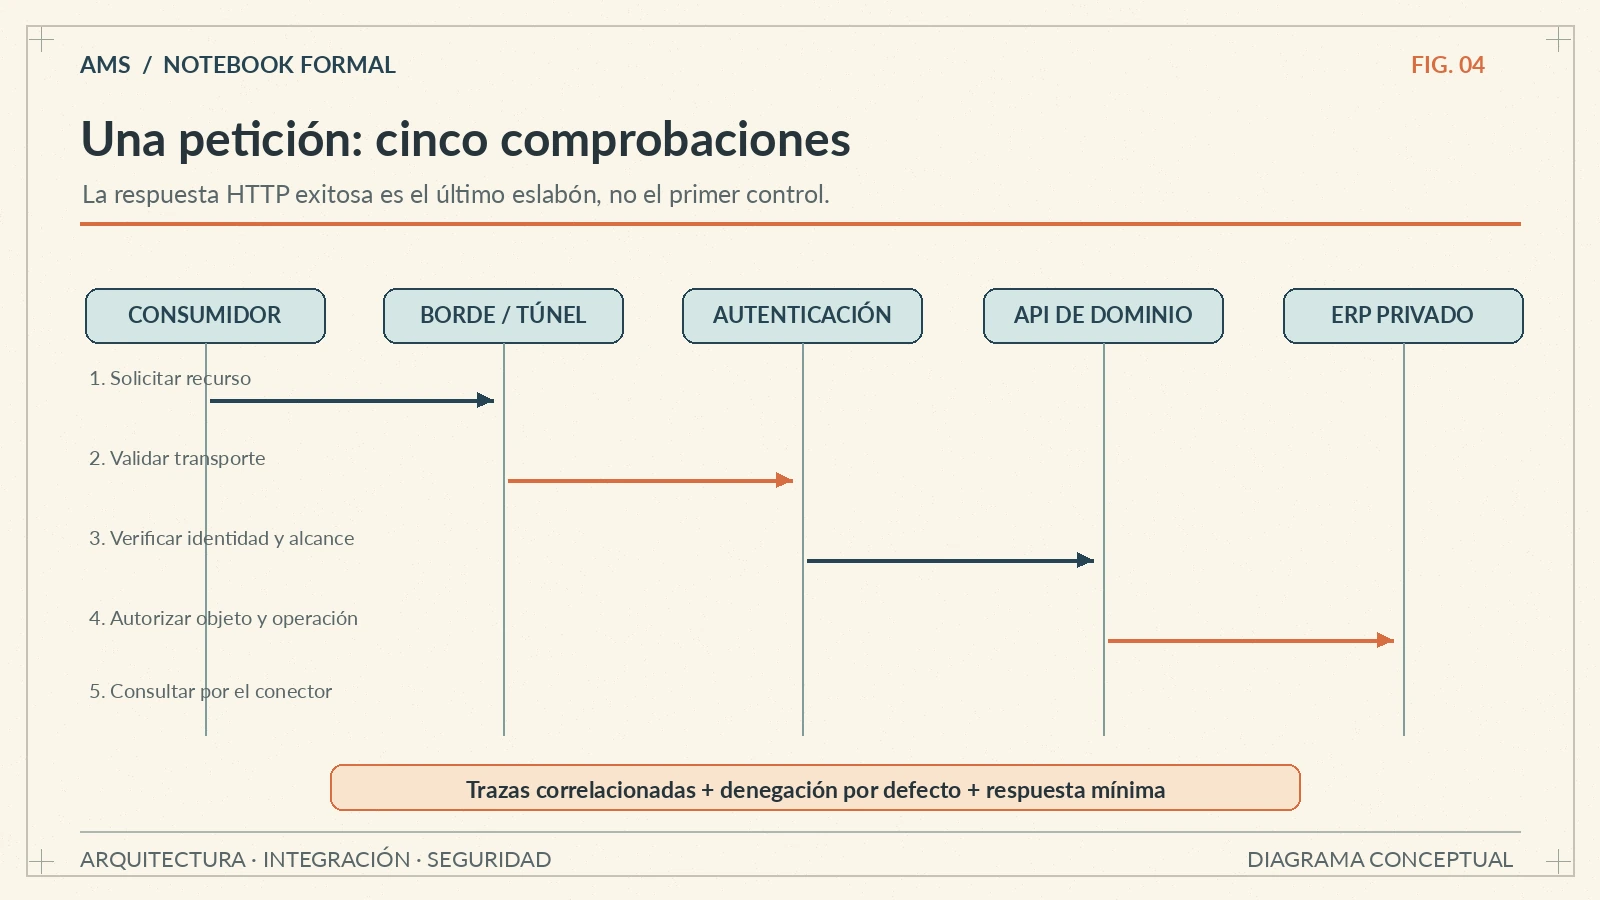
En las revisiones de seguridad conviene recordar las categorías de OWASP API Security Top 10, especialmente la autorización por objeto (BOLA), la autenticación y la gestión del inventario de endpoints. Los problemas reales no suelen limitarse a contraseñas filtradas: aparecen cuando el sistema concede más información o más acciones de las que corresponden.
- Denegación por defecto: un permiso no declarado no está concedido.
- Segregación de funciones: lectura de catálogo y alta de pedidos no necesitan la misma identidad.
- Scopes por integración: evitar cuentas genéricas compartidas entre varios socios.
- Auditoría útil: quién, qué recurso, cuándo, resultado y correlación, sin incluir secretos ni datos personales innecesarios.
- Revocación practicable: saber deshabilitar una integración sin detener todo el ERP.
Docker Compose: aislar servicios no es publicar todos sus puertos
Contenerizar la capa de integración simplifica despliegues y dependencias, pero Docker no debe confundirse con un firewall mágico. Cuando declaramos ports: ["8000:8000"], el puerto publicado puede quedar enlazado a todas las interfaces del host. Este comportamiento se documenta expresamente en la guía de Docker sobre publicación de puertos. Tener un cortafuegos activo no garantiza por sí solo que todas las reglas se apliquen como esperamos a los puertos gestionados por Docker.
Para una fachada accesible únicamente desde un reverse proxy local, podemos publicar el proxy en 127.0.0.1 y mantener el servicio API dentro de la red de contenedores. Es un ejemplo de arquitectura, no un fichero completo listo para producción: las imágenes, versiones, secretos, cabeceras y topología deben adaptarse al entorno real.
services:
  api:
    image: ejemplo/fachada-erp:1.0.0
    restart: unless-stopped
    expose:
      - "8000"
    networks:
      - integracion
      - legacy
    read_only: true
    security_opt:
      - no-new-privileges:true

  proxy:
    image: nginx:stable-alpine
    restart: unless-stopped
    ports:
      - "127.0.0.1:8080:80"
    volumes:
      - ./nginx.conf:/etc/nginx/conf.d/default.conf:ro
    networks:
      - integracion
    depends_on:
      - api

networks:
  integracion:
  legacy:
    # Úsala como internal solo si el conector y
    # el recurso heredado viven en esa red.
    internal: true
Aquí expose no publica la API en el host: deja constancia del puerto de servicio dentro de Compose. El proxy sí publica una entrada, pero limitada a loopback. Una red declarada internal es útil para recursos que se comunican dentro de Docker; no debemos activarla a ciegas cuando el conector necesita alcanzar una base de datos situada en otra red física. En ese caso diseñaremos la ruta y las reglas de salida de forma explícita.
El fichero .env no decide por sí solo el perímetro
He visto configuraciones con .env.dev, .env.stg y .env.prod muy ordenadas, pero con un único Compose que publicaba el mismo puerto en todos los entornos. Cambiar APP_ENV=prod no elimina automáticamente un ports ya definido. La política de exposición debe expresarse en la configuración efectiva del despliegue.
Podemos separar un Compose base de otro override específico para los pocos entornos que necesiten publicar un endpoint, o utilizar una configuración de borde distinta. Antes de arrancar, conviene inspeccionar el resultado con docker compose config, revisar docker ps y probar la conectividad desde una máquina que no esté en la red de confianza. Las intenciones escritas en YAML no sustituyen a la verificación.
Comprobación que merece cinco minutos: si un servicio de base de datos aparece publicado como 0.0.0.0:3306 o similar, hay que verificar inmediatamente quién puede alcanzarlo. expose, ports y las reglas de firewall resuelven problemas diferentes.
Nginx y la frontera HTTP: sencillo no significa sin estado
Un reverse proxy permite centralizar rutas, encabezados, límites de tamaño y parte de la telemetría. También evita que el consumidor tenga que conocer los cambios de puerto de la aplicación. En proyectos con un solo servicio no siempre necesitamos una plataforma de API Management: un proxy correctamente mantenido y una aplicación con buen control de acceso pueden ser suficientes.
Este fragmento representa un Nginx que recibe tráfico desde una entrada local controlada y lo reenvía a FastAPI. El HTTPS público debe terminar en un componente previsto para ello, como el gateway de entrada, y el trayecto restante debe seguir el modelo de confianza elegido. En una conexión de red no confiable, cifrar también el tramo entre el gateway y el origen resulta esencial.
server {
    listen 80;
    server_name _;

    client_max_body_size 1m;
    proxy_read_timeout 20s;

    location / {
        proxy_pass http://api:8000;
        proxy_set_header Host $host;
        proxy_set_header X-Request-ID $request_id;
        proxy_set_header X-Forwarded-Proto $scheme;
    }
}
En FastAPI hay otra precaución: los encabezados X-Forwarded-* solo deben considerarse confiables cuando proceden de proxies configurados como tales. Dejar que un cliente externo fuerce cabeceras de origen o esquema puede provocar URLs erróneas y problemas de seguridad. La documentación oficial de FastAPI detrás de un proxy explica esta distinción.
No metería autenticación exclusivamente en Nginx si el dominio exige autorización por registro o empresa. Un gateway puede rechazar conexiones no autenticadas y aplicar límites globales, pero la aplicación es quien conoce si el pedido 123 corresponde a esa organización y si la operación está permitida en su estado actual.
VPN, túnel saliente o HTTPS público: qué elegir y por qué
Al diseñar una API para sistemas legacy, la pregunta que suele aparecer en las reuniones es «¿lo hacemos con una VPN o con un túnel?». Mi respuesta inicial no suele ser una marca ni una herramienta. Pregunto quién es el consumidor, si controlamos ambos extremos, cuántos terceros participarán, qué disponibilidad se exige y quién operará la conectividad dentro de un año.
La VPN tiene sentido para relaciones estables entre redes o equipos gestionados, siempre que el enrutamiento, los permisos y la segmentación estén bien resueltos. Un túnel saliente permite que un conector dentro de la infraestructura establezca la conexión hacia un servicio de borde, evitando abrir puertos entrantes. Una API expuesta mediante HTTPS público puede ser correcta cuando la interoperabilidad lo requiere, pero necesita controles de entrada, abuso, identidad y monitorización acordes con su exposición.
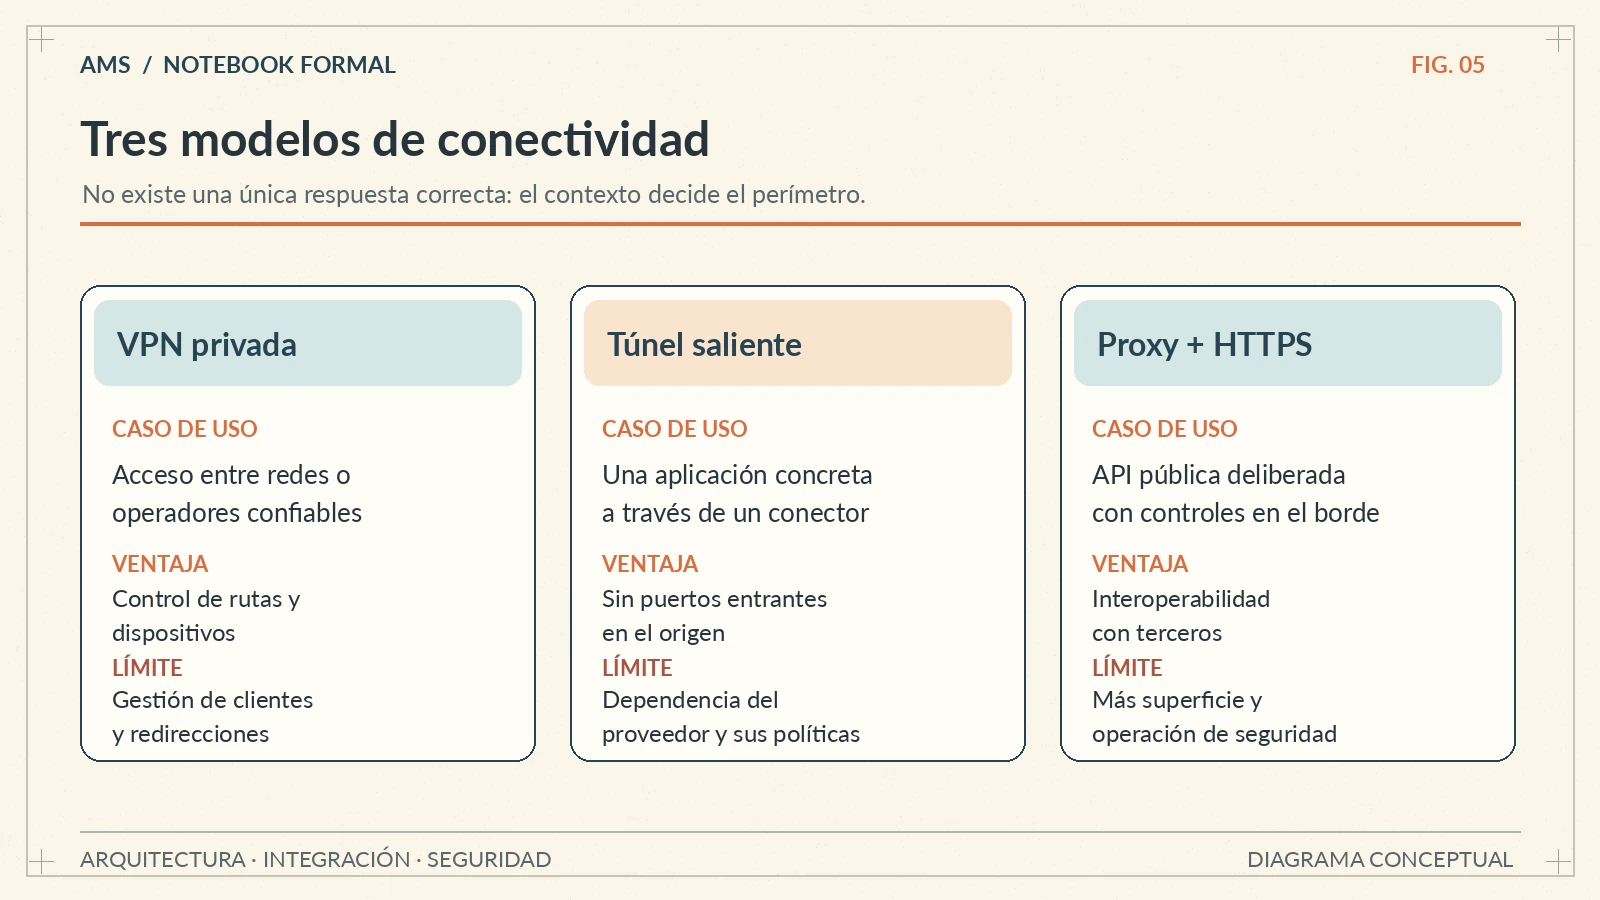
| Opción | Cuándo encaja | Qué no resuelve sola |
|---|---|---|
| VPN privada | Intercambio entre organizaciones o redes administradas. | Permisos por recurso, auditoría de negocio y calidad del contrato. |
| Túnel saliente | Publicar un servicio sin aceptar conexiones entrantes al origen. | Autenticación y autorización de cada llamada si se crea un hostname alcanzable. |
| Proxy HTTPS público | Integraciones con muchos consumidores externos o necesidades estándar de Internet. | Gobierno de tokens, límites, protección de abuso y revisión continua. |
Cloudflare Tunnel es un ejemplo conocido de conectividad saliente: su documentación oficial explica que los conectores inician las conexiones desde la red privada. Eso reduce la necesidad de reglas de entrada, pero publicar una aplicación a través del túnel puede hacerla alcanzable por un hostname público. Para limitar quién entra hace falta configurar controles de acceso y, además, conservar la autorización propia de la API.
Antes de elegir un proveedor debemos revisar latencia, residencia y tratamiento de los datos, soporte, dependencia externa, operación durante cortes, observabilidad y posible salida futura. No todo tráfico debería circular por un intermediario. Y no todas las integraciones requieren una VPN de red completa: a veces conceder acceso a una aplicación concreta minimiza mucho mejor el riesgo.
Los datos empresariales no se reducen a SELECT y JSON
Una de las mayores dificultades de trabajar con software de gestión no está en exponer recursos HTTP. Está en transportar significado. Un campo de stock puede representar existencia física, disponible comercial, reservado o pendiente de recepción. Una tarifa puede ser general, negociada, dependiente de la delegación o expresada sin impuestos. Publicar el número equivocado puede ser técnicamente correcto y operativamente desastroso.
Por eso el contrato necesita ejemplos de negocio, no solo esquemas. Un test debería comprobar qué ocurre con un artículo anulado, un cliente bloqueado, un precio sin impuestos y una referencia sin existencias. También con los datos que parecen casi correctos: códigos con ceros a la izquierda, decimales transformados por el driver, fechas locales sin zona horaria e identificadores reciclados entre empresas.
Cuando hay un sistema de destino, acordaría un mapa de autoridad: quién modifica cada campo, qué hacemos con las divergencias y qué eventos obligan a reconciliar. Un endpoint puede responder en 20 milisegundos y seguir difundiendo datos desactualizados. La velocidad de respuesta no mide la calidad de una integración.
Regla de diseño: un contrato de datos incluye semántica, propiedad y frescura. Si solo definimos nombres y tipos, hemos documentado el transporte, no la integración.
Este punto conecta directamente con otra idea que ya he desarrollado en el blog: modernizar software sin perder lo que funciona. El reto no es sustituir toda la experiencia acumulada por una arquitectura más reciente; es conservar sus reglas y mejorar la forma en que otros sistemas pueden utilizarlas.
Lecturas, escrituras y operaciones que no deben repetirse
Mi propuesta para empezar suele ser deliberadamente conservadora: primero consultas acotadas y trazables, después sincronizaciones y solo entonces operaciones que cambian el estado del negocio. Cada escalón aumenta las consecuencias de un error. Una lectura mal diseñada puede filtrar información o sobrecargar el ERP. Una escritura mal diseñada puede duplicar una factura, alterar existencias o dejar documentos en un estado incoherente.
En operaciones de creación o confirmación debemos abordar la idempotencia. Si el consumidor envía una petición, no obtiene respuesta por un timeout y vuelve a intentarlo, no podemos suponer que el primer intento no se ejecutó. El sistema debe reconocer el intento lógico, por ejemplo mediante una clave de idempotencia asociada a la operación y al consumidor, y conservar una respuesta coherente. No basta con añadir una cabecera si el procesamiento no es transaccional.
También hay que distinguir los reintentos seguros de los peligrosos. Las consultas suelen poder reintentarse con límites, backoff y circuit breaking; una orden que genera un efecto económico necesita condiciones mucho más estrictas. Documentaría qué códigos puede reintentar el cliente, durante cuánto tiempo y cómo consultar el estado final sin volver a crear la operación.
La transacción sigue siendo responsabilidad del dominio
Cuando una operación implica varias tablas heredadas, un endpoint REST no resuelve de forma automática la atomicidad. El adaptador debe invocar la lógica transaccional disponible o implementar una unidad de trabajo compatible con el motor. En un sistema antiguo, aparentemente pequeño, esto puede ser uno de los motivos más sólidos para empezar con endpoints de lectura antes de habilitar operaciones de escritura.
Observabilidad: saber quién pidió qué y qué ocurrió después
Una API puede devolver 200 OK y haber interpretado mal una tarifa. También puede devolver 504 mientras la operación se completó en el ERP. Por eso no me conformaría con un registro de acceso HTTP. Necesitamos correlacionar la solicitud con la consulta interna, conocer la duración de cada etapa y poder reconstruir el resultado de negocio sin almacenar indiscriminadamente información sensible.
Para cada petición mediría al menos latencia, estado HTTP, consumidor, operación, empresa en forma controlada, dependencia consultada e identificador de correlación. La disponibilidad y el porcentaje de errores ayudan, pero conviene separar errores del cliente, errores de autorización y fallos del sistema interno. Si existe sincronización asíncrona, añadiría antigüedad del último dato correcto, retraso de cola y elementos rechazados.
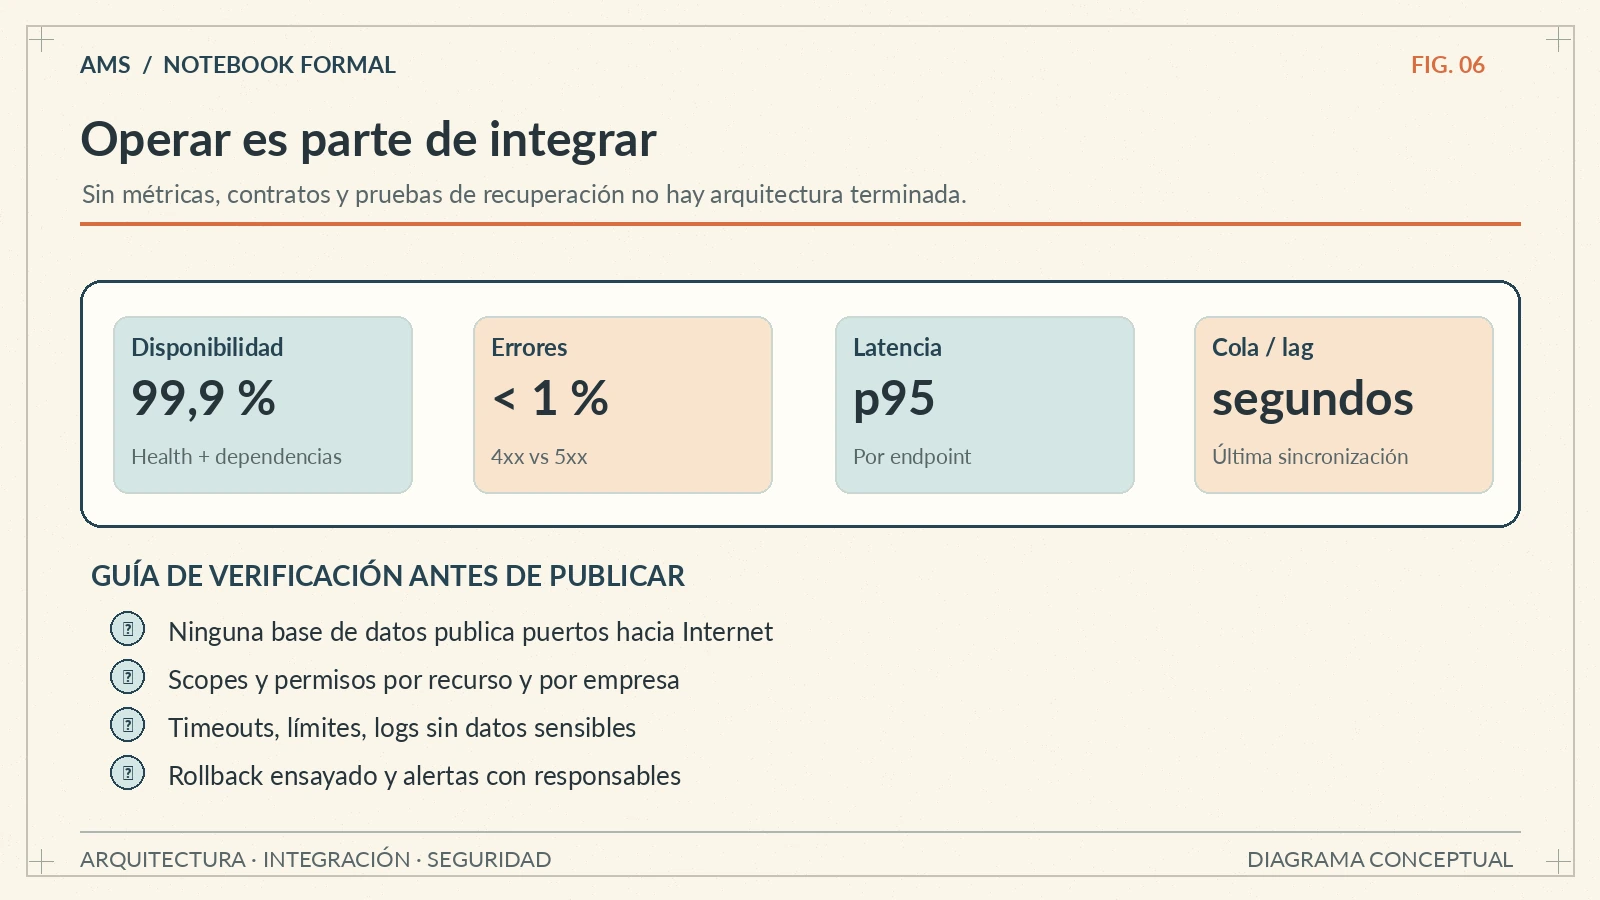
No publicaría el mismo dashboard para todos. El equipo de infraestructura necesita saber si el servicio está levantado; desarrollo, qué endpoint falla y dónde; el responsable funcional, qué pedidos o referencias no se han transferido. Esas tres perspectivas pueden compartir datos, pero responden a preguntas distintas.
En una API para sistemas legacy, los logs deben aplicar minimización y retención definida: nunca tokens, contraseñas, cadenas de conexión ni cuerpos íntegros con datos personales si no existe una necesidad justificada. Agradeceremos esa disciplina cuando llegue la primera incidencia urgente y tengamos que compartir una traza con otro equipo.
Un health check que siempre devuelve verde puede engañar
Separaría el liveness del proceso de su readiness para atender tráfico. Un endpoint de vida puede decirnos que la API sigue ejecutándose sin lanzar consultas pesadas; una comprobación de preparación debe evaluar cuidadosamente sus dependencias esenciales sin provocar una avalancha de peticiones sobre el ERP. Además, las métricas de sincronización y los resultados de negocio no deben ocultarse tras un único indicador verde.
Cómo probar una API para sistemas legacy antes de producción
El contrato API se puede verificar con tests unitarios, pero hay que preparar además pruebas de integración que respeten las rarezas del sistema heredado: codificaciones, separadores decimales, longitudes fijas, nulos inesperados, transacciones largas y respuestas que dependen de datos previos. Los mocks sirven para aislar piezas; no sustituyen una batería representativa contra un entorno controlado.
Yo establecería un conjunto de escenarios de contrato: recurso autorizado y existente, recurso de otra empresa, identificador inválido, token caducado, dependencia lenta, dato desactualizado, error de mapeo y reintento después de una respuesta perdida. Para escritura, añadiría solicitudes duplicadas y conflictos de estado. No hace falta reproducir la información de producción: son preferibles datos sintéticos con casos de negocio bien diseñados.
Probaría también el perímetro real. ¿Puede alcanzarse la base de datos desde fuera? ¿Se ha publicado accidentalmente el puerto del contenedor? ¿Qué ocurre si el túnel cae? ¿Puede una cuenta comprometida consultar datos de otra empresa? ¿Se propagan cabeceras manipuladas? ¿Hay una operación administrativa accesible con el mismo token de lectura?
Y ensayaría la recuperación. Una versión nueva puede alterar un contrato, pero también un índice, un proceso de carga o una caché. La estrategia de rollback debe contemplar compatibilidad de datos, mensajes en tránsito y versiones de clientes. Ya lo comentaba en un rollback que nunca has probado no es un rollback: el procedimiento cuenta tanto como el botón de desplegar.
Conclusión: modernizar el borde para proteger lo que ya funciona
Un ERP heredado no tiene por qué convertirse en una plataforma pública para seguir siendo útil. A veces su mayor valor está precisamente en el conocimiento de negocio que ha acumulado, sus procesos consolidados y la estabilidad que ofrece a quienes trabajan con él cada día. Lo que debemos cambiar es cómo permitimos que otros sistemas utilicen determinadas capacidades.
La solución no consiste en poner FastAPI delante de una base de datos y declarar terminada la modernización. Consiste en dibujar una frontera consciente: el contrato pertenece a la integración; las reglas siguen teniendo dueño; el consumidor obtiene el mínimo acceso necesario; la red mantiene sus límites; y el servicio dispone de pruebas, métricas y un plan de recuperación.
De todo lo que he aprendido en despliegues y migraciones recientes, esta idea es una de las que más se repite: cuando la conectividad se resuelve deprisa, el trabajo real empieza después. Si hacemos primero las preguntas incómodas —qué exponemos, por qué y para quién—, la implementación suele resultar más sencilla y la operación mucho más previsible.
Una buena API para sistemas legacy no abre la infraestructura. Abre una capacidad concreta, con responsabilidad, trazabilidad y límites claros.
¿Cómo habéis resuelto en vuestra organización el acceso a sistemas heredados: adaptador propio, VPN, túnel o una combinación? Me interesa especialmente conocer qué decisiones os han facilitado el mantenimiento después de la primera integración.
Referencias para profundizar
- Docker: Port publishing and mapping — alcance real de los puertos publicados.
- Docker Compose: Networking — redes entre servicios y separación de recursos.
- Cloudflare Tunnel: fundamentos — conexiones salientes y publicación de aplicaciones.
- FastAPI: Behind a Proxy — cabeceras y confianza en el proxy.
- OWASP API Security Top 10 — amenazas frecuentes en APIs.
Deja una respuesta