INTELIGENCIA ARTIFICIAL · SOPORTE TÉCNICO · ARQUITECTURA RAG · CALIDAD
La IA en soporte técnico puede reducir el tiempo dedicado a localizar documentación, pero también puede multiplicar los errores si responde con seguridad sobre información incorrecta. El verdadero proyecto empieza cuando decidimos cómo comprobar sus respuestas.
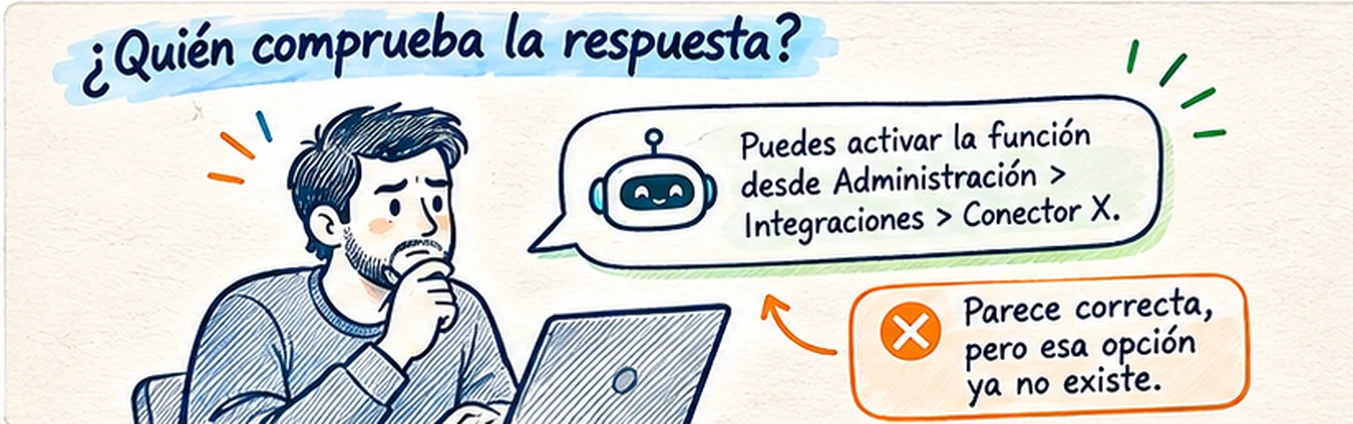
Imagina una consulta de soporte bastante corriente. Un cliente intenta activar una función y pregunta dónde se encuentra. El asistente responde en unos segundos, cita un menú, propone tres pasos y mantiene un tono impecable. El cliente los sigue, vuelve a mirar y descubre que esa pantalla ya no existe en la versión que utiliza. No ha recibido una respuesta confusa: ha recibido una respuesta convincente y equivocada.
Ese ejemplo es ficticio, pero resume una de las dificultades más interesantes de llevar asistentes a productos empresariales. Si una persona del equipo se equivoca, podemos revisar qué manual consultó y corregir el procedimiento. Cuando añadimos un modelo de lenguaje, tenemos otra capa que también puede interpretar, combinar o completar información de forma incorrecta. La fluidez no garantiza la exactitud.
Trabajando con software empresarial y con documentación generada a partir de código, cada vez me interesa más la pregunta menos espectacular: ¿cómo sabemos que la respuesta es válida para este cliente, esta versión y este momento? No pretendo presentar aquí un producto terminado ni datos de rendimiento de una implantación real. Voy a describir el enfoque técnico que utilizaría para construirlo, los controles que exigiría y los errores que intentaría detectar antes de que los descubriera un cliente.
Hay algo que no quiero perder de vista: el equipo de soporte conoce situaciones que un manual nunca recogerá del todo. El objetivo no debería ser eliminar su criterio, sino reservarlo para los casos donde más aporta valor.
El problema no es responder rápido: es responder con el contexto correcto
La tentación de empezar por la interfaz es enorme. Un cuadro de chat, un modelo que entiende preguntas y una demostración con cinco ejemplos suelen bastar para despertar entusiasmo. Sin embargo, en cuanto salimos de la demo aparecen las preguntas reales: ¿qué versión tiene instalada esa persona?, ¿qué módulos tiene contratados?, ¿tiene permisos para modificar la configuración?, ¿hay una incidencia abierta que explica el error?
En la práctica, el conocimiento de soporte se encuentra repartido entre manuales, notas de versión, procedimientos, tickets, conversaciones y personas. Una respuesta útil requiere identificar primero qué fuentes son pertinentes. A veces no necesitamos que la IA invente una explicación: necesitamos que encuentre el apartado exacto que alguien escribió hace meses y que ahora cuesta localizar.
La IA en soporte técnico debería comenzar por un objetivo medible y modesto, por ejemplo resolver preguntas de navegación y configuración habitual usando documentación oficial vigente. No comenzaría permitiendo al asistente cambiar parámetros, ejecutar acciones administrativas o tomar decisiones sobre facturación. Son niveles de riesgo diferentes y merecen fases distintas.
Primera decisión de producto: delimitar explícitamente qué preguntas puede responder el asistente, con qué fuentes y en qué situaciones debe pedir ayuda a una persona. Definir el alcance evita que una buena demo se transforme en una expectativa imposible.
De los Markdown a una respuesta: una arquitectura RAG que se pueda explicar
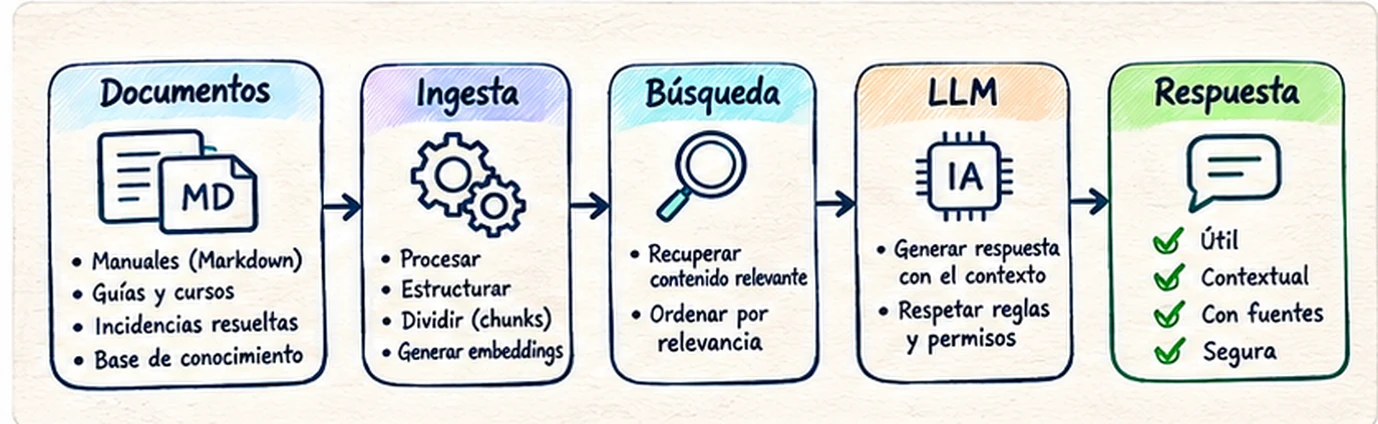
RAG significa Retrieval-Augmented Generation, o generación aumentada por recuperación. En lugar de pedir al modelo que responda únicamente con su conocimiento general, buscamos previamente información relevante en un repositorio controlado. Después, el modelo utiliza ese contexto para construir la respuesta. Es un patrón muy útil, pero no una garantía automática de veracidad.
En una solución de IA en soporte técnico, el recorrido puede comenzar con manuales escritos en Markdown, procedimientos aprobados, preguntas frecuentes e incidencias reutilizables. Un proceso de ingesta comprueba los documentos, extrae estructura, asigna metadatos, divide el contenido en fragmentos e indexa el texto para poder recuperarlo mediante búsqueda léxica, semántica o una combinación de ambas.
Cuando alguien pregunta, el backend autentica al usuario y determina su contexto. Solo entonces formula una búsqueda sobre los documentos a los que tiene acceso, selecciona los fragmentos relevantes y genera una respuesta con referencias. Finalmente registra lo necesario para auditar el resultado y permite escalar a soporte si el material es insuficiente.
| Componente | Responsabilidad | Qué comprobar |
|---|---|---|
| Fuente documental | Manual, procedimiento o resolución autorizada | Origen, propietario, versión y vigencia |
| Ingesta | Normalizar, dividir y enriquecer documentos | Errores, duplicados y bajas |
| Recuperación | Localizar fragmentos relevantes y autorizados | Permisos, cobertura y pertinencia |
| Generación | Redactar una respuesta apoyada en evidencias | Fidelidad a la fuente y abstención |
| Experiencia de soporte | Citas, feedback y derivación a una persona | Comprensión, continuidad y resolución |
No mezclaría todas esas responsabilidades dentro de un único prompt. La búsqueda, el control de acceso y la selección de fuentes son decisiones de arquitectura; la redacción de la respuesta es otra. Esa separación permite investigar dónde se produjo un fallo sin culpar automáticamente al modelo.
La documentación es parte del producto, no material de relleno
Una buena parte del trabajo empieza antes de elegir embeddings. Si los manuales están incompletos, mezclan distintas versiones o contradicen el comportamiento actual del software, el buscador tendrá pocas posibilidades de acertar. Un sistema RAG no convierte documentación mala en documentación buena. Como mucho, la hace más fácil de consultar y también más fácil de propagar.
Los Markdown pueden ser una base excelente porque conservan encabezados, listas, ejemplos y enlaces. Pero antes de indexarlos necesitamos una política editorial: quién valida cada página, qué versión del producto describe, cuándo se revisó y qué sucede al publicar una versión nueva. El objetivo es que un cambio en el producto produzca también una decisión sobre el conocimiento que lo explica.
Me interesa especialmente el contenido generado a partir del código por agentes de IA. Puede ayudar a reconstruir pantallas, rutas y comportamientos, pero no debería publicarse sin revisión funcional. El código describe parte de lo que la aplicación hace; no siempre explica lo que debería hacer, para quién está disponible o qué excepciones conoce el equipo de soporte.
Versionar el conocimiento significa poder despublicarlo
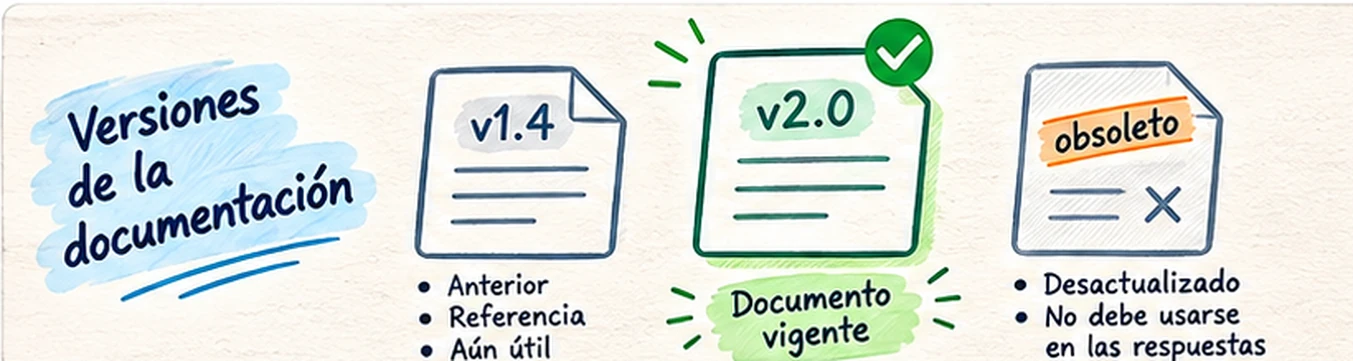
La pregunta que más dificultades causa no suele ser «¿dónde está el manual?», sino «¿qué manual corresponde a este caso?». Si la versión 1.4 y la 2.0 mantienen instrucciones distintas, el asistente debe seleccionar la compatible con el cliente. Si una guía deja de ser válida, retirarla de la navegación no basta: también debe dejar de ser recuperable como fuente vigente.
Cada fragmento debería heredar metadatos de documento y sección. No almacenaría únicamente texto y un vector numérico. Una estructura sencilla podría contener lo siguiente; los valores son inventados para ilustrar el diseño:
{
  "document_id": "manual-configuracion",
  "chunk_id": "manual-configuracion:2.0:3.2",
  "product": "erp",
  "product_version": "2.0",
  "language": "es",
  "section": "3.2 Exportación de datos",
  "status": "vigente",
  "visibility": "cliente",
  "tenant_scope": "global",
  "reviewed_at": "2026-11-01",
  "source_uri": "/manuales/2.0/configuracion#exportacion"
}
Con esos campos podemos filtrar por versión, aplicar el ciclo de vida editorial y mostrar una referencia verificable. También podemos eliminar un documento y sus fragmentos del índice cuando se revoca su publicación. Esa operación debe estar prevista en la ingesta: los índices no se mantienen correctos por arte de magia.
Consejo de mantenimiento: el repositorio de documentación debería tener una persona responsable, historial de cambios y un procedimiento de revisión tras cada entrega del producto. Si no sabemos quién actualiza el conocimiento, tampoco sabremos a quién avisar cuando la IA cite algo obsoleto.
Buscar bien importa tanto como elegir un buen modelo
Imaginemos que un cliente pregunta «¿cómo exporto las facturas del trimestre?». Un buscador semántico puede encontrar un apartado sobre exportaciones, pero quizá ignore otro donde se explica una restricción de permisos. Por su parte, una búsqueda exacta puede recuperar la palabra «factura» cien veces sin identificar la respuesta adecuada. Los dos fallos tienen poco que ver con la capacidad de redactar del modelo.
Empezaría por una estrategia híbrida: búsqueda léxica para nombres de menús, códigos de error y términos exactos; búsqueda vectorial para preguntas expresadas de otra manera; y un proceso de ordenación posterior cuando aporte una mejora comprobada. El tamaño de los fragmentos también influye. Si son demasiado pequeños, pierden condiciones y advertencias; si son enormes, mezclan temas que deberían mantenerse separados.
No escogería un tamaño fijo sin medirlo. Respetaría los encabezados y la estructura del Markdown, conservaría el enlace al documento padre y realizaría pruebas con consultas que se parecen a las del soporte real. Para algunas preguntas, recuperar dos fragmentos correctos puede ser mejor que enviar diez páginas al modelo.
El filtro que suele olvidarse: versión y alcance
La recuperación debe incorporar la versión del producto, el idioma, las funcionalidades disponibles y el tipo de usuario. Cuando falte uno de esos datos, el asistente puede preguntar antes de responder. «¿Estás usando la versión 1.x o 2.x?» es menos espectacular que adivinar, pero puede ahorrar varios correos y una incidencia innecesaria.
Los resultados de la búsqueda deben evaluarse independientemente de las respuestas generadas. Si el fragmento correcto nunca llega al modelo, ajustar el tono del prompt no resolverá el problema. Primero hay que demostrar que recuperamos la evidencia adecuada.
Una respuesta verificable necesita fuentes, no solo una frase de confianza
No me basta con mostrar debajo del mensaje tres enlaces vagamente relacionados. Quiero que cada instrucción importante pueda vincularse a una fuente concreta: manual, versión, apartado y, cuando sea posible, fragmento. Si el asistente recomienda una ruta de menú, el usuario debería poder comprobarla directamente sin tener que buscar por su cuenta.
Una buena respuesta podría decir: «Para configurar la exportación, entra en Administración → Exportaciones. Esta opción está documentada en el Manual de usuario, versión 2.0, apartado 3.2». Esa frase es un ejemplo ficticio. La diferencia es que aporta evidencia y permite comprobar si corresponde al producto del cliente.
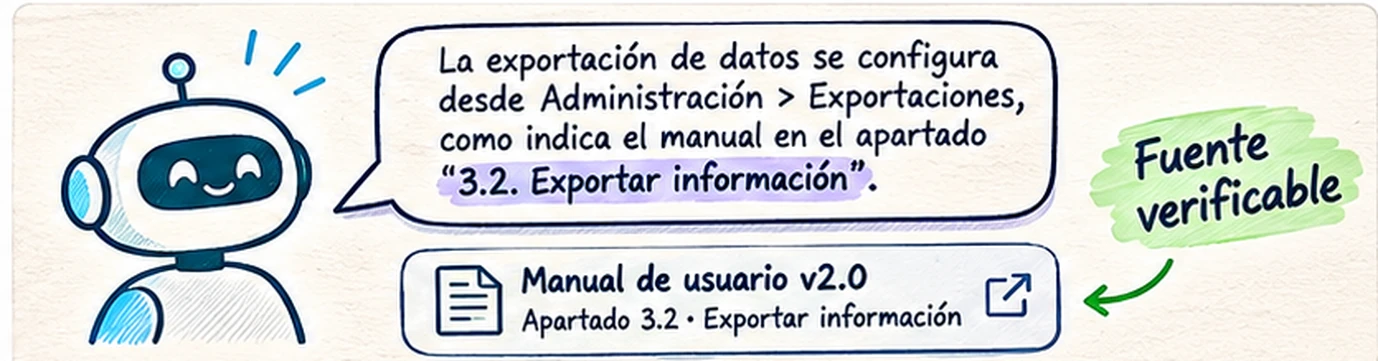
Las referencias también ayudan al soporte. Si tres usuarios valoran negativamente una respuesta que cita el mismo documento, quizá la solución no sea reentrenar el modelo, sino actualizar el procedimiento. En ese momento, la conversación se convierte en una señal de calidad documental.
Regla editorial: si no existe una fuente suficiente y vigente, el asistente no debería fabricar un enlace, inventar una sección ni presentar una conjetura como una instrucción validada. Debe reconocer lo que desconoce.
En un sistema multicliente, la seguridad no puede quedar en manos del prompt
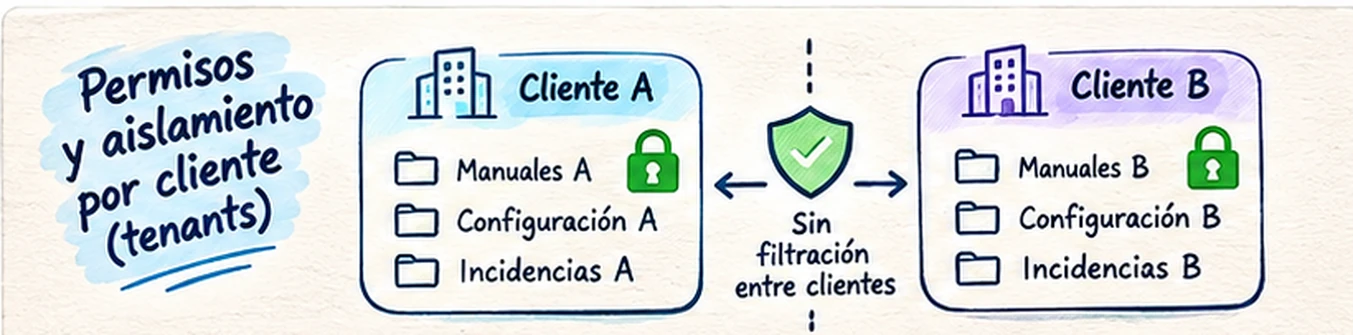
Este es, probablemente, el punto en el que menos concesiones haría. Una plataforma de soporte para varias empresas puede contener manuales generales, configuraciones particulares, incidencias privadas y documentos internos. Que un usuario formule una pregunta similar a la de otro cliente no le da derecho a consultar su información.
La identidad y los permisos tienen que aplicarse antes de recuperar los fragmentos. No basta con escribir al modelo «no compartas información de otros clientes». Si el documento del cliente B ya ha entrado en el contexto de la petición del cliente A, el aislamiento ha fallado en una capa anterior.
En la práctica, cada documento o fragmento debe contar con metadatos de seguridad adecuados, y el backend tiene que validar la identidad autenticada, los roles y el ámbito de acceso. Según la arquitectura, podremos utilizar índices separados, controles de acceso nativos del motor o filtros de seguridad implementados del lado del servidor. La elección requiere pruebas de aislamiento, no solo una revisión superficial del esquema.
El contexto del usuario nunca debería inventarse
El identificador de cliente, el rol y las capacidades del usuario deben proceder del sistema de autenticación y de las autorizaciones del backend. No deben aceptarse de un parámetro editable del frontend ni deducirse de lo que alguien escriba en el chat. También revisaría qué ocurre con roles que cambian, sesiones antiguas y documentos a los que se revoca acceso después de indexarlos.
Un pseudoflujo seguro de recuperación sería el siguiente. No representa una API concreta, sino la separación de responsabilidades que exigiría en una aplicación real:
identidad = autenticar_sesion()
permisos = resolver_permisos_servidor(identidad)
consulta = normalizar_pregunta(usuario)
fuentes = buscar(
  consulta,
  filtro_autorizacion = permisos,
  version_producto = identidad.version_permitida
)
fuentes = verificar_acceso_actual(fuentes, permisos)
respuesta = generar_respuesta(consulta, fuentes)
registrar_traza_minimizada(identidad, fuentes, respuesta)
La revisión de permisos antes de enviar contexto al LLM debe ser efectiva y resistente a errores. En búsquedas complejas, las políticas de acceso del repositorio original y las del índice pueden no evolucionar al mismo ritmo. Por eso, además de filtrar en la búsqueda, conviene contemplar validaciones adicionales, pruebas de revocación y mecanismos que eliminen fragmentos caducados.
Prueba imprescindible: crear dos clientes ficticios con documentación privada y consultas parecidas, comprobar la recuperación y forzar cambios de permisos. El resultado esperado es que ninguna ruta de consulta entregue contenido ajeno, incluso cuando la pregunta mencione literalmente el título de otro documento.
Prompt injection, datos personales y acciones que el asistente no debería ejecutar
No todo el texto que recuperamos es inocente. Un documento podría contener instrucciones dirigidas al propio asistente, aunque su finalidad fuera ser leído como información. Ese es el problema de las inyecciones indirectas de instrucciones: el modelo puede confundir contenido externo con órdenes sobre cómo comportarse.
La protección no consiste en pedirle al modelo que «ignore los ataques» y confiar en que siempre obedecerá. Conviene separar instrucciones confiables de documentos recuperados, limitar el uso de herramientas, validar toda acción en el backend y tratar las fuentes como datos no privilegiados. Los controles de acceso deben existir fuera del modelo. OWASP recoge estos riesgos en su proyecto de seguridad para aplicaciones con LLM.
También pensaría en el contenido de los tickets. Un histórico puede incorporar nombres, correos, capturas, secretos expuestos accidentalmente o datos de terceros. No todo debería convertirse en material indexable. Necesitamos clasificación documental, criterios de minimización, políticas de retención y, cuando proceda, seudonimización antes de alimentar el sistema.
Si más adelante el asistente adquiere capacidades de ejecución —por ejemplo abrir incidencias, solicitar cambios o actualizar configuraciones—, las trataría como operaciones de negocio con autorización, validación, registro y confirmación donde corresponda. Una respuesta de chat y una modificación efectiva del sistema no comparten el mismo nivel de riesgo.
Frontera de confianza: los documentos pueden informar una respuesta, pero no conceden permisos ni autorizan acciones. Ni el mejor prompt reemplaza al control de acceso del backend.
La evaluación empieza antes de enseñar el asistente a los clientes
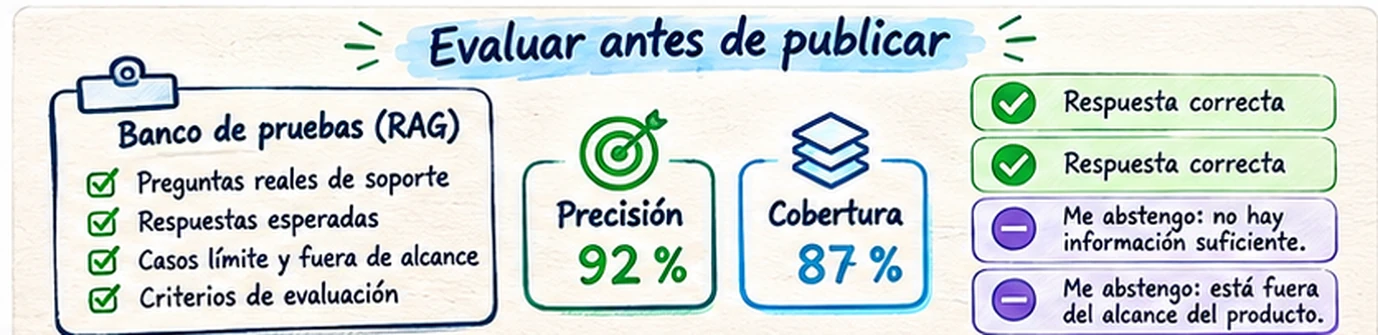
Hay un momento habitual en los proyectos de IA: probamos una docena de preguntas, las respuestas suenan bien y concluimos que el piloto está listo. Ese criterio es demasiado débil. Para saber si la IA en soporte técnico mejora realmente la atención necesitamos un conjunto de preguntas representativo, respuestas esperadas y una forma repetible de revisar los resultados.
Construiría un banco de evaluación a partir de consultas reales previamente revisadas y anonimizadas, complementado con casos sintéticos. Incluiría preguntas fáciles, versiones diferentes, menús con nombres parecidos, consultas ambiguas, información inexistente, permisos insuficientes y situaciones que deben terminar en derivación humana.
La evaluación debería separarse en tres capas. Primero, recuperación: ¿hemos encontrado la fuente correcta? Segundo, respuesta: ¿lo que afirma el modelo está apoyado por las fuentes y responde a la necesidad? Tercero, operación: ¿respeta permisos, sabe abstenerse y no produce efectos no autorizados?
| Dimensión | Pregunta que responde | Ejemplo de comprobación |
|---|---|---|
| Recall@k o cobertura de recuperación | ¿Aparece el fragmento necesario entre los recuperados? | Preguntas con referencia documental conocida |
| Precisión de recuperación | ¿Cuánto contexto recuperado es pertinente? | Revisión de fragmentos que recibe el modelo |
| Fidelidad o groundedness | ¿La respuesta se deriva de la evidencia? | Comparación de afirmaciones y citas |
| Exactitud funcional | ¿Los pasos funcionan en la versión indicada? | Prueba sobre entorno controlado |
| Abstención apropiada | ¿Evita afirmar cuando faltan evidencias? | Preguntas sin respuesta o fuera de alcance |
| Seguridad de acceso | ¿Se impide recuperar datos ajenos? | Pruebas multitenant y de revocación |
Las métricas no tienen el mismo denominador ni se interpretan igual. Un asistente que se abstiene en todos los casos quizá evite ciertos errores, pero no resuelve nada. Otro que responde siempre puede parecer útil hasta que se revisan los fallos graves. Por eso definiría umbrales por tipo de consulta y coste del error, además de revisar ejemplos cualitativos.
El evaluador también puede equivocarse
Es práctico utilizar un segundo modelo como apoyo para comparar respuestas o detectar ausencia de evidencias. Sin embargo, no lo trataría como juez infalible. Conservaría un conjunto revisado por personas, criterios claros y una muestra de discrepancias para auditoría. En preguntas funcionales, nada sustituye comprobar el procedimiento en la versión correcta del producto.
Cada cambio importante en el corpus, el buscador, el prompt o el modelo debería disparar una batería de regresión. No publicaría una modificación solo porque mejora una media agregada si empeora casos críticos, como accesos, facturación o gestión de datos personales.
Para una primera entrega: mejor cien preguntas cuidadosamente elegidas y etiquetadas que miles de ejemplos sin verificar. Esas cien preguntas deben incluir los fallos que de verdad perjudicarían a los clientes.
La mejor respuesta a veces es «no tengo información suficiente»
Hay respuestas en las que el asistente debe pedir contexto: versión, pantalla, mensaje de error o rol. En otras, debería reconocer que no dispone de documentación fiable. Y en determinadas operaciones conviene derivar directamente a soporte sin intentar una solución automática.
Diseñaría estados de salida explícitos: respuesta respaldada, pregunta de aclaración, información insuficiente y derivación. Esa clasificación facilita tanto la experiencia del usuario como el seguimiento. No me fiaría de un porcentaje genérico de confianza que el propio modelo se atribuye; las decisiones de abstención deben apoyarse en señales evaluadas del sistema.
Por ejemplo, si la búsqueda no encuentra un manual compatible con la versión indicada, el asistente puede decir: «No he encontrado un procedimiento validado para tu versión. Si me confirmas el número de versión, intento localizar la documentación adecuada; también puedo trasladar la consulta al equipo de soporte». No es una derrota del proyecto. Es evitar que una conjetura se convierta en una instrucción incorrecta.
Una política así puede parecer conservadora al principio. Sin embargo, ayuda a construir confianza: quienes utilizan una herramienta técnica necesitan saber cuándo pueden seguir sus pasos y cuándo todavía falta contexto.
Escalar a una persona no debería obligar a empezar de cero
El soporte humano no es una excepción vergonzosa del sistema. Es una parte normal de su diseño. Si el asistente detecta que no puede resolver la consulta, debería permitir transferirla con el contexto autorizado: pregunta original, versión, información ya aportada, fuentes utilizadas y motivo de la derivación.
En ese punto hay una distinción relevante. No enviaría indiscriminadamente toda la conversación, capturas o datos personales a cualquier agente. El expediente debe contener lo necesario para resolver el caso, con permisos aplicados al destinatario y una política de conservación. El usuario también debería comprender qué información se va a compartir.
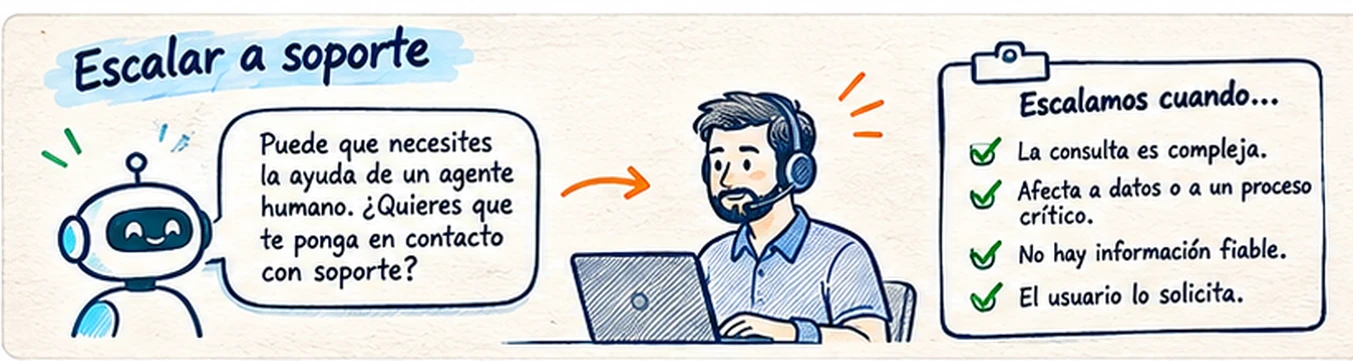
La derivación puede integrarse con una herramienta de tickets y un circuito de estados: nuevo, pendiente de información, en tratamiento y resuelto. No hace falta que el modelo decida por sí solo la prioridad final. Puede proponer una clasificación; después, reglas verificables y personal de soporte la validan cuando el impacto lo exige.
Me parece útil añadir el recorrido inverso: cuando una persona resuelve una incidencia y descubre que faltaba una instrucción en la base de conocimiento, el cierre puede proponer una actualización documental. Esa revisión editorial es la que evita responder lo mismo de forma artesanal durante años.
Mejora concreta de experiencia: antes de derivar, el asistente debería explicar por qué lo hace, confirmar los datos que enviará y conservar el historial pertinente. El cliente no tiene por qué repetir lo que ya contó.
Observabilidad de un asistente: medir algo más que tokens y satisfacción
Una vez publicada una solución de IA en soporte técnico, el asistente se convierte en un sistema que hay que operar. Un panel de tokens consumidos puede explicar el coste, pero no si los clientes están resolviendo sus problemas. Una valoración positiva tampoco demuestra por sí sola que las instrucciones fueran correctas. Necesitamos observabilidad de producto, recuperación y seguridad.
Registraría una traza por consulta con identificadores de correlación, versión del corpus, documentos recuperados, tiempos por fase, modelo utilizado, resultado y tipo de cierre. Evitaría guardar más contenido sensible del necesario. Cuando se precise revisar una respuesta, deberíamos poder reconstruir qué evidencias recibió el modelo sin exponer datos de otros usuarios.
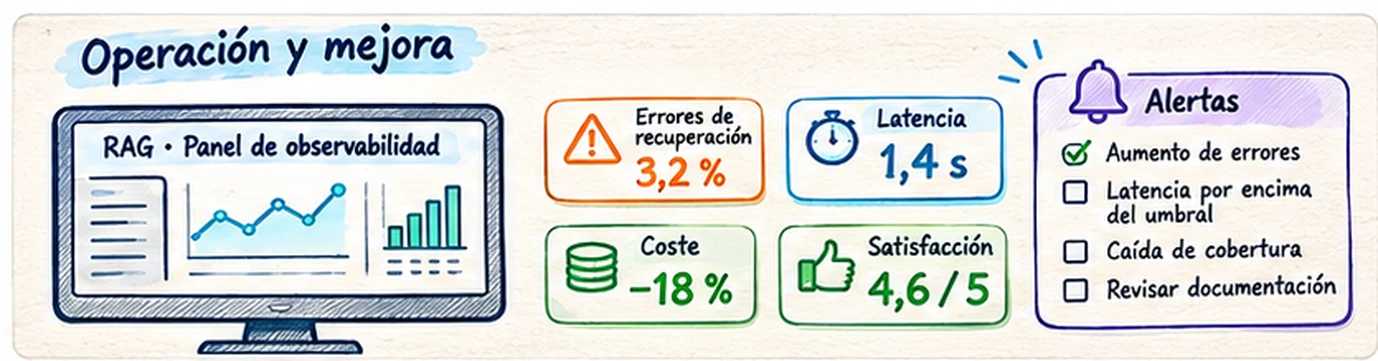
No buscaría una única métrica mágica. Construiría una vista que permita relacionar la experiencia con la arquitectura y el trabajo de soporte. Las cifras que aparecen en la ilustración son totalmente ficticias y no describen resultados de ninguna empresa.
| Indicador | Interpretación útil | Acción ante un empeoramiento |
|---|---|---|
| Consultas resueltas con evidencia | Respuestas útiles con fuente revisable | Inspeccionar casos y corpus |
| Escalados bien justificados | Casos que necesitan intervención real | Revisar alcance y documentación |
| Errores de recuperación | Fuentes ausentes o equivocadas | Ajustar filtros, índices y fragmentación |
| Tiempo hasta primera respuesta útil | Experiencia, no solo latencia del LLM | Analizar búsqueda, generación y derivación |
| Incidencias repetidas | Conocimiento o producto que sigue fallando | Abrir mejora documental o funcional |
| Eventos de seguridad y acceso | Intentos o fallos de aislamiento | Investigar de inmediato y reforzar controles |
También segmentaría por producto, versión y tipo de pregunta. Una media excelente puede esconder una versión especialmente problemática. Si cambiamos el buscador y mejora el resultado global pero se deterioran las consultas de un módulo crítico, necesitamos verlo antes de dar la modificación por buena.
Cómo pondría en marcha un piloto sin convertirlo en otro gran proyecto
Para introducir IA en soporte técnico, la recomendación más práctica que daría a un equipo pequeño es escoger un dominio con documentación razonablemente madura y riesgo contenido. Puede ser navegación general, configuración de preferencias o dudas frecuentes sobre una versión vigente. Evitaría empezar por los procesos que pueden provocar cambios irreversibles.
Fase 1: una base de conocimiento gobernada
Primero seleccionaría un conjunto limitado de manuales y procedimientos, identificaría propietarios y vigencia, corregiría contradicciones conocidas y prepararía la ingesta. Quiero poder consultar qué documentos están indexados, cuáles se han retirado y por qué una sección aparece en los resultados. Esta inversión inicial parece lenta, pero evita construir sobre un repositorio que nadie mantiene.
Fase 2: recuperar y citar antes de generar
Después montaría un buscador con filtros de permisos y versión. Haría pruebas de recuperación sin LLM, mirando qué fragmentos encuentra para las preguntas escogidas. Si la búsqueda falla, la corregiría antes de añadir una capa de redacción. Solo cuando tengamos evidencias suficientes conectaría la generación de respuestas y las referencias visibles.
Fase 3: piloto asistido y registro de errores
Abriría el sistema a un grupo reducido de personas de soporte o usuarios piloto, con una advertencia clara sobre su alcance. El objetivo no sería presumir de porcentaje de automatización, sino identificar fallos de recuperación, preguntas mal formuladas, documentos obsoletos y momentos donde la intervención humana resulta más sensata.
Fase 4: ampliar cuando la evaluación lo justifique
Por último, añadiría nuevos módulos, idiomas o tipos de incidencia cuando sus pruebas de seguridad y calidad estén maduras. El ritmo de expansión debería depender de la evidencia, no de una fecha comercial inamovible. También planificaría el coste operativo: indexación, inferencia, supervisión, soporte y trabajo editorial.
Mi criterio de salida del piloto: antes de ampliar a otros clientes, exigiría pruebas de aislamiento superadas, un nivel de exactitud acordado por criticidad, citas verificables, derivación operativa y una persona responsable del contenido.
La parte que no resolverá ningún modelo: acuerdos entre equipos
Hay una razón por la que los proyectos de IA en soporte técnico me parecen más cercano a la ingeniería de producto que a instalar un chatbot. Si soporte descubre un manual incorrecto, documentación debe corregirlo; si el error proviene de un comportamiento del ERP, desarrollo debe investigarlo; si el problema es de permisos, seguridad tiene que intervenir. El asistente revela relaciones que quizá ya existían, pero que estaban poco definidas.
Con frecuencia necesitamos un acuerdo sencillo sobre propiedad del conocimiento: quién valida una respuesta nueva, quién aprueba un documento, cómo se comunican los cambios de versión y qué significa que una incidencia se ha convertido en una mejora estable. Sin eso, el sistema puede acumular cientos de fragmentos y seguir repitiendo los mismos problemas.
Por eso prefiero pensar en un ciclo completo: pregunta → evidencia → respuesta → resultado → aprendizaje → actualización. Si dejamos fuera la última parte, automatizamos el consumo de documentación, pero no su mejora. Y el soporte seguirá gastando tiempo explicando errores del conocimiento que ya conocemos.
En la dirección técnica conviene resistirse a vender la IA como sustituta inmediata del equipo. La apuesta más sólida es hacer que la experiencia acumulada resulte consultable, trazable y mantenible. Eso permite ofrecer respuestas más rápidas sin hipotecar la confianza de las personas que dependen del software para trabajar.
Preguntas frecuentes sobre IA en soporte técnico
¿Necesito entrenar un modelo propio para empezar?
No necesariamente. Para responder preguntas basadas en manuales y procedimientos, una arquitectura RAG bien diseñada puede ser un mejor punto de partida que entrenar un modelo con la documentación. Antes de decidir, evaluaría la calidad del buscador, los permisos, los costes y la frecuencia de actualización del conocimiento.
¿Qué ocurre si el manual todavía no contempla una funcionalidad nueva?
El asistente debería indicar que no dispone de una fuente validada para responder, solicitar más contexto o derivar a soporte. La solución estable es incorporar el nuevo procedimiento a la documentación aprobada, reindexarlo y repetir las pruebas relacionadas.
¿Puedo indexar todas las incidencias históricas?
No lo haría sin revisar clasificación, permisos y datos personales. Muchas incidencias contienen información contextual o privada que no debe reutilizarse fuera de su propósito. Una opción más segura es extraer soluciones generales, anonimizarlas cuando corresponda y someterlas a revisión antes de publicarlas como conocimiento reutilizable.
¿Cómo sé si el asistente está funcionando bien?
No basta con contar conversaciones atendidas. Separaría recuperación correcta, fidelidad de las respuestas, resolución real, abstenciones justificadas, seguridad y tiempo de atención. Además, revisaría periódicamente casos concretos y repetiría la evaluación tras cada cambio en documentos, búsqueda o modelo.
La conclusión: no necesito un asistente que lo sepa todo
Cuando pienso en un asistente de soporte útil, no imagino una herramienta que responda absolutamente a todo. Imagino una que entiende qué documentación puede consultar, identifica la versión correcta, explica sus respuestas con fuentes y reconoce cuándo necesita la ayuda del equipo. Menos espectacular en una demo, mucho más fiable un lunes por la mañana.
La IA en soporte técnico tiene potencial precisamente porque conecta dos mundos que en las empresas suelen vivir separados: el conocimiento acumulado y la necesidad inmediata de quien está intentando trabajar. Pero esa conexión solo aporta valor si la mantenemos gobernada, segura y medible.
Mi pregunta favorita para evaluar un proyecto así no sería «¿cuántas respuestas ha generado hoy?». Sería esta: «¿cuántas consultas hemos resuelto correctamente, con evidencia, sin que la persona tuviera que comprobar si la IA estaba inventando los pasos?» Lo demás es actividad; eso empieza a parecerse a calidad.
Si trabajas en soporte, arquitectura o desarrollo de software empresarial, ¿qué te preocuparía más al incorporar un asistente: la documentación obsoleta, la seguridad entre clientes o saber cuándo dejar de responder y escalar?
Referencias y lecturas técnicas
- OWASP — Top 10 for Large Language Model Applications. Riesgos de inyección de instrucciones, divulgación de información y componentes RAG.
- Microsoft Learn — Document-Level Access Control. Referencia técnica para permisos sobre documentos recuperados.
- NIST — AI RMF Generative AI Profile. Enfoque de evaluación, riesgos y gobernanza de sistemas generativos.
- Documenta decisiones, no vuelvas a escribir el código. Sobre conocimiento técnico y mantenimiento en el ciclo de vida del software.
- Modernizar software sin perder lo que funciona. La relación entre sistemas heredados, contexto de negocio y evolución responsable.
Nota editorial: los escenarios, nombres de versiones, pantallas y métricas de las ilustraciones son ejemplos ficticios. No representan configuraciones ni resultados de clientes reales.
Deja una respuesta