RETROSPECTIVA TÉCNICA · DATOS · IA APLICADA
Han pasado tres años desde mi TFM: así ha cambiado mi visión sobre los datos y la inteligencia artificial
En 2023 creía que el gran reto era convertir datos dispersos en modelos, mapas y decisiones. En 2026 sigo pensando que esa parte importa, pero he cambiado el orden de las prioridades: antes de hablar de inteligencia artificial, quiero saber si el dato conserva su significado, quién puede utilizarlo, cómo detectaremos un error y quién responderá cuando la automatización se equivoque.
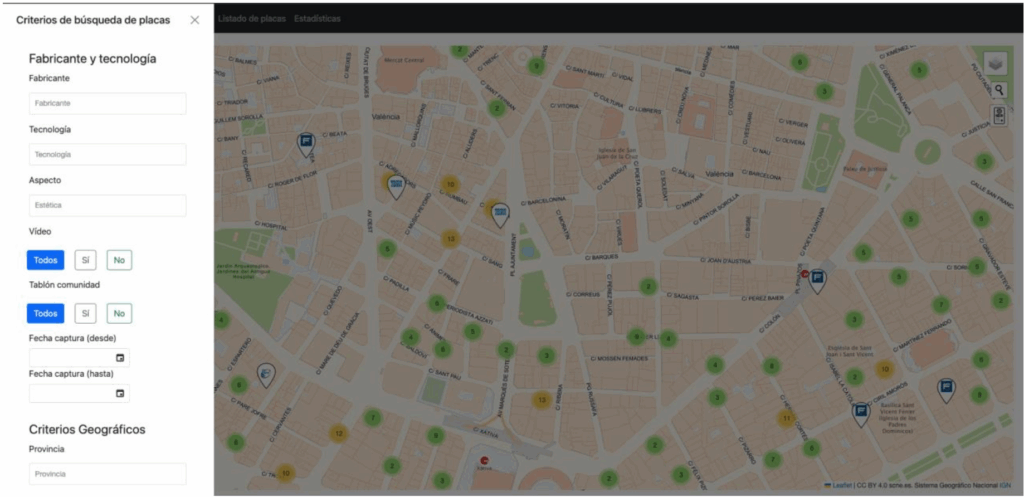
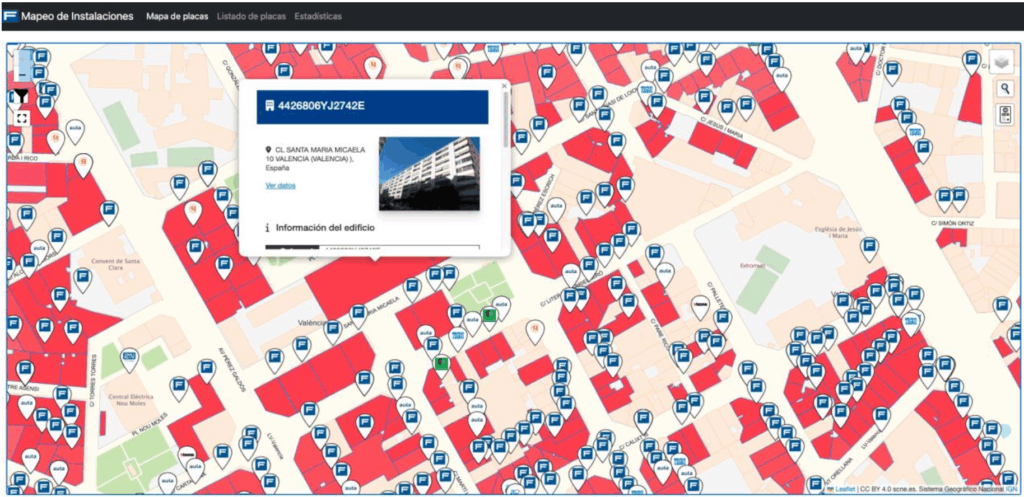
El mapa tenía más de 100.000 puntos.
Cada punto representaba una placa de portero o videoportero localizada en un edificio. Desde lejos, el resultado impresionaba: filtros, tecnologías, fabricantes, zonas y capas geográficas. Parecía que el trabajo estaba terminado.
Pero un mapa no se vuelve fiable por tener muchos puntos.
¿La dirección estaba bien normalizada? ¿La fotografía correspondía realmente a ese edificio? ¿El modelo había identificado correctamente el fabricante? ¿Qué ocurría cuando Catastro, el INE y nuestros datos internos describían una misma zona de formas distintas?
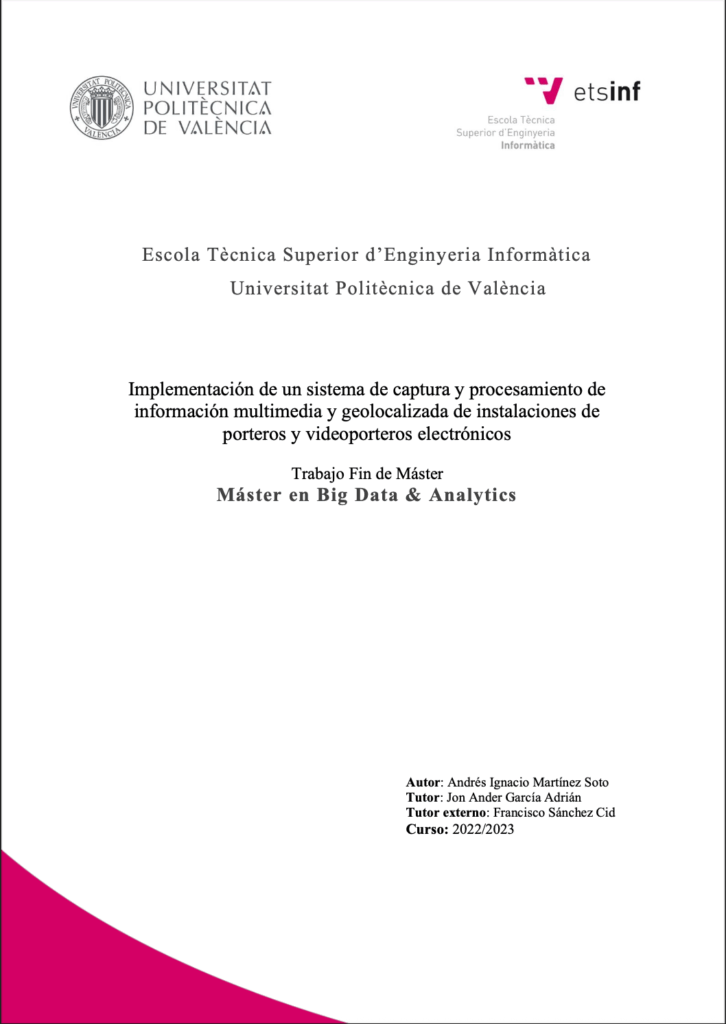
Esas preguntas ocuparon buena parte de mi Trabajo Final de Máster en Big Data & Analytics de la Universitat Politècnica de València, que defendí en 2023. El proyecto buscaba transformar un conjunto heterogéneo de imágenes, audios, direcciones y fuentes públicas en información que ayudara a entender dónde se concentraban los productos instalados de Fermax.
Entonces lo contaba como un proyecto de Big Data, geolocalización e inteligencia artificial.
Hoy lo contaría de otra manera.
Era, sobre todo, un problema de confianza.
TL;DR
Tres años después de mi TFM, ya no considero que el modelo sea el centro de un proyecto de IA. El centro es el sistema que conserva el significado de los datos, controla los permisos, mide los errores y permite intervenir cuando algo falla. La IA ha reducido el coste de generar una respuesta. No ha reducido el coste de demostrar que esa respuesta es correcta y adecuada para el contexto.
Lo que aquel TFM me enseñó antes de que llegara la fiebre generativa
El problema inicial era fácil de explicar: Fermax vendía miles de equipos, pero localizar el parque instalado y analizar su distribución requería combinar información incompleta procedente de varias fuentes.
La parte visible de la solución era un visor con Leaflet. La parte que realmente sostenía el proyecto estaba detrás:
- procesos en Python para limpiar y enriquecer registros;
- ejecución paralela con Docker y RabbitMQ;
- clasificación de imágenes y audios;
- normalización de direcciones;
- cruces con Catastro e INE;
- reglas para tratar duplicados, datos ausentes y resultados dudosos.
La automatización hizo que ciertos análisis pasaran de semanas de trabajo manual a horas de procesamiento. Aun así, la principal lección no fue de rendimiento.
Fue descubrir que un modelo puede acertar y el sistema puede seguir estando equivocado.
Puede identificar correctamente una placa y asociarla a la dirección incorrecta. Puede enriquecer un edificio con un registro catastral desactualizado. Puede dibujar un punto preciso sobre un dato que nunca fue fiable.
La precisión del algoritmo no compensa la falta de trazabilidad del dato.
Esta idea parece evidente cuando se escribe. En un proyecto real es incómoda, porque obliga a dedicar tiempo a tareas que lucen menos que una demo: reglas de calidad, identificadores, metadatos, revisión de excepciones y documentación del origen.
| Lo que se veía | Lo que hacía útil el sistema |
|---|---|
| Un mapa con miles de puntos | Direcciones normalizadas y registros deduplicados |
| Un clasificador automático | Umbrales, excepciones y revisión de casos dudosos |
| Filtros por zona y tecnología | Un vocabulario compartido entre fuentes |
| Resultados rápidos | Procesos repetibles y trazables |
| Una interfaz sencilla | Decisiones comprensibles para el equipo que debía actuar |
Un dashboard no está terminado cuando carga.
Está terminado cuando lo que muestra es cierto, se entiende y permite decidir.
De 2023 a 2026: cinco cambios en mi forma de pensar
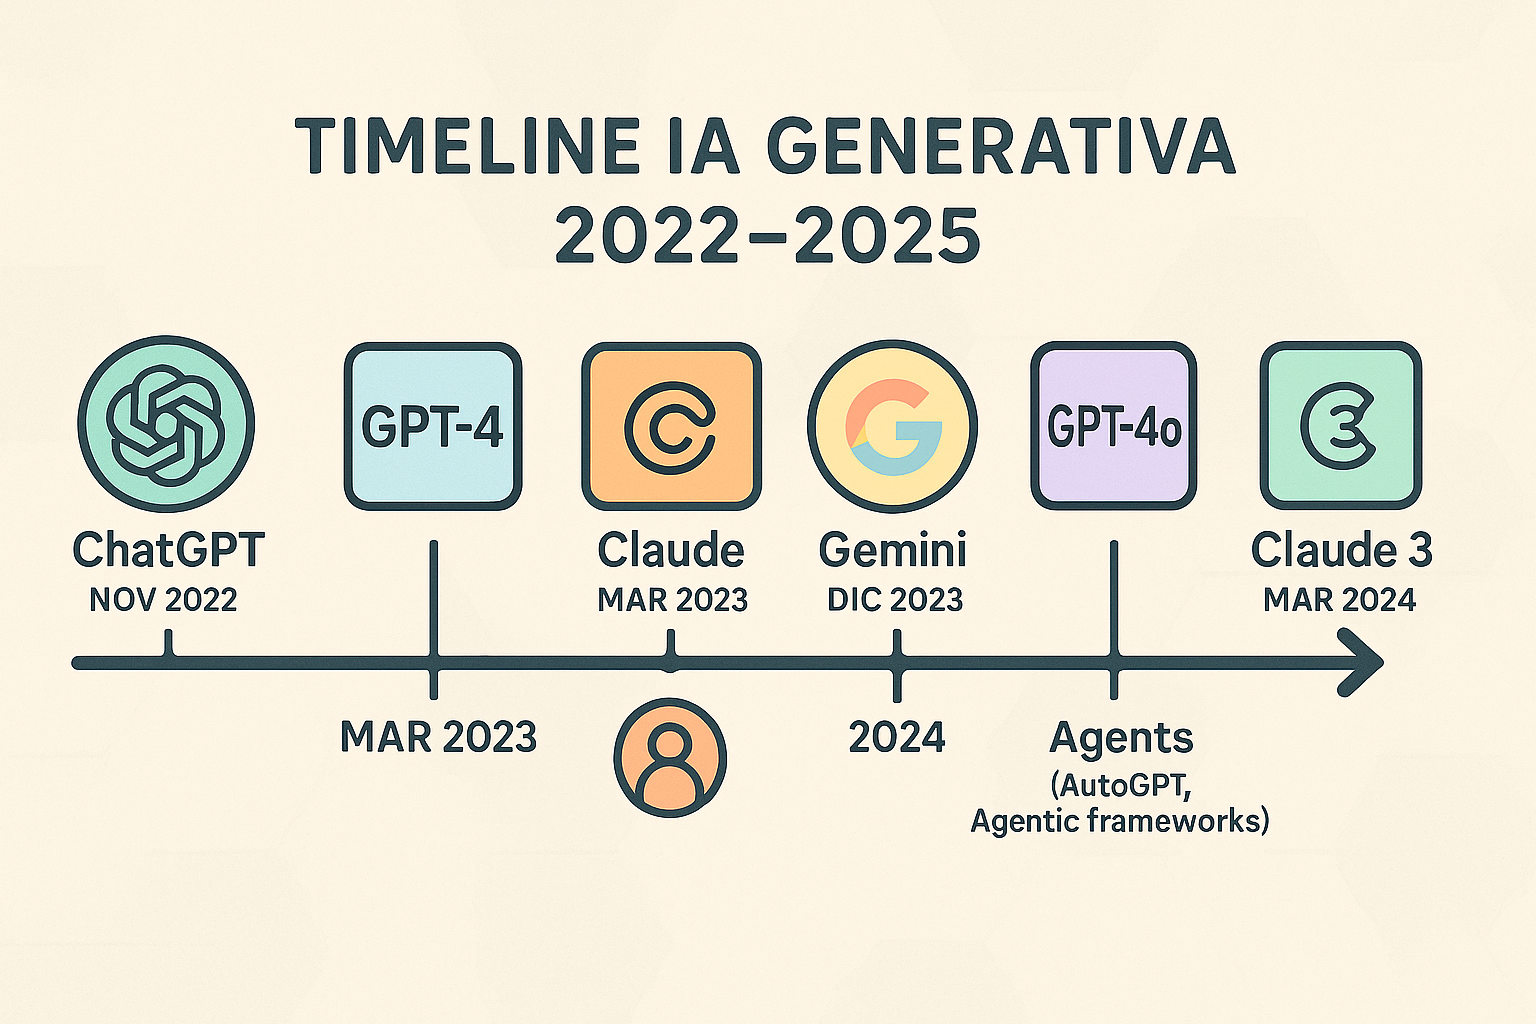
La IA generativa ha cambiado muchísimo en tres años. Es más accesible, multimodal y capaz de utilizar herramientas externas. Pero mi cambio de criterio no consiste en pensar que ahora todo es posible.
Consiste en ser más exigente con lo que llamamos un sistema de IA.
1. Del pipeline al contrato de datos
En 2023 pensaba principalmente en extraer, transformar y cargar. Hoy sigo necesitando esos procesos, pero empiezo antes: ¿qué significa exactamente cada campo y qué puede asumir un consumidor sobre él?
Una fecha puede ser la creación del registro, la fecha del evento o el momento de la última sincronización. Un estado «completado» puede significar que el alumno terminó una actividad, que alcanzó la nota mínima o que alguien cerró manualmente el expediente.
Si dos sistemas interpretan el mismo campo de manera distinta, el pipeline no integra datos. Integra ambigüedades.
Por eso ahora doy más importancia a los contratos de datos: definición, propietario, formato, reglas de calidad, frecuencia de actualización y comportamiento ante cambios de esquema. No hace falta empezar con una plataforma corporativa de gobierno del dato. Se puede comenzar con una experiencia crítica y documentar solo los datos que cambian una decisión.
2. Del dashboard a la decisión
Durante años medimos el éxito por la capacidad de reunir información y mostrarla. Ahora pregunto algo más incómodo: ¿qué decisión cambia gracias a esta pantalla?
Si una alerta indica riesgo de abandono, alguien debe saber:
- qué señales la activaron;
- con qué retraso llegan los datos;
- cuántos falsos positivos toleramos;
- qué intervención está permitida;
- cómo se registra el resultado;
- quién revisa si la alerta perjudica sistemáticamente a un grupo.
Sin ese recorrido, la analítica se limita a describir el problema con más colores.
3. Del modelo al sistema
En la primera ola de IA generativa hablábamos mucho de modelos y prompts. En producción, el modelo es solo una dependencia dentro de un sistema mayor.
La calidad final también depende del contexto recuperado, las herramientas disponibles, los permisos del usuario, las instrucciones, las validaciones, la versión del modelo, la latencia, el coste y la salida de emergencia cuando el proveedor no responde.
La pregunta ya no es solo «¿qué modelo funciona mejor?».
La pregunta es «¿qué arquitectura nos permite cambiarlo, medirlo y limitarlo sin romper el proceso?».
4. Del prompt a la evaluación
El artículo que publiqué en 2025 decía que saber conversar con un modelo era tan valioso como saber SQL. Hoy matizaría esa frase.
Un buen prompt ayuda. No es una garantía.
La competencia duradera consiste en diseñar contexto, ejemplos, herramientas y criterios de aceptación; construir un conjunto de casos de prueba; medir regresiones cuando cambia el modelo; y observar lo que ocurre con peticiones reales.
El perfil de IA generativa del NIST insiste precisamente en gestionar el riesgo durante todo el ciclo de vida y no únicamente antes del despliegue. Para mí, la consecuencia práctica es sencilla: una aplicación de IA necesita evaluación continua igual que cualquier otro sistema necesita pruebas, métricas y gestión de incidentes.
5. De responder a actuar
Un chatbot que redacta una respuesta puede equivocarse. Un agente que llama a una API puede equivocarse y cambiar el estado del mundo.
Protocolos como MCP estandarizan la conexión entre modelos, datos y herramientas. Esto abre casos de uso mucho más útiles que una conversación aislada: consultar un LMS, preparar un informe, crear una actividad o iniciar un flujo administrativo.
También eleva el riesgo.
Cuando la IA puede actuar, la autorización deja de ser un detalle de integración. Hay que decidir qué herramientas ve cada usuario, sobre qué recursos puede utilizarlas y qué operaciones requieren confirmación. El permiso del agente debería ser más estrecho que el permiso máximo de la persona en la plataforma.
Dar una herramienta a un agente es conceder una capacidad, no añadir una función al menú.
Del dato industrial al dato educativo
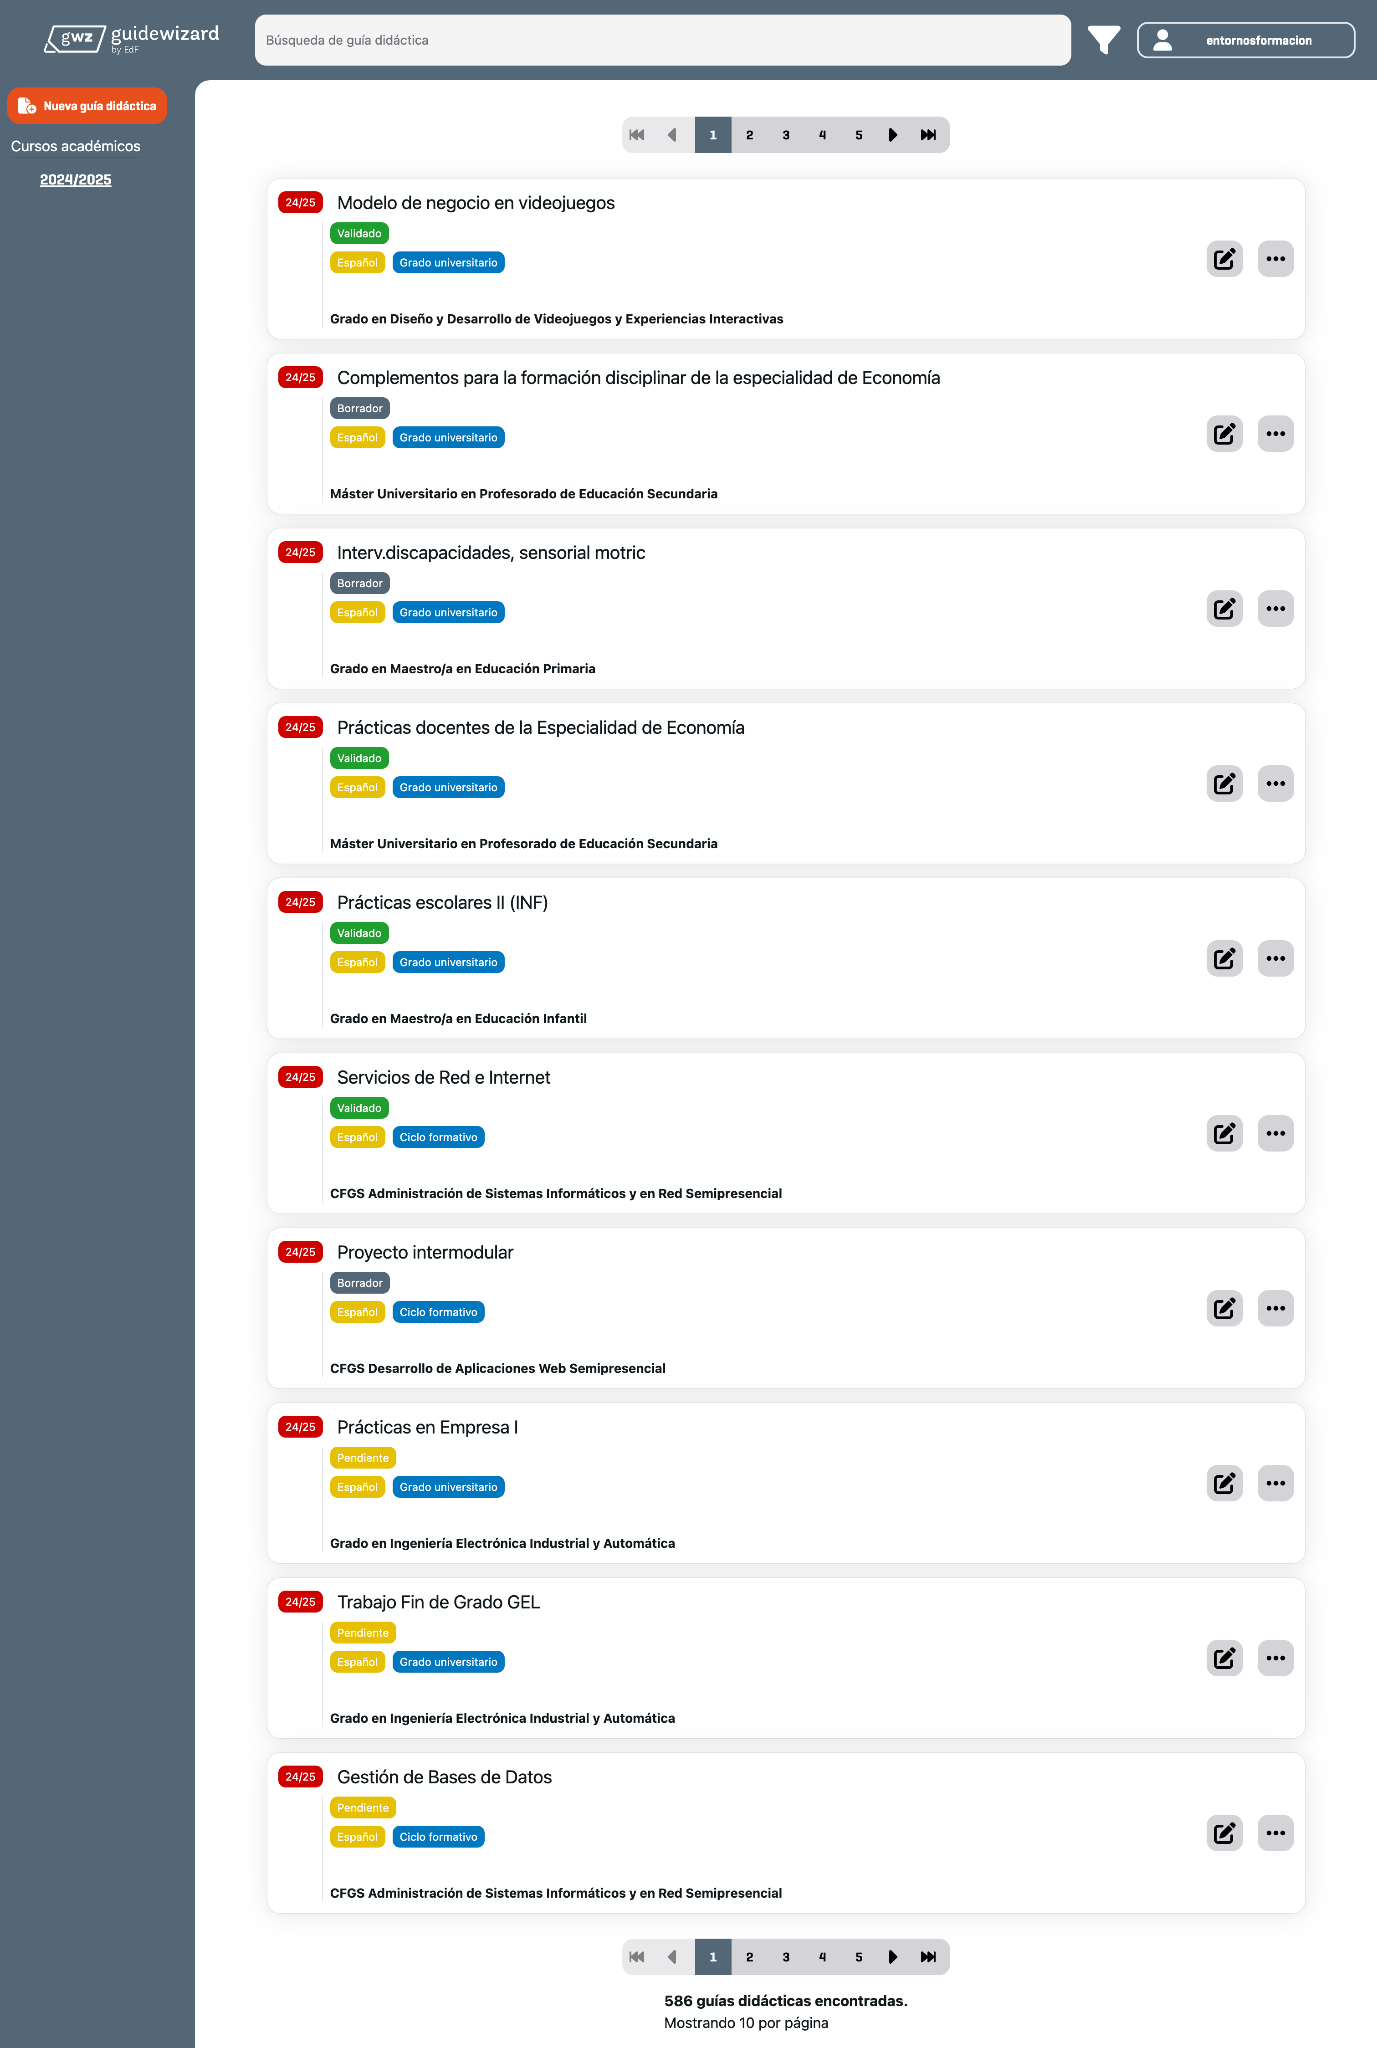
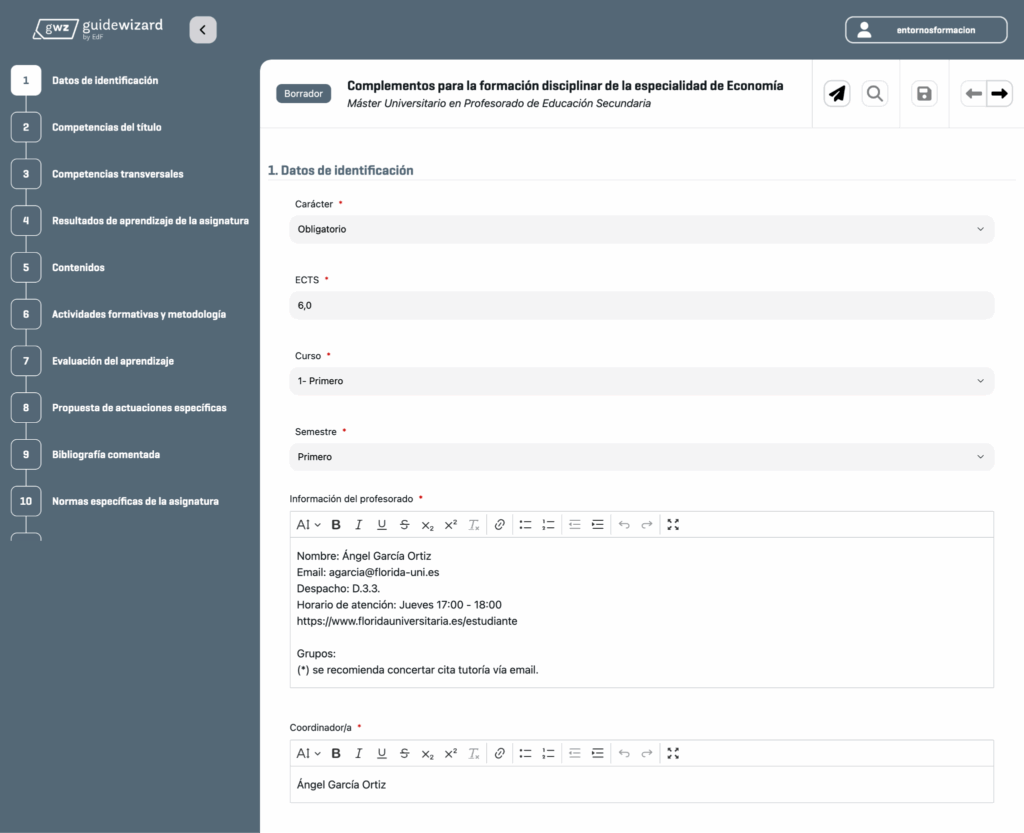
En enero de 2024 me incorporé como CTO a Entornos de Formación. Cambiaron el sector, los usuarios y los sistemas, pero reaparecieron muchos de los problemas que había encontrado en el TFM: fuentes que no comparten identificadores, procesos manuales, estados con significados distintos e integraciones que funcionan hasta que una parte cambia.
Hay, no obstante, una diferencia importante.
En el proyecto industrial, un error podía situar una placa en el edificio incorrecto y distorsionar un análisis comercial. En educación, un error puede afectar a la información que recibe un estudiante, al seguimiento de una entrega, a una calificación o a la intervención de un docente.
El sujeto del dato cambia la tolerancia al fallo.
Trabajar con LMS, identidades, APIs, automatizaciones y productos como EduID o Guide Wizard me ha hecho mirar los datos menos como materia prima y más como una responsabilidad compartida. No basta con almacenarlos de forma segura. Hay que limitar su uso, explicar para qué se procesan, reducir la exposición y evitar que una inferencia termine presentándose como un hecho.
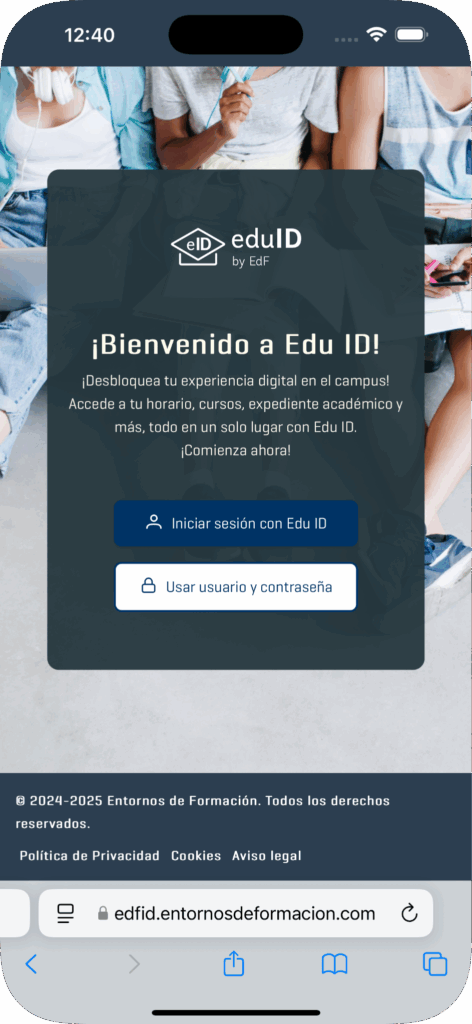
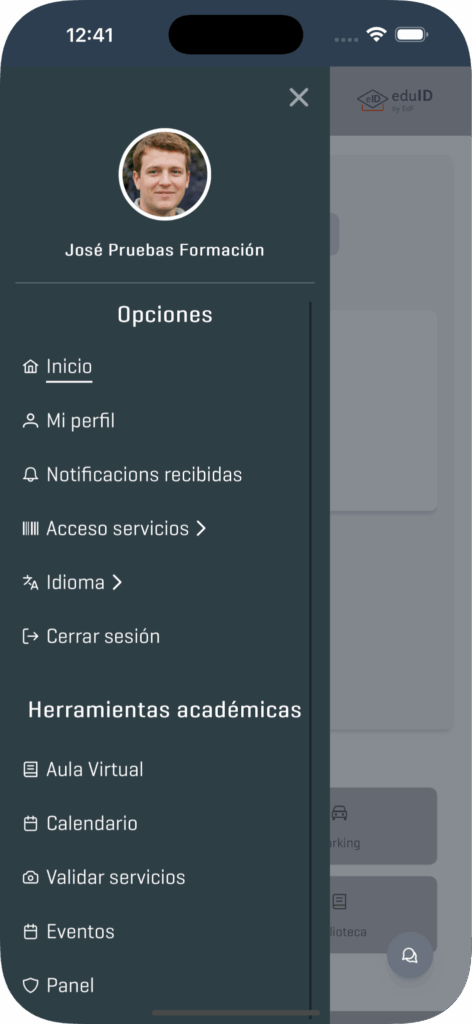
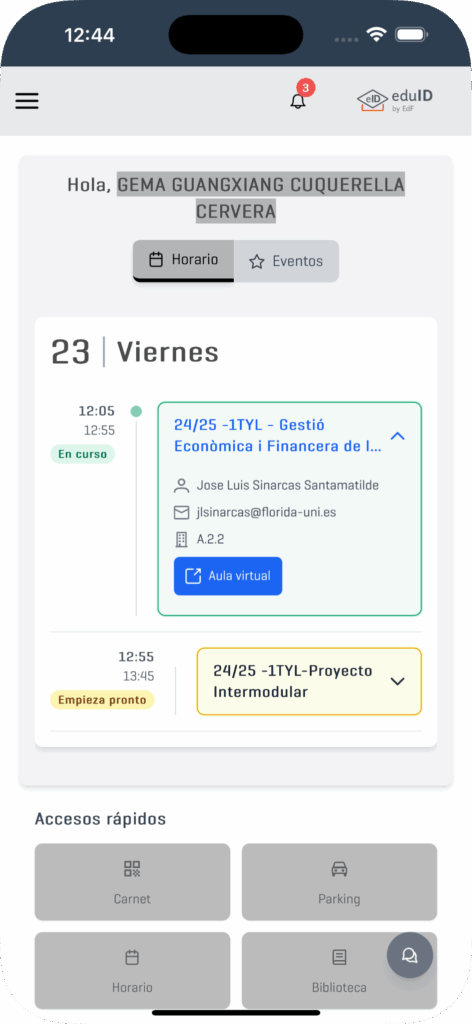
Esta cautela ya no es solo una preferencia arquitectónica. El Reglamento Europeo de Inteligencia Artificial entró en aplicación general el 2 de agosto de 2026, con calendarios específicos para determinadas obligaciones. Los sistemas de alto riesgo en áreas sensibles como la educación tienen un régimen particular y una aplicación diferida. La fecha importa, pero la dirección importa más: trazabilidad, supervisión humana, gestión del riesgo y transparencia ya forman parte del diseño del producto.
El artículo de 2025 proponía como foco futuro analizar voz, expresión facial y escritura para adaptar la enseñanza al estado emocional del alumno. Hoy no lo plantearía así.
Que una tecnología pueda inferir algo no significa que debamos incorporarlo a una decisión educativa. Antes preguntaría si la señal es válida, si es proporcional, si existe una alternativa menos invasiva y qué daño causaría una inferencia errónea.
La calidad del dato también es una cuestión ética.
Cómo diseñaría hoy un sistema de datos e inteligencia artificial
Si volviera a empezar aquel TFM con lo aprendido desde entonces, conservaría la ambición del proyecto, pero cambiaría el orden de trabajo.
Empezaría por la decisión, no por el modelo
Definiría quién necesita decidir qué, con qué frecuencia y qué coste tiene equivocarse. Solo después elegiría las fuentes y la automatización necesarias.
La pregunta «¿podemos clasificar estas imágenes?» es técnica.
La pregunta «¿qué decisión tomaremos con esa clasificación y qué confianza necesitamos?» diseña el sistema.
Crearía una línea base sencilla
Antes de añadir aprendizaje automático, mediría una solución basada en reglas o una muestra revisada manualmente. Sin línea base es fácil celebrar una mejora que no sabemos cuantificar.
Compararía al menos:
- precisión por tipo de caso, no solo una media global;
- porcentaje de registros que el sistema decide no clasificar;
- tiempo de revisión humana;
- coste por registro procesado;
- impacto real sobre la decisión posterior.
Versionaría datos, reglas y evaluaciones
Guardar la versión del modelo no basta. También registraría la versión del esquema, las reglas de normalización, el conjunto de evaluación y las fuentes utilizadas.
Si un resultado cambia, necesito distinguir si cambió el modelo, el contexto o el dato de entrada.
Diseñaría los permisos al mismo tiempo que las herramientas
Cada capacidad tendría un alcance concreto: lectura, propuesta o ejecución. Una operación reversible y de bajo impacto no necesita el mismo control que una matrícula, una calificación o la eliminación de un usuario.
Aplicaría tres preguntas a cada herramienta:
- ¿Quién puede verla?
- ¿Sobre qué recursos puede actuar?
- ¿Qué acciones necesitan confirmación o revisión?
Prepararía el fallo antes del despliegue
¿Qué ocurre si el modelo no responde? ¿Y si responde con un formato inválido? ¿Podemos repetir la operación sin duplicarla? ¿Existe una ruta manual? ¿Sabemos reconstruir por qué se tomó una decisión?
La demo enseña la respuesta correcta.
Producción enseña timeouts, datos atrasados, permisos incoherentes, cambios de esquema y usuarios que preguntan justo aquello que nunca probamos.
Mediría el sistema completo
No me quedaría con una métrica de precisión. Mantendría un cuadro de control más pequeño y más útil:
| Dimensión | Pregunta operativa | Ejemplo de señal |
|---|---|---|
| Calidad del dato | ¿La entrada sigue siendo fiable? | completitud, duplicados, frescura |
| Calidad de la respuesta | ¿Cumple el criterio acordado? | tasa de éxito por tarea, errores críticos |
| Seguridad | ¿Actúa dentro de sus permisos? | denegaciones, intentos fuera de alcance |
| Operación | ¿Podemos mantener el servicio? | latencia, coste, disponibilidad, reintentos |
| Supervisión | ¿Cuándo necesita intervenir una persona? | escalados, correcciones, anulaciones |
| Impacto | ¿Mejora realmente la decisión? | tiempo ahorrado, errores evitados, adopción |
Seis preguntas antes de añadir IA a un proceso
No empezaría catalogando todos los datos de la organización ni desplegando una plataforma transversal. Empezaría por una experiencia crítica y respondería seis preguntas.
- ¿Qué decisión queremos mejorar? Si no existe una decisión concreta, probablemente estamos construyendo una demostración.
- ¿Qué datos cambian esa decisión? No todos los datos disponibles son necesarios ni adecuados.
- ¿Qué significa cada dato? Hay que acordar semántica, origen, propietario y vigencia.
- ¿Qué ocurre cuando el sistema se equivoca? El coste del error determina el nivel de automatización y revisión.
- ¿Qué puede hacer la IA y con qué permisos? Consultar, recomendar y ejecutar son niveles distintos.
- ¿Cómo sabremos que sigue funcionando? Deben existir evaluación, observabilidad, responsables y una vía de retirada.
Este marco no elimina la incertidumbre. Hace que sea visible antes de convertirla en deuda técnica o en un problema para el usuario.
Lo que no ha cambiado en estos tres años
Sigo creyendo que los datos pueden revelar patrones que una organización no ve y que la inteligencia artificial puede reducir una enorme cantidad de trabajo repetitivo.
También sigo defendiendo el valor de construir. Aquel TFM no habría enseñado lo mismo como ejercicio teórico. Tuve que enfrentarme a direcciones incompletas, fuentes que no encajaban, colas de procesamiento, errores de clasificación y personas que necesitaban respuestas sencillas, no una explicación del stack.
Lo que ha cambiado es mi definición de éxito.
En 2023 podía sentir que un proyecto estaba terminado cuando el pipeline procesaba los datos y el mapa mostraba el resultado.
En 2026 necesito algo más:
- que el significado sobreviva al viaje entre sistemas;
- que un error se pueda detectar y explicar;
- que la automatización tenga límites;
- que el resultado cambie una decisión real;
- que siga habiendo alguien responsable.
La IA ha abaratado la generación de respuestas, código y contenido. Eso es importante. Pero cada respuesta adicional aumenta la necesidad de seleccionar, verificar y mantener.
Por eso mi visión sobre los datos y la inteligencia artificial se ha vuelto menos espectacular y más exigente.
Ya no me impresiona tanto que un sistema responda.
Me interesa saber por qué puedo confiar en él, qué hará si se equivoca y quién conserva la capacidad de decir que no.
Un modelo puede generar una respuesta. Un sistema bien diseñado debe conservar el contexto, limitar la acción y asumir la responsabilidad.
Una pregunta para continuar la conversación
Si estás incorporando IA a un producto o a un proceso, prueba a apartar el modelo durante diez minutos y revisar las seis preguntas anteriores.
¿Cuál es la más difícil de responder en tu caso: la calidad del dato, la evaluación, los permisos o la responsabilidad final?
Puedes compartir tu experiencia conmigo en LinkedIn o seguir mis artículos sobre arquitectura, datos e IA aplicada.
Preguntas frecuentes
¿Por qué la calidad de datos sigue siendo importante con modelos más avanzados?
Porque un modelo puede interpretar mejor una entrada sin corregir su origen, vigencia o significado. Si el dato identifica mal a la persona, el recurso o el momento, la respuesta puede ser coherente y seguir siendo falsa.
¿Qué diferencia hay entre evaluar un modelo y evaluar un sistema de IA?
Evaluar el modelo mide capacidades como exactitud o calidad de generación. Evaluar el sistema incluye además datos, recuperación de contexto, permisos, herramientas, validaciones, latencia, coste, intervención humana e impacto sobre la decisión real.
¿Cuándo debería una IA actuar sin confirmación humana?
Cuando la operación sea de bajo impacto, esté bien acotada, sea observable y preferiblemente reversible. Cuanto mayor sea el efecto sobre derechos, identidad, calificaciones, dinero o acceso, mayor debe ser el control previo y posterior.
¿Hace falta implantar un programa completo de gobernanza antes de empezar?
No. Se puede empezar por una experiencia crítica, definir sus datos, responsables, permisos, métricas y tratamiento del error. Ese alcance pequeño permite aprender sin convertir la gobernanza en un macroproyecto.
Deja una respuesta